Gemini 4 Hydrogen vs. Claude Sonnet 5.5 vs. GPT-6.1 Terra
13 Min. Lesezeit

Gemini 4 Hydrogen liegt nicht überall vorn. In Googles eigener Tabelle steht es in 7 von 10 Zeilen auf Platz 1, doch ein genauerer Blick auf diese Tabelle und auf die unabhängigen Messungen zeigt Folgendes:
- Bei Terminal-Bench 4.1 erreicht Claude Sonnet 5.5 63,9 %, Hydrogen 57,0 %.
- Bei OSWorld-2.1, das die Computerbedienung misst, erreicht Sonnet 5.5 83,9 %, Hydrogen 77,6 %.
- Auch im eigenen Terminal-Bench-Lauf von Artificial Analysis liegt Hydrogen (etwa 54 %) hinter Sonnet 5.5 (64 %).
- Im Index von Artificial Analysis hängt die Reihenfolge von der Denkstufe ab: Hydrogen erreicht in der Standardeinstellung 51, Sonnet 5.5 in der höchsten Einstellung 55.
- Für GPT-6.1 Terra habe ich keine unabhängige Indexzeile gefunden; alle Zahlen dazu stammen hier aus Googles Tabelle.
Zum Modell selbst lesen Sie am besten zuerst Was ist Gemini 4 Hydrogen?. Kostenlose Nutzung und Zugang stehen in einem eigenen Artikel, die Seite des Konkurrenten im Artikel zu Claude Sonnet 5.5.
Dieser Artikel ist ein Nachrichten- und Recherchetext; ich habe das Modell nicht getestet und die drei Modelle auch nicht nebeneinander an denselben Aufgaben laufen lassen. Die Zahlen stammen aus Googles Ankündigung vom 12. November 2026, von der Modellseite von Google DeepMind, von Artificial Analysis und von Nachrichtenseiten. Die Quellen stehen am Ende.
Nebeneinander: Googles eigener Vergleich
Google vergleicht Hydrogen mit Claude Sonnet 5.5 und GPT-6.1 Terra. Die Tabelle in der Ankündigung ist ein Bild; die Werte unten habe ich der Texttabelle auf der Modellseite von Google DeepMind entnommen (veröffentlicht mit dem Hinweis „Stand November 2026“).
| Messung | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep (Fehler finden und beheben, ohne bestehenden Code zu beschädigen) | 13,5 % | 3,1 % | 5,8 % |
| Terminal-Bench 4.1 (um Schummeln bereinigt) | 57,0 % | 63,9 % | nicht angegeben |
| Agents' Last Exam v1.1 (berufliche Abläufe von Anfang bis Ende) | 71,6 % | 60,4 % | 69,8 % |
| AutomationBench-AA | 76,1 % | 71,8 % | 60,2 % |
| Vending-Bench 2 (Kontostand) | 14.549 $ | 11.165 $ | 9.107 $ |
| OSWorld-2.1 (Offline-Teilmenge, Computerbedienung) | 77,6 % | 83,9 % | 74,2 % |
| MKA (Multimodal Knowledge Agent) | 53,4 % | 52,0 % | 43,8 % |
| Chartography | 66,6 % | 61,6 % | 63,2 % |
| Terminal-Bench-Science 0.1 | 51,4 % | 59,9 % | 58,3 % |
| HLE-Diamond | 58,8 % | 53,3 % | 47,3 % |
Hydrogen führt in 7 der 10 Zeilen. Sonnet 5.5 führt in drei: Terminal-Bench 4.1, OSWorld-2.1 und Terminal-Bench-Science. Terra liegt in keiner Zeile vorn; bei Terminal-Bench-Science steht es vor Hydrogen, bei Agents' Last Exam liegt es weniger als zwei Punkte dahinter.
Beim Lesen der Tabelle sollten Sie vier Dinge beachten:
- Der Hersteller hat die Messungen ausgewählt. Das ist die Tabelle, die Google zur Vorstellung von Hydrogen erstellt hat. Gut ist, dass die drei Zeilen, in denen es zurückliegt, enthalten sind; welche Messungen in die Tabelle kamen, hat aber Google entschieden.
- Die meisten Konkurrenzwerte sind keine eigenen Läufe von Google. Laut Googles Dokument zur Bewertungsmethodik sind die Ergebnisse von Hydrogen Werte eines einzelnen Versuchs (pass@1) über die Gemini API, sofern nicht anders vermerkt mit der höchsten Denkstufe. Die Zahlen der Modelle anderer Anbieter stammen, sofern nicht anders vermerkt, aus Herstellerangaben; für Sonnet 5.5 und Terra nutzt Google das Ergebnis mit der maximalen Denkstufe oder, wenn es fehlt, das beste verfügbare Ergebnis.
- Herkunft Zeile für Zeile. Bei SWE-sweep, Terminal-Bench 4.1 und Terminal-Bench-Science hat Google Hydrogen selbst laufen lassen und die Zahlen der Konkurrenz aus den offiziellen Bestenlisten übernommen. AutomationBench-AA und HLE-Diamond stammen aus der Bestenliste von Artificial Analysis, Vending-Bench 2 aus der von Andon Labs. Bei Agents' Last Exam hat Google Hydrogen und Sonnet 5.5 selbst laufen lassen, Terra stammt aus der Bestenliste. Bei Chartography hat Google Hydrogen und Terra selbst laufen lassen, Sonnet 5.5 stammt aus der System Card. Bei MKA ist Hydrogen Googles Lauf, die übrigen Werte kommen von Artificial Analysis.
- In zwei Zeilen sind die Bedingungen nicht gleich. Bei Terminal-Bench 4.1 lief Hydrogen auf der Stufe
high(nicht auf xhigh, der höchsten) und als Durchschnitt aus fünf Versuchen pro Aufgabe. Bei OSWorld-2.1 wurde für Hydrogen und Sonnet 5.5 der beste von drei Läufen genommen, der Wert von Terra stammt aus der System Card. Das sind zwei der Zeilen, in denen Sonnet 5.5 vorn liegt. Wie Sie unten sehen, verändert die Denkstufe das Ergebnis stark. - Die Terminal-Bench-Version ist eine andere. Diese Tabelle nutzt Terminal-Bench 4.1 (um Schummeln bereinigt). Die Tabelle im Carbon-Vergleich nutzte Terminal-Bench 4.0 (Carbon 65,2 %, Argon 57,1 %). Setzen Sie die Zahlen beider Versionen nicht in eine Spalte.
- Bei SWE-sweep sind alle niedrig. Hydrogens 13,5 % sind ein Mehrfaches der Konkurrenzwerte, absolut gesehen löst aber keines der drei Modelle den Großteil der Aufgaben.
Unabhängige Messungen: Die Denkstufe verändert alles
Artificial Analysis misst Modelle getrennt nach Denkstufe. Die Werte auf der Seite zum Intelligence Index v5.0.1 (geprüft am 14. November 2026):
| Modell (Denkstufe) | Index | Kosten pro Indexaufgabe | Zeit pro Aufgabe |
|---|---|---|---|
| Hydrogen xhigh | 54 | 3,16 $ | 14,1 Min. |
| Hydrogen high (Standard) | 51 | 1,87 $ | 7,8 Min. |
| Hydrogen medium | 41 | 0,80 $ | 3,7 Min. |
| Hydrogen low | 27 | 0,29 $ | 1,3 Min. |
| Claude Sonnet 5.5 max | 55 | 10,02 $ | 34,0 Min. |
| Claude Sonnet 5.5 xhigh | 50 | 4,09 $ | 14,6 Min. |
| Claude Sonnet 5.5 high | 42 | 1,64 $ | 6,8 Min. |
| GPT-6.1 Sol max | 55 | 1,27 $ | k. A. |
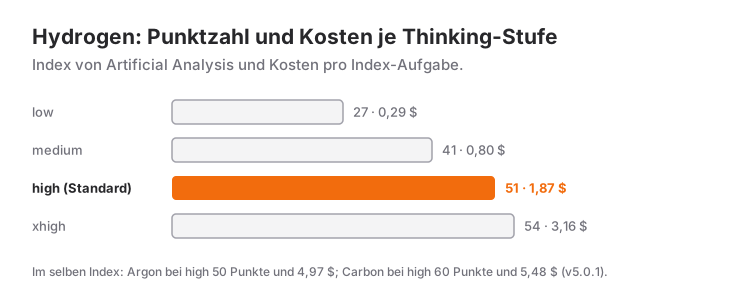
Was diese Tabelle zeigt:
- Auf derselben Stufe liegt Hydrogen vorn. Bei high erreicht Hydrogen 51, Sonnet 5.5 42. Die Kosten pro Aufgabe liegen nah beieinander (1,87 $ und 1,64 $).
- In der höchsten Einstellung liegt Sonnet 5.5 einen Punkt vorn. Sonnet 5.5 max erreicht 55, Hydrogen xhigh 54. Sonnet kommt dorthin aber mit 10,02 $ pro Aufgabe, etwa dem Dreifachen von Hydrogens 3,16 $.
- Ähnlicher Wert, andere Rechnung. Hydrogen high (51) und Sonnet 5.5 xhigh (50) liegen fast gleichauf. Hydrogen schafft das mit weniger als den halben Kosten und in etwa der halben Zeit.
- Die Standardstufe von Hydrogen zu senken kostet viel Qualität. Von high auf medium fällt der Wert von 51 auf 41, bei low auf 27. Wenn Sie die Stufe senken, um zu sparen, nutzen Sie praktisch ein anderes Modell.
- Eine Terra-Zeile gibt es nicht. Bei Artificial Analysis habe ich keine Zeile für GPT-6.1 Terra gefunden. Das OpenAI-Modell in dieser Tabelle ist GPT-6.1 Sol; in Googles Tabelle steht Terra. Das sind verschiedene Modelle; setzen Sie die Zahl des einen nicht an die Stelle des anderen.
Bei der Terminal-Arbeit zeigen die unabhängigen Daten in dieselbe Richtung wie Googles Tabelle. Wie DataCamp berichtet, erreicht Hydrogen im eigenen Terminal-Bench-4.0-Lauf von Artificial Analysis etwa 54 % (BenchLM führt 53,5 %), Claude Sonnet 5.5 64 % und GPT-6.1 Sol 56 %. DataCamps Fazit: Hydrogen sei für terminallastige Arbeit nicht das beste verfügbare Modell.
Wo steht Hydrogen innerhalb der Gemini-4-Familie?
Auf derselben Seite von Artificial Analysis erreicht Gemini 4 Carbon auf der Stufe high 60 Punkte, Hydrogen 51 und Gemini 4 Argon 50.
| Modell (high) | Index | Kosten pro Indexaufgabe | Zeit pro Aufgabe |
|---|---|---|---|
| Gemini 4 Carbon | 60 | 5,48 $ | 29,0 Min. |
| Gemini 4 Hydrogen | 51 | 1,87 $ | 7,8 Min. |
| Gemini 4 Argon | 50 | 4,97 $ | 30,0 Min. |
Hydrogen liegt also im selben Punktebereich wie Argon, ist pro Aufgabe aber deutlich günstiger und schneller. Carbon liegt neun Punkte vorn und verlangt dafür etwa die dreifachen Kosten pro Aufgabe. (Die von NeuralTrust wiedergegebenen Kosten pro Aufgabe in meinem Carbon-Vergleich waren höher; die Werte hier stehen auf der aktuellen v5.0.1-Seite des Index.)
Googles eigene Tabellen zeigen ein ähnliches Bild, doch die Tabellen zu Hydrogen und Carbon sind getrennte Tabellen; lesen Sie jede für sich. Bei Agents' Last Exam v1.1 erreicht Carbon 77,4 %, Hydrogen 71,6 % und Argon 69,0 %. Bei OSWorld-2.1 Carbon 81,5 %, Hydrogen 77,6 %, Argon 74,7 %. Bei Chartography liegt Hydrogen (66,6 %) hinter Carbon (72,5 %) und Argon (71,6 %). Das einzige Gegenbeispiel ist SWE-sweep: Hydrogen 13,5 %, Carbon 9,6 %. Carbons Vergleich mit seinen eigenen Konkurrenten steht in einem eigenen Artikel.
Halluzination, Tempo und Wortreichtum
Halluzinationsrate. Nach den AA-Omniscience-Werten, die BenchLM unter Berufung auf Artificial Analysis nennt, liegt Hydrogens Halluzinationsrate bei 8,5 % und die Genauigkeit bei 50,5 % (DataCamp schreibt die Rate als „8 %“). Diese Rate gibt an, wie oft das Modell falsch antwortet, statt zu sagen, dass es etwas nicht weiß; niedriger ist besser. Neben den Werten aus meinen früheren Artikeln liegt Hydrogen zwischen Argon (4 %) und Carbon (11 %). Für Sonnet 5.5 und Terra habe ich aus dieser Messung keinen Wert. Google sagt seinerseits, erfundene Behauptungen seien gegenüber Gemini 3.8 Flash um mehr als das Fünffache zurückgegangen; das ist Googles eigene Messung, und der Vergleich gilt dem älteren Flash-Modell, nicht der Konkurrenz.
Tempo. Die Modellseite von Artificial Analysis zeigt bei xhigh 182 Ausgabetokens pro Sekunde. Die Zeit bis zum ersten Antworttoken beträgt bei xhigh 42,9 Sekunden, bei high 16,3 Sekunden. Die Seite beschreibt das Modell pro Aufgabe als langsamer als der Durchschnitt. Googles Aussage, das Modell erledige Aufgaben in der Standardstufe high 2,5-mal schneller als Gemini 3.8 Flash, ist eine eigene Messung; die Methode wurde nicht veröffentlicht.
Wortreichtum. Hydrogen hat für den Index bei xhigh 304 Millionen Ausgabetokens gebraucht; der Median liegt bei 77,3 Millionen. Artificial Analysis nennt das „sehr wortreich“. Der Preis pro Token ist niedrig, die Zahl der verbrauchten Tokens aber hoch; deshalb lohnt der Blick auf die Tabelle mit den Kosten pro Aufgabe.
Preis
| Modell | Eingabe (1 Mio. Tokens) | Ausgabe (1 Mio. Tokens) | Quelle |
|---|---|---|---|
| Gemini 4 Hydrogen (Standard) | 1,50 $ | 7,50 $ | Googles Preisseite |
| Gemini 4 Hydrogen (Batch / Flex) | 0,75 $ | 3,75 $ | Googles Preisseite |
| Claude Sonnet 5.5 | 2 $ | 10 $ | Liste Dritter |
| GPT-6.1 Terra | 1 $ | 5 $ | Liste Dritter |
| GPT-6.1 Sol | 2 $ | 10 $ | Liste Dritter |
| Gemini 4 Argon und Carbon | 2 $ (ab 1. Dezember 4 $) | 10 $ (ab 1. Dezember 20 $) | Googles Preisseite |
Die Hydrogen-Preise habe ich am 14. November 2026 auf Googles Preisseite geprüft. Hydrogen hat außerdem eine kostenlose API-Stufe mit Ratenbegrenzung; Argon und Carbon haben keine. Die Preise für Claude und GPT stammen aus Listen Dritter, ich habe sie nicht auf den Seiten der Anbieter überprüft; sehen Sie vor einer Entscheidung auf der offiziellen Seite nach.
Nach Listenpreis ist Terra am günstigsten, dann Hydrogen. Bei Hydrogen werden aber auch Denktokens zum Ausgabepreis abgerechnet, und Modelle verbrauchen für dieselbe Arbeit unterschiedlich viele Tokens. Der Listenpreis allein reicht deshalb nicht; die Kosten pro Aufgabe oben sind das realistischere Maß.
Welches Modell wann?
Dieser Teil ist meine Deutung: allgemeine Schlüsse, die ich aus den Zahlen oben ziehe.
- Kostenlos anfangen oder kleines Budget: Hydrogen. Es hat eine kostenlose API-Stufe und in der Standardeinstellung niedrige Kosten pro Aufgabe.
- Agenten, die im Terminal arbeiten: Sonnet 5.5. Googles Tabelle und der Lauf von Artificial Analysis sagen dasselbe.
- Computerbedienung (OSWorld): Sonnet 5.5.
- Abläufe von Anfang bis Ende und Automatisierung: In Googles Tabelle liegt Hydrogen vorn (Agents' Last Exam, AutomationBench-AA), eine unabhängige Bestätigung für diese Zeilen habe ich aber nicht gesehen.
- Diagramme und multimodale Fragen: Hydrogen mit knappem Vorsprung (Chartography, MKA).
- Wenn Sie den höchsten Wert brauchen: Sehen Sie eine Klasse höher statt auf diese drei. Zwischen Sonnet 5.5 max und Hydrogen xhigh liegt ein Punkt; Carbon steht bei 60.
- GPT-6.1 Terra: der niedrigste Listenpreis und bei Agents' Last Exam nah an Hydrogen. Weil ich keine unabhängigen Indexdaten gefunden habe, kann ich nicht mehr dazu sagen.
Wie man Benchmarks liest
- Eine Herstellertabelle ist die Auswahl des Herstellers. Tempo, Wortreichtum und Halluzinationsrate stehen nicht in Googles Tabelle, sondern auf den Seiten Dritter.
- Fragen Sie nach der Denkstufe. „Hydrogen erreichte 51“ sagt erst etwas, wenn „bei high“ dabeisteht. Prüfen Sie, ob die beiden verglichenen Modelle auf derselben Stufe laufen.
- Das Agenten-Framework verändert das Ergebnis. Dasselbe Modell erzielt mit anderen Werkzeugen andere Werte. Das habe ich im Artikel dazu, was ein Harness ist, erklärt.
- Messen Sie Ihre eigene Aufgabe. Fünf eigene Aufgaben lehren mehr als fünfzig fremde.
Wo die Modelle eine Klasse höher bei ähnlichen Messungen stehen, sehen Sie im Vergleich zu Claude Fable 5.2.
Häufig gestellte Fragen
Ist Gemini 4 Hydrogen besser als Claude Sonnet 5.5?
Das hängt von der Art der Arbeit ab. In Googles Tabelle führt Hydrogen in 7 von 10 Zeilen; bei Terminal-Arbeit und Computerbedienung führt Sonnet 5.5. Im Index von Artificial Analysis liegt Hydrogen auf derselben Denkstufe vorn, in der höchsten Einstellung liegt Sonnet 5.5 einen Punkt vorn.
Ist Hydrogen besser als GPT-6.1 Terra?
In Googles Tabelle führt Hydrogen in acht der neun Zeilen, für die ein Terra-Wert vorliegt; Terra liegt nur bei Terminal-Bench-Science vor Hydrogen. Eine unabhängige Zeile für Terra habe ich bei Artificial Analysis nicht gefunden, der Vergleich stützt sich also auf eine einzige Quelle.
Welches Modell ist besser zum Programmieren?
Für Agenten, die Befehle im Terminal ausführen, sprechen die Messungen für Sonnet 5.5. Bei SWE-sweep, das das Beheben von Fehlern ohne Beschädigung bestehenden Codes misst, führt Hydrogen, doch die absoluten Werte dort sind niedrig. Entscheiden Sie nicht, bevor Sie es an Ihrer eigenen Codebasis ausprobiert haben.
Welches Modell ist günstiger?
Nach Listenpreis: Terra (1 $ / 5 $, Liste Dritter), dann Hydrogen (1,50 $ / 7,50 $), dann Sonnet 5.5 (2 $ / 10 $, Liste Dritter). Bei den Kosten pro Aufgabe von Artificial Analysis liegt Hydrogen high bei 1,87 $ und Sonnet 5.5 high bei 1,64 $; in den oberen Einstellungen ist Sonnet deutlich teurer.
Halluziniert Hydrogen häufiger?
Bei AA-Omniscience liegt die Halluzinationsrate bei 8,5 %: höher als bei Argon (4 %), niedriger als bei Carbon (11 %). Für Sonnet 5.5 und Terra habe ich aus derselben Messung keinen Wert.
Warum ist die Denkstufe so wichtig?
Weil dasselbe Modell je nach Stufe sehr unterschiedlich abschneidet: Hydrogen erreicht bei low 27, bei high 51 und bei xhigh 54. Kosten und Zeit steigen mit der Stufe ebenfalls.
Quellen
- Google DeepMind, Gemini 4 Hydrogen: Model evaluation (November 2026): wie die Werte von Hydrogen und der Konkurrenz je Benchmark ermittelt wurden.
- Google, Introducing Gemini 4 Hydrogen (12. November 2026): Vergleichstabelle (Bild), Aussagen zu Tempo und erfundenen Behauptungen.
- Google DeepMind, Seite der Gemini-Modelle: Textfassung der Benchmark-Tabelle, Werte für Carbon und Argon aus derselben Familie.
- Google DeepMind, Model Card zu Gemini 4 Hydrogen: Benchmark-Werte.
- Google, Preise der Gemini API: Preise für Hydrogen, Argon und Carbon, kostenlose Stufe (geprüft am 14. November 2026).
- Artificial Analysis, Gemini 4 Hydrogen: Tempo, Zeit bis zum ersten Token, verbrauchte Ausgabetokens.
- Artificial Analysis, Modell-Rangliste: Index nach Denkstufe, Kosten und Zeit pro Aufgabe.
- DataCamp, Gemini 4 Hydrogen (13. November 2026): Terminal-Bench-4.0-Lauf von Artificial Analysis, Halluzinationsrate.
- BenchLM, Gemini 4 Hydrogen (13. November 2026): Halluzinationsrate und Genauigkeit bei AA-Omniscience, Terminal-Bench-Wert.
Verwandte Artikel
Gemini 4 Hydrogen im Test: 4 Thinking-Stufen, 1 Aufgabe
Dieselbe Coding-Aufgabe für Gemini 4 Hydrogen auf vier Thinking-Stufen: Alle vier lösten sie. Die Zeit stieg von 14 auf 198 Sekunden, die Tokens aufs 14-Fache.
Was ist Gemini 4 Hydrogen? Funktionen, Preis, Benchmarks
Google hat Gemini 4 Hydrogen am 12. November 2026 für alle geöffnet: 1 Million Tokens Kontext, 1,50 $ Eingabepreis und eine kostenlose API-Stufe. Der Überblick.
Was ist Antigravity Orchestrator? Carbon plant, Hydrogen baut
Orchestrator in Antigravity plant mit Carbon oder Argon und schreibt den Code mit Hydrogen. Laut Google 24 % weniger Kontingent, 19 % schneller; Ultra und Pro.