Was ist ein Harness? Der Unterschied zwischen Modell und Coding-Tool (am Beispiel DeepSeek)
Zuletzt aktualisiert:
13 Min. Lesezeit
Stell dir folgende Situation vor: Du probierst DeepSeek im Browser aus, und es weiß alles, was du fragst. Dann bindest du dasselbe Modell in deinen Editor ein, und es schneidet deutlich schlechter ab. Ist das Modell schlecht, oder machst du etwas falsch?
Höchstwahrscheinlich weder noch. Der Unterschied kommt vom Harness. Wenn wir über Vibe Coding reden, vergleichen wir ständig Modelle – „ist Claude besser, GPT oder DeepSeek" – aber ein erheblicher Teil der Ausgabequalität liegt gar nicht im Modell, sondern in der Schicht, die darum herum gewickelt ist. In diesem Artikel geht es darum, was ein Harness ist, was er tatsächlich tut, und warum sich dasselbe Modell in zwei Werkzeugen wie zwei verschiedene Entwickler verhält.
Ausgangspunkt ist das Video DeepSeek Harness = Claude Code for $0 von Jack Roberts, das den quelloffenen Harness von DeepSeek vorstellt. Dieser Artikel fasst es zusammen und erweitert es; der Agent-Loop Schritt für Schritt, die Fragen zur Harness-Wahl und die Sicherheitshinweise sind Ergänzungen dieses Beitrags.
Was ist ein Modell? Was ist ein Harness?
Ein Modell ist erstaunlich simpel: Du gibst Text hinein, du bekommst Text heraus. Das war's. DeepSeek, Claude, GPT – alle passen in diese Definition. Das Modell hat kein Gedächtnis, sieht deine Dateien nicht, kann kein Terminal ausführen, erinnert sich nicht an das vorherige Gespräch. Stell es dir als eine einzelne Funktion vor:
antwort = modell(text)Ein Harness ist das Programm, das um diese Funktion herum geschrieben ist. Claude Code, Cursor, Codex CLI, Cline, Continue, opencode – alles Harnesses. Der Code, der das Modell aufruft, entscheidet, was hineingeht, die Anweisungen aus der Antwort ausführt und das Ergebnis wieder zurückspielt.
Der Vergleich im Video ist kurz: Das Modell ist das Gehirn, der Harness der Körper. Etwas ausführlicher: Das Modell ist ein exzellenter Entwickler, der in einem abgeschlossenen Raum ohne Fenster sitzt. Keine Augen, keine Hände, kein Gedächtnis. Du schiebst ein Blatt Papier hinein, er schreibt die Antwort darauf, er schiebt es zurück. Der Harness ist die Person an der Tür: Sie entscheidet, welches Blatt hineingeht, was darauf steht, und welche Datei sie aufgrund der Antwort öffnet und zurückträgt.
Gib einem exzellenten Entwickler ein leeres Blatt, und du bekommst keine gute Antwort. Das liegt nicht am Entwickler.
Die fünf Aufgaben eines Harness
Wenn du ein Coding-Tool öffnest, passieren im Hintergrund fünf Dinge. Keines davon ist Aufgabe des Modells.
1. System-Prompt und Regeln
Der Harness setzt seine eigenen Anweisungen vor deinen Satz: „Du bist ein Coding-Assistent, du kannst diese Werkzeuge nutzen, du musst eine Datei lesen, bevor du sie schreibst, halte dich an den Codestil des Nutzers." Dateien im Projektwurzelverzeichnis – CLAUDE.md, .cursorrules, AGENTS.md – landen ebenfalls hier.
Diese Schicht erklärt, warum dasselbe Modell dir in einem Werkzeug den einen Kommentarstil liefert und im anderen einen anderen.
2. Tool-Definitionen
Das Modell kann keine Datei von sich aus lesen. Der Harness übergibt ihm eine Liste: read_file, write_file, run_command, search. Das Modell antwortet dann: „Ich möchte jetzt read_file("api/session.php") aufrufen." Das ist eine Anfrage, keine Aktion.
Den Aufruf macht der Harness. Er liest die Datei, nimmt den Inhalt, hängt ihn an die nächste Nachricht und schickt ihn ans Modell zurück.
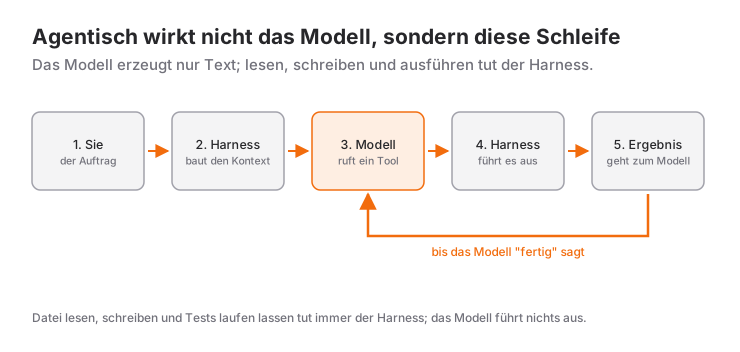
3. Der Agent-Loop
Das ist das Herzstück. Ein Harness macht keine einzelne Frage-Antwort-Runde, sondern dreht eine Schleife:
- Schicke die Anfrage des Nutzers ans Modell.
- Will das Modell ein Tool aufrufen, rufe es auf.
- Hänge das Ergebnis des Tools an die Konversation an.
- Schicke sie wieder ans Modell.
- Gehe zu 2, bis das Modell „fertig" sagt oder ein Limit erreicht ist.
Genau diese Schleife ist der Unterschied zwischen DeepSeek im Chatfenster und DeepSeek in einem Agenten. Der Chat gibt dir eine Runde; ein Agent nimmt sich vielleicht dreißig.
4. Kontextverwaltung
Das Modell liest in jeder Runde die gesamte Historie neu, und jedes Modell hat ein Kontextlimit. Eine Sitzung mit dreißig Runden sprengt dieses Limit locker. Hier entscheidet der Harness: Welche Datei geht vollständig hinein, welche wird zusammengefasst, welcher alte Schritt fliegt raus, wann wird die Konversation komprimiert.
Hier trennen sich gute und schlechte Harnesses am deutlichsten. Dasselbe Modell – aber einer gibt ihm die drei relevanten Dateien, der andere dreißig irrelevante. Der zweite ist teurer und schlechter zugleich.
5. Freigabe und Sicherheitsgrenze
Wenn das Modell sagt „führe diesen Befehl aus", fragt der Harness dich vorher, oder macht er es einfach? Aus welchem Verzeichnis darf er nicht heraus? Diese Entscheidungen gehören dem Harness, nicht dem Modell.
Anatomie einer Runde: ein DeepSeek-Beispiel
Machen wir es konkret. Du hast DeepSeek in ein Agenten-Tool eingebunden und getippt:
„Korrigiere in
api/session.phpdie Dauerberechnung so, dass sie der serverseitigen Differenz vertraut statt dem Wert vom Client."
Grob, was im Hintergrund passiert:
Runde 1 – Der Harness schickt ans Modell: System-Prompt + Tool-Liste + Projektregeln + deinen Satz. Das Modell antwortet: „Ich muss zuerst die Datei lesen: read_file("api/session.php")."
Runde 2 – Der Harness liest die Datei, hängt 200 Zeilen an die Konversation, schickt sie zurück. Diesmal sagt das Modell: „Zeile 41 nutzt $_POST['duration'] direkt. Hier ist die Änderung, die ich vorschlage: write_file(...)."
Runde 3 – Je nach Einstellung fragt der Harness dich um Freigabe oder schreibt direkt. Er meldet das Ergebnis ans Modell. Das Modell: „Lass uns die Tests laufen lassen: run_command("php tests/session_test.php")."
Runde 4 – Die Testausgabe geht ans Modell zurück. Ist sie rot, korrigiert das Modell und die Schleife läuft weiter. Ist sie grün, sagt das Modell „fertig" und die Schleife schließt.
In diesen vier Runden hat das Modell nur eines getan: Text erzeugt. Die Datei lesen, schreiben, den Test ausführen, die Ausgabe zurücktragen – alles Harness. Was sich wie ein Agent anfühlt, ist nicht das Modell, sondern die Schleife.
Warum sich dasselbe Modell in verschiedenen Werkzeugen anders verhält
Jetzt ist die Antwort klar. Was sich ändert, wenn du dasselbe Modell in zwei Werkzeugen laufen lässt:
- Der System-Prompt. Einer sagt „lies, bevor du schreibst", der andere nicht.
- Das Tool-Set. Einer hat
run_command, der andere nicht. Ein Agent, der keine Tests ausführen kann, kann nicht überprüfen, ob der Code läuft. - Die Kontextauswahl. Einer indiziert das Projekt und findet die drei relevanten Dateien; der andere schickt nur den offenen Tab.
- Das Rundenlimit. Einer erlaubt dreißig Runden, der andere bricht nach fünf ab.
- Das Fehler-Feedback. Einer gibt den Compilerfehler ans Modell zurück; der andere zeigt ihn dir und hört auf.
Das ist die typische Ursache für das „im Browser gut, im Editor schlecht" aus der Einleitung: Schickt die Erweiterung nur die gerade geöffnete Datei, muss das Modell über eine Codebasis raten, die es nicht sehen kann.
Welchen Platz DeepSeek in diesem Bild hat
Ich habe DeepSeek als Beispiel gewählt, weil es die Harness-Frage sichtbarer macht als andere. Ein geschlossenes Modell kommt meist mit dem Werkzeug seines Herstellers – Modell und Harness stammen aus derselben Quelle und sind aufeinander abgestimmt. Bei DeepSeek lassen sich Modell und Harness unabhängig voneinander wählen.
Auf der einen Seite hat DeepSeek inzwischen einen eigenen Harness. Im August 2026 hat das Unternehmen DeepSeek Harness (kurz dsh) unter der MIT-Lizenz als Open Source veröffentlicht. Das Projekt ist noch eine Developer Preview, und im Repository steht ausdrücklich, dass inkompatible Änderungen kommen werden. Die Architektur folgt dem Prinzip „alles ist ein Plugin“: Modelladapter, Tool-Registry, Sitzungsprotokoll und sogar der Agent-Loop selbst sind austauschbare Teile. Im Video läuft er auf dem lokalen Rechner und wechselt in derselben Oberfläche zwischen DeepSeek-, Claude- und GPT-Modellen; laut Video lassen sich über Ollama auch lokale Modelle anbinden, ein Claude-Code- oder Codex-Abo funktioniert dagegen nicht, nur API-Schlüssel.
Auf der anderen Seite laufen DeepSeeks Modelle auch in anderen Harnesses. Die API folgt der OpenAI-Form, also lässt sie sich in fast jedes Agenten-Tool einbinden, das einen „OpenAI-kompatiblen Endpoint" akzeptiert: Basis-URL und Key ändern, fertig. Modelle, die mit offenen Gewichten veröffentlicht werden, kannst du bei ausreichender Hardware auch auf deinem eigenen Server betreiben.
Diese Freiheit ist zugleich die Flexibilität und die Falle:
- Chat-Modell oder Reasoning-Modell? DeepSeeks Modellfamilie umfasst sowohl Chat-Modelle, die direkt antworten, als auch Reasoning-Modi, die Schritt für Schritt denken. Reasoning-Modelle planen in der Regel besser, sind aber langsamer und teurer, und in manchen Versionen ist ihre Tool-Calling-Unterstützung weniger ausgereift als beim Chat-Modell. Bevor du eines in einem Agenten einsetzt: teste Tool-Calling zuerst mit einer trivialen Aufgabe.
- Die Tool-Calling-Qualität entscheidet. In einem Agenten ist die eine kritische Fähigkeit eines Modells, Tools im richtigen Format und in der richtigen Reihenfolge aufzurufen. Ein Modell mit brillanten Chat-Antworten ist als Agent nutzlos, wenn es das Tool-Call-Format nicht trifft.
- Günstig zu sein verzeiht keinen verschwenderischen Harness. DeepSeeks Preisvorteil ist real, aber ein schlechter Harness gibt ihn über eine Schleife mit dreißig Runden wieder ab. Günstiges Modell plus verschwenderischer Harness kann teurer werden als teures Modell plus sparsamer Harness.
- Die Versionen bewegen sich schnell. Modellnamen und Fähigkeiten werden alle paar Monate aktualisiert; prüfe in der offiziellen Dokumentation, was dein gewähltes Modell unterstützt. Der Mechanismus in diesem Artikel ist stabil – die Modellliste nicht.
Solltest du deinen eigenen Harness schreiben?
Die nackteste Version eines Agent-Loops sind wirklich etwa hundert Zeilen: eine while-Schleife, eine Tool-Liste, ein JSON-Parser. Zum Lernen: schreib ihn mindestens einmal – kein Artikel über Harnesses lehrt so viel wie die eigene Schleife.
Aber bau das Werkzeug, das du täglich nutzt, nicht von Grund auf. Der Wert bestehender Werkzeuge liegt nicht in der Schleife, sondern in allem drumherum: Kontextkompaktierung, Projektindizierung, Diff-Anzeige, Undo, Berechtigungssystem, Absturzwiederherstellung. Das sind Monate an Arbeit.
Fünf Fragen bei der Wahl eines Harness
Wenn du ein neues Coding-Tool bewertest, schau nicht auf den Modellnamen. Schau auf das hier:
- Welche Werkzeuge gibt es dem Modell? Dateien lesen reicht nicht; Befehle und Tests ausführen zählt genauso.
- Wie wählt es den Kontext? Nur die offene Datei, ein Projektindex, oder kann ich Dateien von Hand anhängen?
- Was passiert in einer langen Sitzung? Wenn der Kontext voll ist – vergisst es still, fasst es zusammen, oder sagt es mir Bescheid?
- Kann ich das Modell tauschen? Kann ich meinen eigenen API-Key und mein eigenes Modell einbinden? (Unverzichtbar, wenn du etwas wie DeepSeek testen willst.)
- Wofür fragt es um Erlaubnis? Fragt es vor dem Schreiben von Dateien und dem Ausführen von Befehlen, oder entscheidet es allein?
Die Antworten auf diese fünf machen mehr aus als die Frage, welches Modell darunter steckt.
Ist das günstige Modell wirklich günstiger?
Du wirst oft hören: „fast die gleiche Leistung zu einem Bruchteil des Preises“; auch das Video argumentiert, DeepSeek liefere 90 bis 95 Prozent der Leistung zu einem Bruchteil der Kosten, räumt aber ein, dass es eine Stufe unter Opus und GPT-5.6 liegt. Nimm solche Aussagen nicht als gegeben hin — miss es an deiner eigenen Arbeit. Das geht schnell:
- Wähle fünf repräsentative Aufgaben — echte Arbeit, keine konstruierten Beispiele.
- Lass dieselben fünf Aufgaben in beiden Setups laufen.
- Notiere drei Dinge: verbrauchte Tokens, ob das Ergebnis brauchbar war, und wie lange du mit dem Nachbessern verbracht hast.
Der dritte Punkt entscheidet. Ein günstiges Modell, das doppelt so viele Tokens verbraucht und dir eine halbe Stunde Korrektur beschert, ist nicht günstig. Eine realistische Erwartung: Bei routinierter, klar beschriebener Arbeit reicht das günstige Modell oft aus; bei vager Arbeit, die Urteilsvermögen verlangt, kann der Unterschied zu einem Zeitverlust werden, der die Tokenkosten deutlich übersteigt.
Lege dich deshalb nicht auf ein Setup fest, sondern teile die Arbeit auf: das starke Modell dort, wo die schwierigen Entscheidungen fallen, das günstige dort, wo das Volumen liegt. Das Video zieht eine ähnliche Linie: Claude Code oder Codex, wenn die Ausgabe an Kunden geht und die Designqualität zählt; den DeepSeek-Harness als „Arbeitspferd“ für Arbeit mit hohem Volumen, bei der die Kosten entscheiden.
Deinen API-Schlüssel an einen fremden Harness geben
Ein quelloffener Harness läuft auf deinem eigenen Rechner und seine Telemetrie ist womöglich standardmäßig aus (laut Video ist das beim DeepSeek-Harness der Fall) — trotzdem gibst du ihm deinen API-Schlüssel, deine Codebasis und manchmal Zugriff auf externe Dienste. Vier Dinge vor der Einrichtung:
- Nimm einen separaten API-Schlüssel mit Ausgabenlimit, nicht den deines Hauptkontos.
- Halte den Schlüssel in einer Umgebungsvariablen, niemals in einer Projektdatei.
- Sieh dir beim ersten Lauf den Netzwerkverkehr an und überzeuge dich selbst davon, dass die Telemetrie wirklich aus ist.
- Starte mit eingeschränkter automatischer Befehlsausführung und erweitere sie, wenn du das Werkzeug kennst.
Das ist keine Paranoia, sondern die übliche Sorgfalt bei jedem fremden Entwicklerwerkzeug.
Was das für Vibe Coding bedeutet
In meinen Vibe-Coding-Artikeln sage ich immer dasselbe: Die Entscheidungen gehören dir, die Umsetzung dem Modell. Der Harness ist das dritte Bein dieses Satzes – wie deine Entscheidungen tatsächlich beim Modell ankommen. Dein Entscheidungsdokument kann perfekt sein; schickt der Harness es nie mit, bedeutet es nichts.
Bevor du also in die Debatte „welches Modell ist besser" einsteigst, frag lieber: Was gebe ich meinem Modell, und was mache ich mit seiner Antwort? Sobald das klar ist, wird die Modellwahl einfach.
Welches Werkzeug bei welcher Aufgabe hervorsticht, steht in Vibe-Coding-Werkzeuge im Vergleich; zur Methode selbst gibt es 7 praktische Tipps.
Häufig gestellte Fragen
Was bedeutet Harness bei KI?
Ein Harness ist die Softwareschicht, die um ein KI-Modell herum geschrieben wird und es zu einem nutzbaren Werkzeug macht. Sie baut den System-Prompt, stellt dem Modell Werkzeuge bereit (Dateien lesen, Befehle ausführen), führt die vom Modell angeforderten Aufrufe aus und spielt die Ergebnisse zurück. Claude Code, Cursor und Cline sind Beispiele für Harnesses.
Was ist der Unterschied zwischen Modell und Harness?
Ein Modell ist nur eine Funktion, die Text entgegennimmt und Text zurückgibt; es hat kein Gedächtnis, keinen Dateizugriff und keine Handlungsfähigkeit. Ein Harness ist das Programm, das diese Funktion in einer Schleife ausführt, ihr Kontext liefert und die Tool-Aufrufe aus ihrer Antwort tatsächlich ausführt. Agentenverhalten kommt aus der Schleife, nicht aus dem Modell.
Kann ich DeepSeek in meinem eigenen Coding-Tool nutzen?
Ja. DeepSeeks API folgt der OpenAI-Form und funktioniert daher in den meisten Agenten-Tools, in denen du Basis-URL und Key selbst setzen kannst. Außerdem hat DeepSeek einen eigenen quelloffenen Harness, der allerdings noch eine Developer Preview ist. Prüfe vorher, ob das gewählte Modell Function Calling unterstützt.
Warum liefern zwei Werkzeuge mit demselben Modell unterschiedliche Ergebnisse?
Weil das Modell gleich ist, seine Eingabe aber nicht. System-Prompt, Tool-Set, mitgeschickte Dateien, Rundenlimit und Fehler-Feedback unterscheiden sich von Werkzeug zu Werkzeug. Ein Werkzeug, das dem Modell die drei relevanten Dateien gibt, bekommt eine ganz andere Qualität als eines, das nur den offenen Tab schickt.
Was ist ein Agent-Loop?
Es ist der Ablauf, in dem der Harness das Modell wiederholt statt einmal aufruft: Anfrage schicken, das gewünschte Tool ausführen, das Ergebnis anhängen, erneut schicken. Die Schleife läuft, bis das Modell „fertig" sagt. Genau deshalb fühlt sich ein Werkzeug an, als würde es „von allein arbeiten".
Muss ich meinen eigenen Harness schreiben?
Für die tägliche Arbeit nicht; der Wert bestehender Werkzeuge liegt in Kontextverwaltung und Berechtigungen, nicht in der Schleife. Zum Lernen empfehle ich aber, einmal eine einfache Schleife zu schreiben – etwa hundert Zeilen, und sie macht das Thema klarer als jede Menge Lesestoff.
Quelle
- Jack Roberts, DeepSeek Harness = Claude Code for $0 (YouTube, August 2026). Die Unterscheidung zwischen Modell und Harness, die Funktionen des DeepSeek-Harness und die Empfehlung, welches Setup sich für welche Arbeit eignet, beruhen auf diesem Video.
- deepseek-ai/deepseek-harness (GitHub): das offizielle Repository zu Lizenz, Status als Developer Preview und Installation.
- The Open-Sourcing of DeepSeek Harness (InfoQ, August 2026): eine Zusammenfassung der Plugin-Architektur.
Verwandte Artikel
Programmieren mit kostenloser KI: opencode und günstige Modelle
Eigenen Schlüssel ins quelloffene opencode stecken und kostenlose oder centgünstige Modelle nutzen: Einrichtung, Provider und was „kostenlos“ kostet.
JEV ins System einbauen: Harness, Kosten und bekannte Grenzen
Allein liefert JEV nur Wahrscheinlichkeiten. So bauen Sie den Harness, der daraus Handlung macht, welche Architekturmuster helfen und wo das Modell schwach ist.
Was ist Claude Sonnet 5.5? Benchmarks, Kosten, Gratis-Plan
Claude Sonnet 5.5 ist das Standardmodell im Gratis-Plan. 70,6 % bei Terminal-Bench 4.0, 2 $ / 10 $ pro Million Tokens. Der Vergleich mit Opus 5.5.