Claude Fable 5.2 im Vergleich: Opus 5.5, Astra, Carbon
10 Min. Lesezeit

In Anthropics Tabelle vom 9. November 2026 führt Claude Fable 5.2 bei 10 der 11 gezeigten Benchmarks vor Claude Opus 5.5, GPT-6 Astra und Gemini 4 Carbon. Die einzige Ausnahme ist AutomationBench: Gemini 4 Carbon erreicht dort 53,9 %, Fable 5.2 51,4 %. Die gesamte Tabelle stammt von Anthropic; eine unabhängige Reproduktion gibt es nicht.
Dieser Artikel ist ein Nachrichten- und Recherchetext; ich habe die Modelle nicht getestet. Die Zahlen stammen aus der Tabelle auf Anthropics Ankündigungsseite. Auch die Zahlen der Konkurrenzmodelle stammen aus Anthropics Tabelle und nicht aus Messungen Dritter. Eine Einführung in das Modell bietet Was ist Claude Fable 5.2, die Preisunterschiede stehen in Preis und Kosten.
Die kurze Antwort
Fable 5.2 hat bei den von Anthropic gewählten Benchmarks die höchsten Werte. Die größten Abstände gibt es bei WANDR (82,1 %, Opus 5.5 72,3 %), beim Remote Labor Index (41,3 %, Opus 5.5 21,3 %, ungefähr das Doppelte) und bei RoboDojo Sim (64,9 %, Opus 5.5 39,4 %). Der kleinste Abstand liegt bei Chartography: Fable 5.2 73,4 %, Gemini 4 Carbon 72,5 %, GPT-6 Astra 71,0 %. Bei AutomationBench führt Carbon, in der unbeschrifteten Elo-Zeile unter AA-Briefcase Opus 5.5.
Anthropics Tabelle
Spalten: Claude Fable 5.2, Fable 5.1, Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon. „-“ bedeutet, dass Anthropic die Zelle nicht zeigt. Die Werte gelten, sofern nicht anders angegeben, beim höchsten verfügbaren Effort des jeweiligen Modells.
| Messung | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (agentisches Programmieren) | 49,1 % (Xhigh) | 32,4 % (Xhigh) | 45,5 % | 42,8 % | 41,1 % (Medium) |
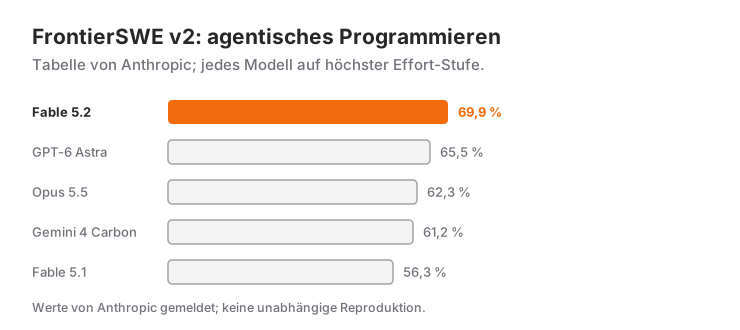
| FrontierSWE v2 (agentisches Programmieren) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench (Arbeitsabläufe) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| Terminal-Bench-Science 0.1 (wissenschaftliche Forschung) | 74,6 % | 52,6 % | 58,7 % | 68,1 % | 64,8 % |
| OSWorld 2.1 (Computernutzung, Offline-Teilmenge) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| RoboDojo Sim (Robotik; interner Lauf von Anthropic) | 64,9 % | 27,6 % | 39,4 % | 29,8 % | - |
| AA-Briefcase v1.1 (Wissensarbeit, Rubrik) | 66,1 % | 61,5 % | 61,2 % | 52,0 % | 61,8 % |
| Remote Labor Index (High-Effort) | 41,3 % | 17,9 % | 21,3 % | 20,8 % | - |
| Humanity's Last Exam (mit Werkzeugen) | 74,2 % | 65,6 % | 67,7 % | 57,2 % | - |
| Chartography (Diagrammverständnis, ohne Werkzeuge) | 73,4 % | 44,8 % | 64,4 % | 71,0 % | 72,5 % |
| WANDR (agentische Suche, relaxed score) | 82,1 % | 68,7 % | 72,3 % | - | - |
Zwei weitere Zeilen außerhalb der Tabelle: Unter AA-Briefcase steht eine unbeschriftete Elo-Zeile (Fable 5.2 1785, Fable 5.1 1669, Opus 5.5 1800, GPT-6 Astra 1569, Gemini 4 Carbon 1611). Bei BenchCAD 2.1 (Hardware-Engineering, mit Werkzeugen, Teilpunkte von 0 bis 100, Max-Effort) erreichte Fable 5.2 83,5, Opus 5.5 65,3 und Fable 5.1 44,4.
Programmieren und agentische Aufgaben
Fable 5.2 führt bei beiden Benchmarks für agentisches Programmieren, aber die Abstände sind einstellig. Bei FrontierCode 2.0 erreicht es mit Xhigh-Effort 49,1 % (Opus 5.5 45,5 %, Astra 42,8 %, Carbon 41,1 % bei Medium). Bei FrontierSWE v2 sind es 69,9 %, mit GPT-6 Astra auf Platz zwei bei 65,5 %. Anthropic sagt außerdem, bei FrontierCode 2.0 erreiche Fable 5.2 mit High-Effort 45,3 % und liege damit gleichauf mit dem besten Ergebnis von Opus 5.5 (45,5 %), aber bei etwa der Hälfte der Kosten pro Aufgabe (Einzelheiten im Preisartikel).
Hinweis: Carbons Wert bei FrontierCode 2.0 wird in der Tabelle mit Medium-Effort gezeigt, nicht auf derselben Effort-Stufe wie Fables Xhigh. Der Grund ist nicht genannt; deshalb wäre es nicht richtig, diese beiden Zahlen eins zu eins zu vergleichen.
AutomationBench (Arbeitsabläufe) ist eine andere Geschichte: Fable 5.2 hat gegenüber Fable 5.1 einen großen Sprung gemacht (31,4 % auf 51,4 %), doch Carbon führt mit 53,9 %. Bei Terminal-Bench-Science 0.1 erreicht Fable 5.2 74,6 %, Astra ist mit 68,1 % Zweiter.
Wer einen Praxisvergleich der Werkzeuge sucht, also wie sich Claude, ChatGPT, Cursor und Codex bei echter Arbeit schlagen, findet im Vergleich der Vibe-Coding-Werkzeuge eine Betrachtung der Nutzung statt der Benchmarks.
Computernutzung, Bildverstehen und Robotik
Bei der Computernutzung ist der Abstand klein, in der Robotik groß. In der Offline-Teilmenge von OSWorld 2.1 erreicht Fable 5.2 89,3 %, Opus 5.5 87,2 %, Carbon 81,5 % und Astra 79,5 %: 2,1 Punkte Abstand zum nächsten Konkurrenten.
Das Diagrammverständnis (Chartography, ohne Werkzeuge) liegt fast gleichauf: Fable 5.2 73,4 %, Carbon 72,5 %, Astra 71,0 %, Opus 5.5 64,4 %.
In der Robotik erreicht Fable 5.2 bei RoboDojo Sim 64,9 %; Opus 5.5 39,4 %, Astra 29,8 %, Fable 5.1 27,6 %. Das ist Anthropics interner Lauf; Anthropic sagt, es sei mehr als das Doppelte von Astra und Fable 5.1. Gemini 4 Argon, das nur in diesem Diagramm auftaucht, kam auf 34,2 %. Carbon wird in dieser Zeile nicht gezeigt.
Wissensarbeit und Schlussfolgern
Bei Wissensarbeit und Schlussfolgern führt Fable 5.2 mit einer Ausnahme. Bei AA-Briefcase v1.1 (Rubrik) erreicht es 66,1 %; Carbon 61,8 %, Opus 5.5 61,2 %. Bei Humanity's Last Exam mit Werkzeugen sind es 74,2 % (Opus 5.5 67,7 %, Astra 57,2 %). Beim Remote Labor Index mit High-Effort erreicht es 41,3 %, Opus 5.5 21,3 %, Astra 20,8 %. Bei WANDR sind es 82,1 %, Opus 5.5 72,3 %; Astra und Carbon werden in dieser Zeile nicht gezeigt.
Wo Fable 5.2 nicht vorn liegt
Drei Punkte:
- AutomationBench. Gemini 4 Carbon 53,9 %, Fable 5.2 51,4 %. Das ist die einzige Messung der Tabelle, bei der Fable 5.2 zurückliegt.
- Die unbeschriftete Elo-Zeile unter AA-Briefcase. Opus 5.5 1800, Fable 5.2 1785. Die Beschriftung dieser Zeile fehlt in Anthropics Tabelle; ich konnte deshalb nicht überprüfen, was sie misst, und deute sie nicht.
- Die Nähe bei Chartography. Fable 5.2 73,4 %; Carbon 72,5 % und Astra 71,0 % verringern den Abstand auf 1 bis 2 Punkte. Hier von „gewonnen“ zu sprechen, ginge über die Messgenauigkeit hinaus.
Die Fußnote sagt außerdem, dass die Schutzmechanismen nur bei Fable 5.2, Fable 5.1 und Opus 5.5 aktiv waren; für GPT-6 Astra und Gemini 4 Carbon wird keine Bedingung genannt.
Wie man diese Tabelle liest
- Die Tabelle stammt vom Hersteller. Die Messungen hat Anthropic ausgewählt. Einen Hinweis auf eine Auswahl zugunsten des eigenen Modells habe ich nicht, aber als Außenstehender kann ich ihn auch nicht ausschließen.
- Die Bedingungen der Konkurrenzwerte sind unklar. Die Fußnoten nennen weder Quelle noch Bedingungen der Werte von GPT-6 Astra und Gemini 4 Carbon. In der Google-Tabelle, wie ich sie in meinem Carbon-Artikel wiedergegeben habe, erreicht GPT-6 Astra bei FrontierSWE 2 65,5 % und Carbon 61,2 %, und bei OSWorld-2.1 Opus 5.5 87,2 % und Carbon 81,5 %; diese vier Zahlen stimmen mit Anthropics Tabelle überein. Zumindest in diesen Zeilen nennen beide Hersteller also dieselben Werte (ich zitiere meinen eigenen Artikel und habe Googles Seite nicht erneut geprüft).
- Bei CyScenarioBench beruht der Wert jedes Labors auf eigenen Aufgaben. Diese Zeilen lassen sich nicht direkt vergleichen.
- Keine unabhängige Messung. Ein Ergebnis zu Fable 5.2 von Artificial Analysis oder einem anderen Dritten habe ich nicht gelesen. Auch die System Card habe ich nicht gelesen.
- Benchmarks in anderen Artikeln sind andere Läufe. Vermischen Sie Werte wie Terminal-Bench 4.0 oder OSWorld 2.1 mit 80,1 % aus meinen anderen Artikeln nicht mit dieser Tabelle: andere Versionen und Läufe. Die Zahlen im Vergleich von Gemini 4 Carbon, Argon, Opus 5.5 und Astra gehören beispielsweise zu ihren eigenen Quellen.
- Mythos 5.2 ist eine eigene Linie. Das Modell ohne Schutzmechanismen erreicht bei Terminal-Bench-Science 75,3 % (neben den 74,6 % von Fable 5.2) und bei den Cyber-Messungen 89,6 % bei CVE Rediscovery; das sind nicht die Zeilen von Fable. Mythos ist für den allgemeinen Zugang gesperrt.
Welches Modell für welche Aufgabe
Das lässt sich aus der Benchmark-Tabelle ableiten, aber entscheiden Sie nicht, bevor Sie an Ihrer eigenen Arbeit gemessen haben:
| Aufgabe | Hinweis in der Tabelle |
|---|---|
| Schweres, langwieriges agentisches Programmieren | Fable 5.2 hat die höchsten Werte (FrontierCode 2.0, FrontierSWE v2) |
| Workflow-Automatisierung | Carbon führt bei AutomationBench; Fable 5.2 ist Zweiter |
| Computernutzung | Fable 5.2 vorn, Opus 5.5 nah dran |
| Diagramm- und Bildverstehen | Fable 5.2, Carbon und Astra sehr nah beieinander |
| Robotik, Suche, wissenschaftliche Forschung | Fable 5.2 deutlich vorn |
| Preis zuerst | Opus 5.5 kostet pro Token die Hälfte (4 $ / 20 $), aber die Kosten pro Aufgabe hängen von der Arbeit ab |
Die neuen Arbeiten, die Fable 5.2 geleistet haben soll (1.000 Agenten, Fermat, Physik), stehen im Artikel darüber, was das Modell kann. Zum Zugang siehe den Artikel darüber, wer es nutzen kann.
Häufig gestellte Fragen
Ist Claude Fable 5.2 besser als Opus 5.5?
Bei allen 11 Benchmarks in Anthropics Tabelle liegt Fable 5.2 vor Opus 5.5. Nur in der unbeschrifteten Elo-Zeile unter AA-Briefcase liegt Opus 5.5 (1800) vor Fable 5.2 (1785). Die Tabelle stammt von Anthropic; eine unabhängige Überprüfung gibt es nicht.
(Hinweis: Diese Elo-Zeile habe ich nicht zu den Benchmarks gezählt, weil Anthropic sie ohne Beschriftung zeigt.)
Ist Fable 5.2 besser als GPT-6 Astra?
In der Tabelle erreicht Fable 5.2 bei jeder Messung, in der beide gezeigt werden, einen höheren Wert als Astra. Die engste Zeile ist Chartography: 73,4 % gegen 71,0 %. Die Bedingungen von Astras Werten nennen Anthropics Fußnoten nicht.
Schlägt Gemini 4 Carbon Fable 5.2?
Bei AutomationBench ja: 53,9 % gegen 51,4 %. Bei Chartography erreicht Fable 5.2 73,4 % und Carbon 72,5 %. In den meisten anderen Zeilen liegt Fable 5.2 vorn.
Wo hat Fable 5.2 den größten Vorsprung?
Gegenüber Opus 5.5 sind es bei WANDR 82,1 % gegen 72,3 %, beim Remote Labor Index 41,3 % gegen 21,3 % und bei RoboDojo Sim 64,9 % gegen 39,4 %. RoboDojo ist Anthropics interner Lauf.
Ist Fable 5.2 das beste Programmiermodell?
Bei den beiden Benchmarks für agentisches Programmieren in Anthropics Tabelle (FrontierCode 2.0, FrontierSWE v2) hat Fable 5.2 den höchsten Wert. Die Abstände betragen 3,6 und 4,4 Punkte. Einen unabhängigen Coding-Vergleich habe ich nicht gelesen; probieren Sie es an Ihrer eigenen Codebasis aus, bevor Sie „das beste“ sagen.
Kann ich diesen Benchmark-Ergebnissen trauen?
Die Zahlen sind Anthropics eigene Angaben; eine Reproduktion durch Dritte gibt es nicht. Quelle und Bedingungen der Konkurrenzwerte sind nicht genannt. Machen Sie einen kleinen Test an Ihrer eigenen Arbeit, bevor Sie entscheiden.
Warum fehlt Sonnet 5.5 in dieser Tabelle?
Anthropics Tabelle zu Fable 5.2 enthält Sonnet 5.5 nicht. Zu Sonnet 5.5 siehe den eigenen Artikel; einen gemeinsamen Lauf, mit dem ich dessen Benchmarks mit dieser Tabelle zusammenführen könnte, gibt es nicht.
Quellen
- Anthropic, Claude Fable 5.2 and Claude Mythos 5.2 (9. November 2026; Änderungshinweis am 11. November ergänzt): Benchmark-Tabelle, Fußnoten, RoboDojo- und Mythos-Zeilen, Kostendiagramme.
- Anthropic, Claude-Fable-Produktseite: Vergleich mit Fable 5.1, Modellzeitleiste.
- Anthropic, Models overview: Claude Fable 5.2: Modelleigenschaften, Preise und der Vergleich mit Opus 5.5 und Sonnet 5.5.
- Anthropic, What's new in Claude Fable 5.2: Hinweise zu Effort und Verhalten.
Verwandte Artikel
Was ist Claude Fable 5.2? Preis, Mythos, Zugang
Anthropic hat Claude Fable 5.2 am 9. November 2026 veröffentlicht: 1 Mio. Kontext, 8 $ Eingabe und 40 $ Ausgabe je Million Tokens, 20 % günstiger als Fable 5.1.
Claude Fable 5.2 Preis: 8 $ / 40 $ und Effort-Stufen
Claude Fable 5.2 kostet 8 $ Eingabe und 40 $ Ausgabe je Million Tokens. Wie Caching, Batch, Fast Mode und Effort die Kosten ändern, mit Rechenbeispiel.
Gemini 4 Carbon vs. Argon vs. Opus 5.5 vs. GPT-6 Astra
Gemini 4 Carbon führt den Index, aber nicht überall: Opus 5.5 liegt bei Agenten-Coding vorn, Astra bei FrontierSWE, und die Fehlerquote ist höher als bei Argon.