Was ist JEV? Die Reflexschicht der KI (TypeSafes System-One-Modell)
8 Min. Lesezeit
Wenn Sie eine heiße Oberfläche berühren, denken Sie nicht nach. Sie schließen nicht: „Das sind vermutlich 70 Grad, das Risiko einer Verbrennung ist hoch, ich sollte die Hand wegziehen" — die Hand ist längst weg. Das Denken kommt danach.
Genau diese Schicht hat in KI-Systemen gefehlt. Fragen Sie ein LLM „ist dieser Kommentar Spam?", dann denkt das Modell, formt Sätze, schreibt eine Begründung — dabei wollten Sie nur ein einziges Bit. Kosten und Latenz entstehen aus diesem überflüssigen Denken.
TypeSafes JEV füllt exakt diese Lücke. In diesem Artikel erkläre ich, was JEV ist, was es nicht ist, wie es arbeitet und was seine Preis- und Limit-Tabelle praktisch bedeutet.
Was ist JEV?
JEV ist das Flaggschiffmodell von TypeSafe AI und das erste Mitglied der Familie, die das Unternehmen System One nennt. Zum Zeitpunkt dieses Artikels ist jev-1.13.0 die aktuelle Version; die Aliase jev-latest und jev-preview verweisen auf sie.
Die Arbeitsweise unterscheidet sich von den Modellen, die Sie kennen. Sie geben JEV einen Zustand (state) und eine oder mehrere typisierte Fragen — und bekommen keinen Text zurück, sondern eine strukturierte Antwort, die Ihr Code direkt verwenden kann:
- Choice — „welche dieser Optionen?" Sie erhalten eine Option, eine Wahrscheinlichkeit pro Option und einen Konfidenzwert. Eine Choice-Frage erlaubt bis zu 255 Optionen.
- Score — „wo auf der beschriebenen Skala liegt das?" Sie geben geordnete Stufen vor (mindestens 2, höchstens 10) und bekommen Stufe, Wahrscheinlichkeitsverteilung und Konfidenz.
- Noul — „ist diese Aussage wahr?" Sie erhalten eine einzelne Wahrscheinlichkeit zwischen 0 und 1.
Das ist die gesamte Oberfläche. JEV schreibt keine Antworten, erzeugt keinen Code und erklärt seine Begründung nicht. Es entscheidet.
System One und System Two
Der Name stammt aus Kahnemans Zwei-Systeme-Modell des Denkens. System 1 ist schnell, intuitiv, automatisch; System 2 ist langsam, anstrengend, bewusst.
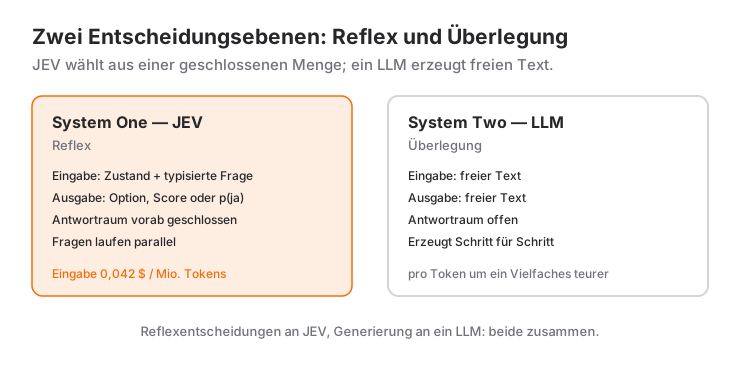
Heutige LLMs stehen auf der System-2-Seite: Sie planen, denken Schritt für Schritt, erzeugen Text. Genau das macht sie stark. Aber der weit überwiegende Teil der Entscheidungen einer Software ist keine System-2-Arbeit:
- Ist diese E-Mail eine Rechnung, ein Sponsoring-Angebot oder Spam?
- Muss der Agent diese Datei wirklich lesen?
- Lässt sich diese Anfrage mit einer Datenbankabfrage lösen, oder gehört sie zu einem Menschen?
Das sind Reflexentscheidungen. Ein LLM liefert die richtige Antwort, aber Sie bezahlen unnötig dafür. Die Dokumentation von TypeSafe zieht die Grenze deutlich: System-One-Modelle „treffen schnelle, strukturierte Entscheidungen für Software" und „schreiben keine Antworten, erzeugen keinen Code und erklären ihre Schlussfolgerungen nicht".
Es lohnt sich, das zusammen mit dem Begriff Harness zu lesen: Das Modell ist eine Funktion, das System darum herum bauen Sie. JEV ist der Extremfall dieses Satzes — ohne Maschinerie drumherum ist es zu nichts zu gebrauchen.
Was JEV nicht tut
Am schnellsten versteht man ein Werkzeug über seine Grenzen. JEV:
- Erzeugt keinen Text. Die Dokumentation ist eindeutig: Dafür ist es nicht trainiert. Man kann es über verkettete Choices erzwingen, aber „das funktioniert nicht gut und ist sehr langsam".
- Führt keine Unterhaltung. Kein Gesprächsverlauf, keine Rolle, keine Assistenten-Persona. Jeder Aufruf ist eine eigenständige Bewertung.
- Ruft keine Tools auf. Es liest keine Datei, ruft keine API, führt keinen Befehl aus. Es kann entscheiden, welches Tool aufgerufen werden soll; den Aufruf macht Ihr Code.
- Nimmt keine Bilder, Audio oder Video. Nur Text.
- Zählt nicht, vergleicht keine Daten, rechnet nicht. Das gehört in Ihren Code — Details dazu in Grenzen und Harness.
Diese Liste liest sich wie eine Sammlung von Einschränkungen, aber genau darin liegt der Wert: Weil der Antwortraum vorab definiert ist, muss die Ausgabe nicht geparst werden. Kein „ich erwarte JSON und bekomme kaputtes JSON" mehr, kein „antworte nur mit ja oder nein" mit drei Absätzen Erklärung.
Der erste Aufruf
Die einfachste Form mit dem Python-SDK:
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient()  # liest die Umgebungsvariable TYPESAFE_API_KEY

response = client.system_one(
    state="Mein Paket ist seit 9 Tagen unterwegs und niemand antwortet. Ich will mein Geld zurück.",
    questions={
        "erstattung": Noul(instructions="Fordert die Kundin oder der Kunde eine Rückerstattung?"),
    },
)

print(response.answers["erstattung"].noul)  # z. B. 0.97
Installation über pip install typesafe-sdk, der Schlüssel wird aus TYPESAFE_API_KEY gelesen. Auf HTTP-Ebene gibt es einen einzigen Endpunkt:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
Beachten Sie, was response.answers["erstattung"].noul ist: kein Text, eine Zahl. Eine Zahl, gegen die Sie ein if schreiben können. Dieser Satz ist der ganze Punkt von JEV.
Die drei Fragetypen, die Regeln für gute Kriterien und das Lesen des Konfidenzwerts behandle ich in Choice, Score und Noul.
Dutzende Fragen in einem Aufruf
Das ist die zweite Eigenschaft, die JEV von gewohnten Modellen trennt: Alle Fragen einer Anfrage werden parallel ausgewertet. Laut Dokumentation verändert eine zusätzliche Frage die Antwortzeit kaum und kostet nur die Tokens dieser Frage.
In einem veröffentlichten Beispiel von TypeSafe ist eine Auswertung mit 13 Fragen in einem einzigen Aufruf rund 12-mal günstiger und 10-mal schneller als 13 getrennte Aufrufe — bei unveränderten Antworten.
Das dreht die Gewohnheit um: Fragen zu stellen, die Sie vielleicht brauchen, ist jetzt rational. Welche Antwort Sie verwenden, entscheidet Ihr Code später. Die Dokumentation nennt das speculative fan-out.
Preis, Kontext und Limits
| Wert | |
|---|---|
| Modell | jev-1.13.0 (jev-latest, jev-preview) |
| Eingabepreis | 0,042 US-Dollar pro Million Tokens |
| Ausgabepreis | kostenlos |
| Kontext | 64k Tokens pro Anfrage insgesamt |
| Zustand | 32k Tokens für state plus längste Frage |
| Ratenlimits | 250.000 Tokens/Sekunde, 1.200 Anfragen/Minute |
| Eingabetyp | nur Text |
Die auffällige Zeile ist der Preis. Rund vier Cent pro Million Eingabe-Tokens, Ausgabe kostenlos. Eine Last mit Tausenden kurzer Klassifikationen, die über ein LLM eine ernsthafte Rechnung erzeugt, landet mit JEV im Centbereich.
In einem öffentlichen Vergleich kostete derselbe Klassifikationstest auf einem großen Reasoning-Modell 176 Dollar und mit JEV 39 Cent. Nehmen Sie die Zahlen nicht wörtlich — messen Sie auf Ihrer eigenen Last — aber die Größenordnung stimmt: Es geht nicht um zehn Prozent Ersparnis, sondern um zwei bis drei Zehnerpotenzen.
Ein Hinweis zur Sprache: Die Dokumentation nennt Englisch als primäre Trainingssprache mit der besten Genauigkeit. Deutsch funktioniert ebenfalls; wenn Sie aber etwas Kritisches bauen, vergleichen Sie messend die Variante, Fragen auf Englisch zu schreiben und den Zustand in der Originalsprache zu lassen.
Wo es hilft und wo nicht
Es hilft bei Klassifikation, Routing, Moderation, Priorisierung, Filterung, Re-Ranking und bei Torentscheidungen der Art „ist dieser Schritt nötig?" — überall dort, wo die Antwort aus einer geschlossenen Menge kommt.
Es hilft nicht beim Schreiben, Programmieren, Zusammenfassen, Übersetzen oder Erklären. Das bleibt LLM-Arbeit. JEV ersetzt kein LLM; es steht davor. Es wird zur günstigen Schicht, die entscheidet, welches Modell mit welchem Kontext wann läuft.
Das passende mentale Modell sind Ihre eigenen if-Blöcke. Wo sich eine Regel schreiben lässt, genügt das if bereits. Das Problem sind die Stellen, an denen sich keine Regel schreiben lässt — „ist dieser Kommentar aggressiv", „ist diese Mail dringend" — und Sie mit Stichwortlisten Pseudoregeln erfinden. JEV ist das intelligente if für genau diese Lücke.
Wie man anfängt
pip install typesafe-sdkund die UmgebungsvariableTYPESAFE_API_KEY.- Nehmen Sie 50–100 echte Beispiele aus Ihrem eigenen Produkt. Testen Sie nicht mit synthetischen; JEVs Schwachstellen zeigen sich gerade in den unordentlichen Teilen echter Daten.
- Labeln Sie von Hand, fragen Sie JEV, vergleichen Sie. Nicht ausliefern, bevor Sie gemessen haben.
- Wenn Sie mit einem Coding-Agenten arbeiten, installieren Sie den offiziellen Skill von TypeSafe:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Das ist ein Agent Skill; er bringt dem Agenten API, Fragetypen und Architekturmuster bei, sodass Sie sagen können: „Finde die Stellen im Projekt, an denen fragiler Parsing-Code durch eine intelligente Entscheidung ersetzt werden kann."
Fazit
Interessant an JEV ist nicht rohe Intelligenz, sondern dass es die fehlende Schicht um Modelle herum schließt. Bisher lief jede Entscheidung, von der billigsten bis zur kritischsten, durch dieselbe teure Denkmaschinerie. Reflex und Überlegung zu trennen, verändert Kosten, Latenz und Architektur gleichzeitig.
Es ist aber keine Lösung aus der Schachtel. JEV liefert Ihnen eine Wolke aus Wahrscheinlichkeiten; die Maschine, die daraus Handlung macht, bauen Sie. Die eigentliche Arbeit liegt also nicht im Modell, sondern im System darum herum.
Weiterlesen: Choice, Score und Noul, 10 Anwendungsfälle und Harness, Kosten und Grenzen.
Die technischen Werte stammen aus der offiziellen Dokumentation von TypeSafe und können sich mit der Version ändern; prüfen Sie sie vor dem Produktiveinsatz.
Häufig gestellte Fragen
Was ist JEV?
JEV ist das erste Mitglied der Modellfamilie, die TypeSafe AI „System One" nennt. Statt Text zu erzeugen, liefert es strukturierte Entscheidungen: Sie geben einen Zustand und typisierte Fragen, Sie erhalten eine Option, eine Skalenstufe oder eine Ja/Nein-Wahrscheinlichkeit. Es ist kein Chatmodell, sondern eine Entscheidungsschicht in Ihrem Code.
Ist JEV ein LLM?
Nein. Ein LLM erzeugt Text, JEV nicht. Seine Antworten kommen aus einer geschlossenen Menge, die Sie vorher definieren (Option, Skalenstufe oder Wahrscheinlichkeit zwischen 0 und 1). Deshalb ersetzt JEV kein LLM, sondern steht als günstige Schicht davor.
Was kostet JEV?
Laut Dokumentation kosten Eingabe-Tokens 0,042 US-Dollar pro Million, Ausgabe ist kostenlos. Für Klassifikations- und Routing-Lasten liegt das zwei bis drei Zehnerpotenzen unter derselben Arbeit mit einem Chatmodell.
Funktioniert JEV auf Deutsch?
Ja, allerdings nennt die Dokumentation Englisch als primäre Trainingssprache mit der besten Genauigkeit. Ein sinnvoller Startpunkt ist, Anweisungen und Kriterien auf Englisch zu schreiben und den zu bewertenden Text in seiner Originalsprache zu lassen — messen Sie beide Varianten an Ihren eigenen Daten.
Lassen sich JEV und ein LLM kombinieren?
Das ist die vorgesehene Nutzung. JEV trifft die günstige, schnelle Entscheidung (welcher Agent, welches Tool, welche Priorität, ist dieser Schritt nötig), das LLM erledigt die Arbeit, die wirklich Generierung braucht. Das teure Modell läuft dann nur bei Bedarf und mit dem richtigen Kontext.
Was brauche ich, um JEV einzusetzen?
Einen API-Schlüssel, das Paket typesafe-sdk und den Code drumherum. Letzteres ist entscheidend: JEV ist kein Produkt, sondern eine Entscheidungsmaschine. Ohne den Ablauf, der die Entscheidung umsetzt, halten Sie nur eine Liste von Wahrscheinlichkeiten in der Hand.
Verwandte Artikel
JEV-Anwendungsfälle: 10 reale Szenarien und ihre Kosten
Von Kommentarmoderation über Tool-Auswahl für Agenten bis zu Modell-Routing und RAG-Filterung: zehn Szenarien, in denen JEV sich wirklich lohnt — mit Code und Kostenvergleich.
JEV ins System einbauen: Harness, Kosten und bekannte Grenzen
Allein liefert JEV nur eine Wolke aus Wahrscheinlichkeiten. So bauen Sie den Harness, der daraus Handlung macht, welche Architekturmuster helfen und wo das Modell schwach ist.
JEV-Fragetypen: Choice, Score und Noul richtig einsetzen
Die drei Fragetypen von JEV, die Regeln für gute Kriterien, der Unterschied zwischen Wahrscheinlichkeit und Konfidenz und warum Dutzende Fragen in einen Aufruf gehören.