JEV ins System einbauen: Harness, Kosten und bekannte Grenzen
9 Min. Lesezeit
Der meistwiederholte Satz über JEV lautet: „Ohne ein System drumherum ist es nutzlos." Das ist keine Übertreibung, sondern die Definition. JEV gibt Ihnen keine Handlung, sondern eine Wolke aus Wahrscheinlichkeiten. Die Maschine, die daraus eine Entscheidung und aus der Entscheidung eine Handlung macht, schreiben Sie.
Im Harness-Artikel habe ich das Modell als Funktion und das Werkzeug als Programm darum herum beschrieben. JEV ist die reinste Form dieser Trennung: Das Modell ist wirklich nur eine Funktion, alles andere gehört Ihnen.
Dieser Artikel handelt von diesem „alles andere".
Die fünf Aufgaben des Harness
In einer JEV-Integration übernimmt Ihr Code Folgendes:
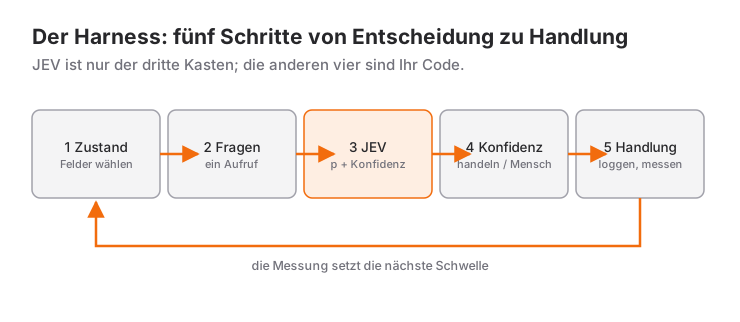
1. Den Zustand vorbereiten
Sie entscheiden, was zum Modell geht — und dieser eine Schritt bestimmt die Qualität der gesamten Integration. Die Dokumentation benennt eine klare Grenze: Je größer der Zustand mit Inhalten ohne Bezug zur Entscheidung wird, desto stärker sinkt die Genauigkeit. Irrelevante Details wirken als Ablenkung.
„Schicken wir alles, das Modell sortiert schon" funktioniert hier also nicht. Wählen Sie die relevanten Felder im Code aus, benennen Sie sie und verweisen Sie in der Frage auf diese Namen.
2. Die Fragen entwerfen
Alle Fragen zum selben Zustand gehören in einen Aufruf. Da sie parallel ausgewertet werden, kostet eine zusätzliche Frage kaum Zeit. Deshalb ist es rational, auch die „brauche ich vielleicht"-Fragen zu stellen; welche Antwort verwendet wird, entscheidet Ihr Code später.
3. Konfidenz als Tor verwenden
Die Antwort sagt was, die Konfidenz sagt ob Sie handeln sollen. Ihr Code sollte drei Wege kennen: ausführen, bestätigen lassen, an einen Menschen abgeben.
answer = response.answers["anliegen"]

if answer.confidence < 0.5:
    an_menschen_abgeben(ticket)
elif answer.confidence < 0.9 and ist_riskant(answer.choice):
    bestaetigung_einholen(answer.choice)
else:
    ausfuehren(answer.choice)
Legen Sie diese Schwellen anhand Ihrer eigenen Daten fest, nicht nach Gefühl — und übertragen Sie sie nicht von einer Frage auf die nächste.
4. Die Entscheidung in Handlung übersetzen
JEV sagt „nutze dieses Tool"; aufrufen müssen Sie es. Es sagt „dieses Ticket ist dringend"; in die Queue legen Sie es. Diese Schicht wirkt langweilig, aber hier entsteht das reale Verhalten des Systems: Wiederholungen, Rücknahmen, Protokollierung, Prüfpfad.
5. Messen
Ohne diesen Schritt ist der Rest bedeutungslos. Labeln Sie mindestens 50–100 echte Beispiele von Hand, vergleichen Sie mit JEVs Antworten und schlüsseln Sie die Genauigkeit nach Konfidenzbändern auf. Der typische Befund: über 0,9 sehr hohe Genauigkeit, unter 0,5 nahe am Zufall. Diese Tabelle bestimmt Ihre Schwelle, nicht Ihr Bauchgefühl.
Vier Architekturmuster
Die Dokumentation von TypeSafe benennt die Muster; alle halten in der Praxis.
Speculative fan-out. Stellen Sie in einem Aufruf neben den sicher benötigten auch die vielleicht benötigten Fragen. Wohin der Ablauf auch abzweigt, die Antwort liegt vor; eine zweite Runde entfällt.
Confidence-gated routing. Behandeln Sie Konfidenz als zweite Achse. Dieselbe Antwort wird bei hoher Konfidenz automatisch verarbeitet und bei niedriger an einen Menschen gegeben.
Composite scoring. Pressen Sie ein komplexes Urteil nicht in eine Frage, sondern zerlegen Sie es in atomare Scores und gewichten Sie im Code. So prüfen Sie jede Komponente einzeln und ändern Gewichte, ohne irgendetwas neu zu trainieren.
Intent routing. Klassifizieren Sie die eingehende Anfrage und leiten Sie jede an den besten Handler: deterministischer Code, ein spezialisiertes LLM oder ein Mensch. Im Beispiel der Dokumentation geht eine Bestellstatus-Abfrage ohne jedes LLM direkt in die Datenbank, eine Produktfrage an ein Modell mit Produktkontext, und eine Beschwerde je nach Komplexitäts-Score an ein Modell oder an einen Menschen.
Kombiniert ergibt sich diese Architektur: Teure Intelligenz läuft nur dann, wenn sie wirklich gebraucht wird — und mit dem richtigen Kontext. Alles andere erledigen eine günstige Entscheidungsschicht und gewöhnlicher Code.
Bekannte Grenzen
TypeSafe veröffentlicht die bekannten Schwachstellen von jev-1.13 auf einer eigenen Seite. Diese Offenheit erleichtert die Arbeit, denn jeder der folgenden Punkte trifft Sie in Produktion, wenn Sie ihn nicht kennen.
Wörtliches Lesen. Das Modell beantwortet die geschriebene Frage, nicht die gemeinte. Einschränkende Wörter, Verneinungen und implizite Bedingungen werden wörtlich genommen. Formulieren Sie Bedingungen explizit, benennen Sie Grenzfälle, zerlegen Sie mehrdeutige Fragen und kombinieren Sie im Code.
Zählen und Rechnen. Es zählt nicht zuverlässig — Zeichen in einem Wort, Vorkommen eines Begriffs, Elemente einer langen Liste. Zählen Sie im Code mit regulären Ausdrücken oder Parsern; notfalls eine Frage pro Element und die Summe selbst bilden.
Numerische Darstellungen. Hex-Werte, RGB-Tripel und binär kodierte Daten sind Schwachstellen. Wandeln Sie sie im Code in sinnvolle Kategorien um und fragen Sie danach.
Score-Interpolation. Score-Stufen sind numerisch schwach kalibriert. Versuchen Sie keine Zwischenwerte; prüfen Sie, ob eine Schwelle überschritten wurde.
Datum und Zeit. Daten werden als Text gelesen, nicht als geordnete Größen. Welches Datum früher liegt, wie weit zwei auseinanderliegen, ob eines in einen Zeitraum fällt — alles unzuverlässig. Ziehen Sie Datumsbestandteile per Choice heraus und vergleichen Sie im Code.
Umwege. Doppelte Verneinungen, die Eigenschaft einer Eigenschaft oder mehrstufige Schlussfolgerungen kosten Genauigkeit. Schreiben Sie direkt.
Großer Zustand mit irrelevanten Details. Oben erwähnt, aber wiederholenswert: unnötiger Inhalt senkt die Genauigkeit.
Feindseliger Inhalt. Text, der das Modell steuern soll — eingebettete Anweisungen, absichtlich irreführende Rahmung oder Text, der für seine eigene Einordnung argumentiert — kann die Antwort verschieben. Schreiben Sie explizite Kriterien und testen Sie dieses Szenario gezielt vor dem Livegang.
Widersprüchliche Anweisungen und Kriterien. Wollen beide Unterschiedliches, wird das Modell unsicher. Behandeln Sie Kriterien als Fortsetzung der Anweisung.
Strukturelle Invarianten. Nehmen Sie nicht an, dass Identitäten wie „P(ja) = 1 − P(nein)" über getrennte Fragen hinweg gelten. Formulieren Sie jede Frage nach ihrer direkten Bedeutung und übertragen Sie keine Schwellen zwischen Typen.
Generierung. Dafür ist das Modell nicht trainiert. Über verkettete Choices erzwingbar, aber schlecht und sehr langsam.
Beim Blick auf diese Liste zeigt sich ein Muster: Überall dort, wo JEV schwach ist, ist Code stark. Zählen, Vergleichen, Rechnen, Sortieren — das ist ohnehin Aufgabe deterministischen Codes. Dem Modell bleibt nur der Teil, der echtes Urteil verlangt.
Die Kosten berechnen
Die Preisgestaltung passt in zwei Sätze: Eingabe 0,042 Dollar pro Million Tokens, Ausgabe kostenlos. Der Kontext umfasst 64k Tokens pro Anfrage, davon 32k für den Zustand plus die längste Frage. Die Ratenlimits liegen bei 250.000 Tokens pro Sekunde und 1.200 Anfragen pro Minute, mit dem Hinweis, dass sie unter Last dynamisch angepasst werden.
Die Rechnung:
Tageskosten ≈ (Anfragen pro Tag × durchschnittliche Eingabe-Tokens) / 1.000.000 × 0,042Entscheidend: Jede zusätzliche Frage zum selben Zustand kostet nur ihre eigenen Tokens. Weil der Zustandstext nicht erneut gesendet wird, war die Bündelung von 13 Fragen in einem veröffentlichten Cookbook rund 12-mal günstiger und 10-mal schneller als getrennte Aufrufe.
Praktische Folgerung: Optimieren Sie Fragen pro Aufruf, nicht Aufrufe pro Tag. Die meisten Teams machen das Gegenteil.
Reihenfolge für den Produktiveinsatz
Die Reihenfolge, die ich empfehle:
- Eine Entscheidung auswählen. Beginnen Sie mit der volumenstärksten und risikoärmsten. Ein Moderationslabel ist ein guter Start, eine Zahlungsfreigabe nicht.
- Im Schattenbetrieb laufen lassen. Zeichnen Sie JEVs Entscheidung auf, ohne sie auszuführen. Stellen Sie sie neben Ihr bestehendes System.
- Schwelle aus Ihren Daten ableiten. Erstellen Sie eine Genauigkeitstabelle nach Konfidenzbändern.
- Schrittweise öffnen. Automatisieren Sie zuerst die Fälle mit hoher Konfidenz und lassen Sie den Rest bei Menschen. Erhöhen Sie den Automatisierungsgrad mit der Zeit.
- Protokollieren. Speichern Sie für jede Entscheidung Zustand, Fragen, Antworten und Konfidenz. Wenn sich die Modellversion ändert (
jev-latestist ein Alias, keine feste Version), sehen Sie nur so, was sich verschoben hat.
Punkt fünf ist wichtiger, als er klingt. Aliase sind bequem, aber eine feste Version wie jev-1.13.0 ist in Produktion vorhersehbarer. Testen Sie eine neue Version an Ihren eigenen Daten, bevor Sie wechseln.
Den Coding-Agenten machen lassen
Sie müssen diese Integration nicht von Hand schreiben. TypeSafe veröffentlicht einen offiziellen Agent Skill:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Für andere Agentenumgebungen leistet npx skills add typesafe-ai/skills --skill typesafe-ai dasselbe. Der Skill vermittelt dem Agenten Fragetypen, Architekturmuster und Evaluationspraxis, sodass Sie ihn bitten können, „Stellen zu finden, an denen fragiler Parsing-Code durch intelligente Entscheidungen ersetzt werden kann".
Wie Skills funktionieren und was Sie vor der Installation prüfen sollten, steht im Agent-Skill-Artikel.
Fazit
Die Frage zu JEV lautet nicht „wie klug ist es?", sondern „soll mein Code diese Entscheidung treffen oder ein Modell?" Drei Prüfsteine klären das: Kommt die Antwort aus einer geschlossenen Menge, lässt sich eine Regel schreiben, und was kostet eine falsche Entscheidung?
Lässt sich eine Regel schreiben, schreiben Sie Code. Ist die Antwort offen, nehmen Sie ein LLM. Der weite Bereich dazwischen — Entscheidungen ohne mögliche Regel, aber mit kurzer Antwort — wurde bisher entweder grob mit Stichwörtern oder verschwenderisch mit einem teuren Modell gelöst. Genau diese Lücke füllt JEV.
Der Rest der Serie: Was ist JEV, Choice, Score und Noul, 10 Anwendungsfälle.
Grenzen und Preise stammen aus der jev-1.13-Dokumentation von TypeSafe und können sich mit der Version ändern.
Häufig gestellte Fragen
Kann ich JEV allein einsetzen?
Nein. JEV liefert eine Entscheidung, keine Antwort: eine Option, einen Score oder eine Wahrscheinlichkeit. Der Ablauf, der sie umsetzt — Zustand vorbereiten, nach Konfidenz verzweigen, Handlung ausführen, Ergebnis protokollieren — liegt bei Ihnen. Ohne System drumherum halten Sie nur Zahlen in der Hand.
Was sind die bekannten Schwächen von JEV?
Es zählt nicht, vergleicht keine Daten, rechnet nicht, ist schwach bei numerischen Darstellungen wie Hex und RGB, interpoliert nicht zwischen Score-Stufen, verliert Genauigkeit bei doppelten Verneinungen und Umwegen, reagiert empfindlich auf großen irrelevanten Zustand und kann durch feindselig geschriebenen Text verschoben werden. All das steht auf der veröffentlichten Liste des Anbieters.
Welche Konfidenzschwelle soll ich wählen?
Es gibt keine feste Antwort; leiten Sie sie aus Ihren Daten ab. Als Ausgangspunkt empfiehlt die Dokumentation: unter 0,5 an Menschen, zwischen 0,5 und 0,9 bei geringem Risiko automatisch und bei hohem Risiko mit Bestätigung, über 0,9 auch bei irreversiblen Aktionen mit Bestätigung. Übertragen Sie Schwellen nicht zwischen Fragen.
Wie berechnet man die Kosten von JEV?
Eingabe kostet 0,042 Dollar pro Million Tokens, Ausgabe ist kostenlos. Die Tageskosten ergeben sich grob als „(Anfragen × durchschnittliche Eingabe-Tokens) / 1.000.000 × 0,042". Da der Zustand für zusätzliche Fragen nicht erneut gesendet wird, fallen weitere Fragen kaum ins Gewicht.
Sollte ich die Modellversion festschreiben?
Für Produktion ja. jev-latest ist ein Alias und kann mit der Zeit auf eine andere Version zeigen, was Verhaltensänderungen bedeutet. Eine feste Version wie jev-1.13.0 und ein Wechsel erst nach eigenem Genauigkeitstest sind vorhersehbarer.
Wo fange ich mit einer JEV-Integration an?
Wählen Sie die volumenstärkste und risikoärmste Entscheidung, lassen Sie sie zunächst im Schattenbetrieb laufen (Entscheidung aufzeichnen, nicht ausführen), erstellen Sie aus eigenen Daten eine Tabelle von Genauigkeit gegen Konfidenz und automatisieren Sie dann nur die Fälle mit hoher Konfidenz. Den Automatisierungsgrad erhöhen Sie, sobald die Messungen es rechtfertigen.
Verwandte Artikel
Was ist JEV? Die Reflexschicht der KI (TypeSafes System-One-Modell)
JEV ist kein Chatmodell, sondern ein Modell, das entscheidet. Die System-One-Idee, die drei Fragetypen, Preise und Grenzen — ab dem ersten API-Aufruf erklärt.
JEV-Anwendungsfälle: 10 reale Szenarien und ihre Kosten
Von Kommentarmoderation über Tool-Auswahl für Agenten bis zu Modell-Routing und RAG-Filterung: zehn Szenarien, in denen JEV sich wirklich lohnt — mit Code und Kostenvergleich.
JEV-Fragetypen: Choice, Score und Noul richtig einsetzen
Die drei Fragetypen von JEV, die Regeln für gute Kriterien, der Unterschied zwischen Wahrscheinlichkeit und Konfidenz und warum Dutzende Fragen in einen Aufruf gehören.