JEV-Fragetypen: Choice, Score und Noul richtig einsetzen
7 Min. Lesezeit
Im Artikel darüber, was JEV ist, habe ich die drei Fragetypen nur kurz erwähnt. In der Praxis entscheidet sich genau hier die Qualität: Der Wert der Antwort hängt an der Form der Frage. Den falschen Typ zu wählen oder Kriterien nachlässig zu schreiben, ist der häufigste Grund, warum am Ende das Modell beschuldigt wird.
Hier gehe ich alle drei mit lauffähigem Code durch und zeige, wann Sie welchen nehmen. Am Ende kommt der eigentliche Gewinn: Dutzende Fragen in einem einzigen Aufruf.
Drei Typen, drei Antwortformen
| Typ | Frage | Rückgabefelder |
|---|---|---|
| Choice | „Welche davon?" | choice, probabilities, confidence |
| Score | „Welche Stufe?" | score, legend, probabilities, confidence |
| Noul | „Ist das wahr?" | noul (Wahrscheinlichkeit zwischen 0 und 1) |
Alle drei lassen sich in einer Anfrage mischen und arbeiten auf demselben Zustand (state).
Choice: geschlossene Menge ohne Reihenfolge
Nehmen Sie Choice, wenn die Antwort aus einer bekannten Menge ohne Ordnung stammt: ein Ticket an eine Abteilung leiten, einen Dokumenttyp klassifizieren, eine Programmiersprache erkennen.
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state={"mail": "Guten Tag, anbei die Rechnung für September."},
    questions={
        "mail_typ": Choice(
            instructions="In welche Kategorie gehört `mail`?",
            criteria={
                "rechnung": "Ein Zahlungsbeleg oder eine Rechnung wird übermittelt.",
                "sponsoring": "Ein Kooperations- oder Werbeangebot.",
                "support": "Ein Problem mit Produkt oder Dienstleistung wird gemeldet.",
                "spam": "Unerwünschte Massenzusendung.",
            },
        ),
    },
)

answer = response.answers["mail_typ"]
print(answer.choice)         # "rechnung"
print(answer.probabilities)  # {"rechnung": 0.94, "spam": 0.03, ...}
print(answer.confidence)     # 0.91
Eine Choice-Frage erlaubt bis zu 255 Optionen. Das klingt übertrieben, bis man in die Cookbooks von TypeSafe schaut: eine Fähigkeit aus einem Katalog von 182 auswählen oder ein Dokument einer von 75 Branchengruppen zuordnen. 255 ist eine Entwurfsentscheidung, keine Dekoration.
Zwei praktische Regeln:
- Schreiben Sie Beschreibungen, nicht nur Labels. Statt
"rechnung"lieber"rechnung": "Ein Zahlungsbeleg oder eine Rechnung wird übermittelt."Das Modell entscheidet anhand der Definition, nicht des Etiketts. - Schließen Sie die Menge. Lassen Sie eine Option
"sonstiges"oder"unklar"für Eingaben, die nirgends passen. Sonst wird das Modell in die nächstbeste falsche Schublade gedrängt.
Score: eine beschreibbare Skala
Nehmen Sie Score, wenn die Antwort auf einem Spektrum liegt und Sie jeden Punkt dieses Spektrums in Worte fassen können: Fehlerschwere, Verärgerung der Kundschaft, Erfahrungsniveau.
from typesafe_sdk import Score

questions = {
    "dringlichkeit": Score(
        instructions="Wie dringend ist diese Supportanfrage?",
        criteria=[
            "Rein informativ, kann warten.",
            "Nutzer ist genervt, arbeitet aber weiter.",
            "Arbeit steht still, Eingriff am selben Tag nötig.",
            "Datenverlust oder Sicherheitsrisiko.",
        ],
    ),
}
Score braucht mindestens zwei Stufen, die API akzeptiert höchstens zehn. Mehr Stufen bringen keine Genauigkeit; Stufen, die sich nicht unterscheiden lassen, verwischen nur die Verteilung. Drei oder vier gut beschriebene Stufen schlagen acht vage.
Eine wichtige Grenze: Die Dokumentation sagt ausdrücklich, dass Score-Stufen numerisch schwach kalibriert sind. Versuchen Sie nicht, einen Zwischenwert wie „etwa 2,4" zu rekonstruieren. Nutzen Sie Score für Schwellenprüfungen („über 2?"), nicht als Messinstrument.
Noul: wenn die Wahrscheinlichkeit selbst das Signal ist
Nehmen Sie Noul für eine saubere Ja/Nein-Frage, bei der die Wahrscheinlichkeit selbst nützlich ist: enthält diese Nachricht personenbezogene Daten, will die Kundin eine Rückerstattung, stellt dieser Satz eine feste Tatsachenbehauptung ohne Quelle auf.
from typesafe_sdk import Noul

questions = {
    "personenbezug": Noul(
        instructions="Enthält `nachricht` eine Telefonnummer, Adresse oder Ausweisnummer?",
    ),
}
# response.answers["personenbezug"].noul -> 0.02
Der häufigste Fehler ist, 0,5 als „mittel" zu lesen. Es bedeutet nicht mittel, sondern unentschieden: Ja und Nein sind gleich wahrscheinlich. Wenn Sie eine mittlere Stufe brauchen, ist das eine Score-Frage, keine Noul-Frage.
Regeln für Anweisungen und Kriterien
Alle drei Typen haben dieselben zwei Eingaben: instructions (Ihre Frage) und criteria (Optionen, Stufen oder eine Ja/Nein-Präzisierung).
JEV beantwortet die Frage, die Sie geschrieben haben, nicht die gemeinte. Einschränkende Wörter, Verneinungen und implizite Bedingungen werden wörtlich gelesen. Deshalb:
- Referenzieren Sie Zustandsfelder mit Namen, etwa
`ticket.messages[0].text`. Sagen Sie nicht „im Text", sondern welches Feld. - Vermeiden Sie doppelte Verneinungen und Umwege. „Ist dieser Inhalt nicht unangemessen?" kostet Genauigkeit. Die Dokumentation nennt das indirection und weist darauf hin, dass jeder zusätzliche Schlussfolgerungsschritt Genauigkeit frisst.
- Lassen Sie Anweisung und Kriterien nie widersprechen. Wollen beide Unterschiedliches, wird das Modell unsicher. Schreiben Sie Kriterien als Fortsetzung der Anweisung.
- Teilen Sie mehrdeutige Fragen. „Ist diese Anfrage dringend und genehmigungspflichtig?" sind zwei Fragen. Stellen Sie beide und kombinieren Sie im Code.
- Räumen Sie den Zustand auf. Inhalte ohne Bezug zur Entscheidung senken die Genauigkeit. Wählen Sie die relevanten Felder im Code aus, statt alles zu schicken.
Diese fünf Regeln bringen mehr als ein Modellwechsel.
Wahrscheinlichkeit und Konfidenz sind nicht dasselbe
Choice- und Score-Antworten liefern zwei verschiedene Zahlen, die häufig verwechselt werden.
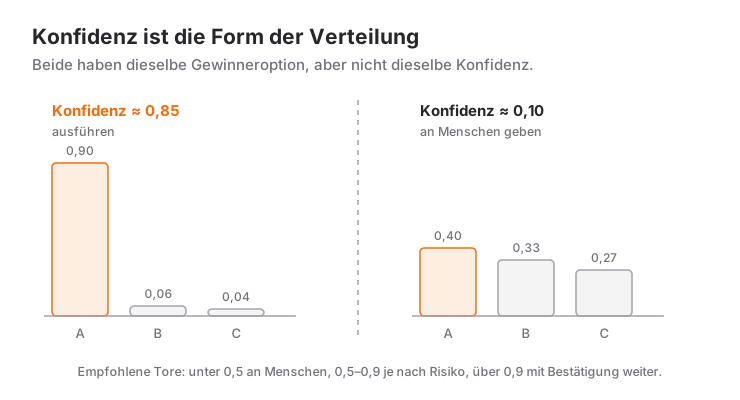
Wahrscheinlichkeiten sind die Einzelwerte pro Option. Konfidenz ist eine einzelne Zahl, die die Form dieser Verteilung zusammenfasst: hoch, wenn sich die Wahrscheinlichkeit auf eine Option konzentriert, niedrig, wenn sie sich verteilt.
Betrachten Sie eine Frage mit drei Optionen: [0,90 / 0,06 / 0,04] gegenüber [0,40 / 0,33 / 0,27]. Der Gewinner ist derselbe, aber im zweiten Fall wirft das Modell praktisch eine Münze. Konfidenz komprimiert diesen Unterschied auf eine Zahl; für drei Optionen etwa (3 × größte Wahrscheinlichkeit − 1) / 2. Volle Konzentration ergibt 1,0, Gleichverteilung 0,0.
Die Schwellen, die die Dokumentation vorschlägt:
- Unter 0,5: Das Modell ist wirklich unsicher. Nicht raten — an einen Menschen geben oder den Ablauf stoppen.
- 0,5 bis 0,9: Bei geringem Risiko direkt handeln (Information anzeigen, taggen). Bei hohem Risiko bestätigen lassen.
- Über 0,9: Auch bei irreversiblen Aktionen fortfahren, aber trotzdem bestätigen lassen.
Der Wert liegt darin, dass Sie zwei Achsen bekommen. Die Antwort sagt was, die Konfidenz sagt ob Sie handeln sollen. Ein klassischer Klassifikator hat diese zweite Achse nicht.
Eine Warnung: Übertragen Sie Schwellen nicht zwischen Typen. Ein 0,7, das bei einer Noul-Frage funktioniert, bedeutet bei der Konfidenz einer Choice-Frage etwas anderes. Kalibrieren Sie jede Frage an Ihren eigenen Daten.
Der eigentliche Gewinn: viele Fragen, ein Aufruf
Jetzt zum wichtigsten Teil. JEV wertet alle Fragen einer Anfrage parallel aus. Eine zusätzliche Frage verändert die Antwortzeit kaum und kostet nur ihre eigenen Tokens — die sehr günstig sind.
response = client.system_one(
    state=state,
    questions={
        "erstattung": Noul(instructions="Wird eine Rückerstattung gefordert?"),
        "anliegen": Choice(instructions="Was ist das Hauptanliegen?", criteria={...}),
        "verärgerung": Score(instructions="Wie verärgert ist die Kundschaft?", criteria=[...]),
        "personenbezug": Noul(instructions="Enthält die Nachricht personenbezogene Daten?"),
        "genehmigung": Noul(instructions="Ist eine Freigabe durch Vorgesetzte nötig?"),
    },
)
In einem veröffentlichten Cookbook von TypeSafe ist die Bündelung von 13 Fragen in einem Aufruf rund 12-mal günstiger und 10-mal schneller als 13 getrennte Aufrufe — bei identischen Antworten.
Das dreht die übliche Gewohnheit um. Normalerweise denkt man „nur fragen, wenn nötig"; hier ist das Gegenteil rational: stellen Sie auch die Fragen, die Sie vielleicht brauchen. Die Dokumentation nennt dieses Muster speculative fan-out. Wohin der Ablauf auch abzweigt, die Antwort liegt bereits vor.
Dieselbe Logik öffnet Prüfungen, die Sie aus Kostengründen weggelassen haben: eine Personenbezugsprüfung für jede eingehende Nachricht, eine Relevanz- und Prompt-Injection-Prüfung für jede abgerufene Passage, eine Richtlinienprüfung für jede Antwort. Einzeln teuer, als Zusatzfrage nahezu kostenlos.
Wenn Sie sich nicht entscheiden können
Ein einfacher Ablauf:
- Kommt die Antwort aus einer geschlossenen Menge ohne Ordnung? → Choice
- Liegt sie auf einem Spektrum, dessen Punkte Sie beschreiben können? → Score
- Ist es ein sauberes Ja/Nein, bei dem die Wahrscheinlichkeit selbst nützt? → Noul
- Nichts davon? Dann ist es vermutlich eine Generierungsaufgabe und nicht JEVs Sache.
Der vierte Fall kommt öfter vor als gedacht. „Fasse diese Mail zusammen" ist keine JEV-Frage. „An welche Abteilung gehört diese Mail" dagegen schon.
Die Muster in echten Szenarien zeigt JEV-Anwendungsfälle; was Sie vor dem Produktiveinsatz wissen müssen, steht in Harness, Kosten und Grenzen.
Die technischen Werte stammen aus der offiziellen Dokumentation von TypeSafe und können sich mit der Version ändern.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Choice und Score in JEV?
Choice wählt eine Option aus einer geschlossenen Menge ohne Reihenfolge (Abteilung, Dokumenttyp, Sprache). Score verortet die Eingabe auf einer Skala geordneter Stufen (Dringlichkeit, Verärgerung, Schwere). Besteht zwischen Ihren Antworten ein „weniger/mehr"-Verhältnis, nehmen Sie Score, sonst Choice.
Was bedeutet 0,5 bei einer Noul-Antwort?
Unentschieden, nicht „mittel". Ja und Nein sind gleich wahrscheinlich. Wer eine mittlere Stufe messen will, braucht eine Score-Frage statt einer Noul-Frage.
Wie viele Optionen darf eine Choice-Frage haben?
Die API akzeptiert bis zu 255. In der Praxis steigt die Genauigkeit deutlich, wenn jede Option statt eines nackten Labels eine kurze Beschreibung trägt; eine zusätzliche Option „unklar" für nicht passende Eingaben ist gute Praxis.
Was unterscheidet Konfidenz von Wahrscheinlichkeit?
Die Wahrscheinlichkeit ist der Einzelwert pro Option; die Konfidenz beschreibt in einer Zahl, wie stark sich diese Verteilung auf einen Punkt konzentriert. Dieselbe Gewinneroption kann mit sehr unterschiedlicher Konfidenz kommen — und die Konfidenz entscheidet, ob Sie handeln.
Wie viele Fragen gehören in einen Aufruf?
Alle, die denselben Zustand teilen. Da Fragen parallel ausgewertet werden, beeinflusst eine zusätzliche Frage die Latenz kaum und erhöht die Kosten nur um ihre eigenen Tokens. In einem veröffentlichten Beispiel war die Bündelung von 13 Fragen rund 12-mal günstiger und 10-mal schneller.
Sollte ich meine Fragen auf Englisch schreiben?
Die Dokumentation nennt Englisch als primäre Trainingssprache. Anweisungen und Kriterien auf Englisch zu schreiben und den bewerteten Text in seiner Sprache zu belassen, ist ein sinnvoller Start — vergleichen Sie beide Varianten aber an 50–100 eigenen Beispielen.
Verwandte Artikel
Was ist JEV? Die Reflexschicht der KI (TypeSafes System-One-Modell)
JEV ist kein Chatmodell, sondern ein Modell, das entscheidet. Die System-One-Idee, die drei Fragetypen, Preise und Grenzen — ab dem ersten API-Aufruf erklärt.
JEV-Anwendungsfälle: 10 reale Szenarien und ihre Kosten
Von Kommentarmoderation über Tool-Auswahl für Agenten bis zu Modell-Routing und RAG-Filterung: zehn Szenarien, in denen JEV sich wirklich lohnt — mit Code und Kostenvergleich.
JEV ins System einbauen: Harness, Kosten und bekannte Grenzen
Allein liefert JEV nur eine Wolke aus Wahrscheinlichkeiten. So bauen Sie den Harness, der daraus Handlung macht, welche Architekturmuster helfen und wo das Modell schwach ist.