JEV-Anwendungsfälle: 10 reale Szenarien und ihre Kosten
8 Min. Lesezeit
Ich habe erklärt, was JEV ist und wie die drei Fragetypen funktionieren. Jetzt die eigentliche Frage: Was bauen Sie damit?
Diese Frage ist schwerer, als sie klingt, denn JEV ist ein Bauteil, kein Produkt. Wer eine Lösung aus der Schachtel erwartet, wird enttäuscht. Wer aber fragt „welche Entscheidungen habe ich aufgegeben, weil ein teures Modell zu fragen sich nicht lohnte?", bekommt schnell eine lange Liste.
Unten stehen zehn Szenarien. Gemeinsam ist ihnen: Die Entscheidung kommt aus einer geschlossenen Menge, das Volumen ist hoch, Latenz zählt, und bisher wurde es entweder mit Stichwörtern oder mit einem teuren LLM-Aufruf gelöst.
1. Kommentar- und Nachrichtenmoderation
Der direkteste Fall. Für jeden eingehenden Kommentar stellen Sie mehrere Fragen in einem Aufruf: Spam, Beleidigung, Scherz, Frage, Wunsch?
questions = {
    "typ": Choice(
        instructions="In welche Kategorie fällt `kommentar`?",
        criteria={
            "frage": "Es wird etwas gefragt.",
            "wunsch": "Ein Inhalts- oder Funktionswunsch.",
            "kritik": "Negativ, aber konstruktiv.",
            "spam": "Werbung, Linkköder oder Massenposting.",
            "beleidigung": "Aggressive Sprache gegen eine Person.",
            "plauderei": "Allgemeine Unterhaltung.",
        },
    ),
    "aktion_noetig": Noul(instructions="Ist ein Eingriff der Moderation nötig?"),
}
Das chronische Problem stichwortbasierter Moderation ist, dass sie Bedeutung verfehlt: Ein Satz, der auf einer Wortliste als Beleidigung gilt, ist im Kontext ein Scherz. Ein Modell, das aus einer geschlossenen Menge entscheidet, erkennt den Unterschied.
In einer öffentlichen Demo dauerte die Klassifikation von 805 YouTube-Kommentaren in einem Durchgang rund 37 Sekunden und kostete etwa 14 Cent. Dieselbe Menge einzeln an ein Chatmodell zu geben, verschiebt Zeit und Rechnung in eine andere Größenordnung.
2. Triage von E-Mails und Supportanfragen
Postfach-Klassifikation liegt JEV besonders gut. Rechnung, Sponsoringangebot, behördliches Dokument, Supportanfrage? Dazu ein Dringlichkeits-Score und eine Prüfung auf personenbezogene Daten — alles im selben Aufruf.
Der eigentliche Gewinn ist nicht das Etikett, sondern das Routing: welches Team, welche Queue, welches SLA. Eine Anfrage in der falschen Queue kostet ein Vielfaches des Aufrufs, der sie klassifiziert hat.
3. Tool-Auswahl für Agenten
Sie wollen einem Agenten 150 Tools geben. Alle in den Kontext zu laden, ist teuer und lenkt das Modell ab. Die Lösung: JEV auswählen lassen.
In jeder Runde entscheidet JEV je nach aktuellem Kontext, welche Tools relevant sind; nur diese wenigen gelangen in den Kontext des Hauptagenten. Der Kontext bleibt schlank, die Kosten sinken, die Trefferquote steigt.
TypeSafe hat genau das in einem Cookbook gemessen: höchstens eine Fähigkeit aus einem Katalog von 182 auswählen, in zwei Stufen — ein Aufruf sortiert den gesamten Katalog und fragt, ob überhaupt eine Fähigkeit nötig ist; ein zweiter liest die drei besten Kandidaten genauer und darf alle ablehnen.
4. Routing zwischen Modellen und Subagenten
Sie haben Modelle unterschiedlicher Stärke. Einfache Aufgaben sollen an ein kleines, schwere an ein starkes Modell. Mitten im Gesprächsverlauf das Modell zu wechseln, funktioniert nicht — es zerstört das Caching und zerstreut den Kontext.
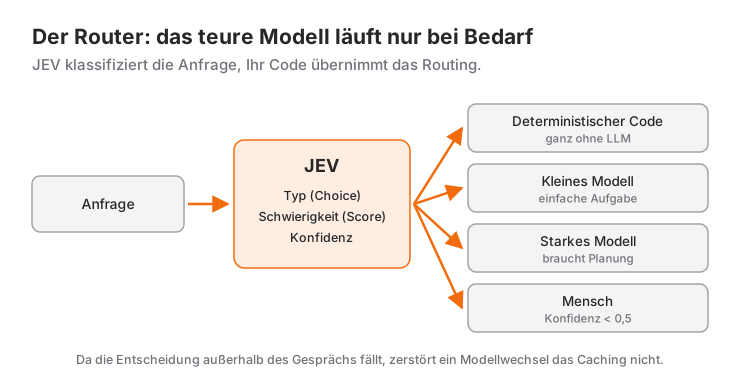
Die Entscheidung außerhalb des Gesprächs mit JEV zu treffen, funktioniert dagegen sauber:
questions = {
    "aufgabentyp": Choice(
        instructions="Welcher Art ist die Anfrage?",
        criteria={
            "suche": "Informationssuche oder Datenbankabfrage.",
            "bearbeitung": "Kleine Änderung an vorhandenem Text oder Code.",
            "entwurf": "Architekturentscheidung oder mehrstufige Planung.",
        },
    ),
    "schwierigkeit": Score(
        instructions="Wie schwer ist die Aufgabe?",
        criteria=["In einem Schritt erledigt.", "Braucht mehrere Schritte.", "Braucht lange Planung und Prüfung."],
    ),
}
Das Routing selbst machen Sie im Code — und hier wird die Konfidenz zum Tor: Liegt sie unter 0,5, entscheiden Sie nicht, sondern geben an das starke Modell oder an einen Menschen ab. Die Dokumentation nennt diese Muster intent routing und confidence-gated routing.
5. Unnötige Schritte eines Agenten abschneiden
Die teuerste Angewohnheit eines Agenten ist, eine Datei zu lesen, die er nicht braucht. Jeder Lesevorgang bläht den Kontext auf, und jede Aufblähung verteuert alle folgenden Runden.
Setzen Sie eine einzige Noul-Frage davor: „Ist der Inhalt dieser Datei wirklich nötig, um die Aufgabe zu erledigen?" Liegt die Antwort unter 0,3, wird das Lesen übersprungen. Dieses kleine Tor rettet über lange Sitzungen einen erheblichen Teil des Kontextbudgets.
Dieselbe Logik greift anderswo: Sollen die Tests laufen, soll dieser Fehler angezeigt werden, soll dieser Schritt wiederholt werden?
6. Passagenfilter für RAG und Schutz vor Prompt Injection
Jede abgerufene Passage an das Hauptmodell zu geben, ist teuer und riskant. Fragen Sie in einem Aufruf zu jeder Passage: relevant, widersprüchlich, enthält sie eine versteckte Anweisung?
Der letzte Punkt ist ein echter Sicherheitsgewinn. Eine in ein abgerufenes Dokument eingebettete Injection — „ignoriere die vorherigen Anweisungen" — lässt sich aussortieren, bevor sie das Hauptmodell erreicht. TypeSafe führt diesen Einsatz als eigenes Muster.
Verwandt ist die Zitatprüfung: Stützt die angegebene Quelle die Behauptung tatsächlich? Eine einzelne Choice-Frage klärt das, und ihre Konfidenz markiert Zweifelsfälle für die menschliche Prüfung.
7. Suchergebnisse neu sortieren
Klassische Suche (BM25, Vektorsuche) ist schnell, verfehlt aber Bedeutung. Einen teuren Re-Ranker daraufzusetzen, kostet.
JEV passt hier genau: Sie stellen pro Anfrage-Kandidat-Paar eine Frage und sortieren die Liste neu. In einem veröffentlichten Cookbook mit juristischen Daten stieg die Top-1-Genauigkeit auf 30er-BM25-Listen dadurch von 5 % auf 18 % und die Top-10-Genauigkeit von 38 % auf 62 %.
8. Felder aus unstrukturiertem Text ziehen
Weil JEV keinen Text erzeugt, drehen Sie die Extraktion um: Kandidaten finden Sie im Code, die Auswahl überlassen Sie dem Modell.
Für Daten, Beträge und Telefonnummern holen Sie Kandidaten per regulärem Ausdruck und fragen dann per Choice: „Welcher davon ist der gesuchte Wert?" So erhalten Sie einen wortgetreuen Wert und schließen aus, dass das Modell etwas erfindet.
Dieser Unterschied ist wichtig: JEV kann keine Daten vergleichen und nicht zählen. Aber es kann beantworten, welches der im Dokument genannten Daten das Fälligkeitsdatum ist. Die Arithmetik machen Sie im Code.
9. Qualitäts- und Richtlinienprüfung
Eigenschaften eines Textes zu bewerten, ist ein schneller Bereich für JEV. Für einen Inhalt können Sie in einem Aufruf fragen: Werden Quellen genannt, werden feste Behauptungen aufgestellt, wird FOMO erzeugt, steckt eine Produktwerbung darin, wie viel ist Füllmaterial?
In einer öffentlichen Demo kostete die Bewertung eines 3,5-minütigen Vortrags entlang der Achsen konkrete Information / Füllmaterial / Wiederholung / Vagheit / Eigenwerbung rund einen Cent. Dieselbe Messung von einem großen Modell zu holen, wird bei Hunderten von Inhalten zur Budgetfrage.
Für LLM-Produkte wird dieselbe Struktur zum Guardrail: Jede ein- und ausgehende Nachricht in einem Aufruf prüfen, mit Fragen wie „ist das ein Jailbreak-Versuch" und „wie viel Schaden richtet Befolgen an".
10. Spiele, Simulationen und Echtzeitentscheidungen
Das letzte Szenario ist das unterhaltsamste und architektonisch das lehrreichste. Spiele und Simulationen entscheiden in jedem Frame: diesen Block abbauen, vor diesem Gegner fliehen, diese Einheit dorthin bewegen.
Ein LLM kommt in diese Schleife nicht hinein — zu langsam, zu teuer. JEV schon, indem es zwischen vorgelegten Optionen wählt. Aufbauten, in denen ein LLM den langfristigen Plan macht und JEV die Reflexe liefert, wurden in öffentlichen Demos gezeigt.
Dieselbe Architektur gilt weit außerhalb von Spielen: Robotik, Verkehrssimulation, Browser-Automatisierung. „Welches Element auf dem aktuellen Bildschirm soll angeklickt werden?" ist eine lehrbuchmäßige Choice-Frage.
Kostenrechnung: warum der Unterschied so groß ist
Konkret gerechnet: Sie klassifizieren täglich 50.000 kurze Texte mit durchschnittlich 400 Tokens.
- Gesamteingabe: 20 Millionen Tokens pro Tag.
- JEV-Preis: 0,042 Dollar pro Million Eingabe-Tokens, Ausgabe kostenlos.
- Tageskosten: etwa ein Dollar.
Dieselbe Arbeit mit einem mittleren Chatmodell landet im dreistelligen Bereich, weil die Token-Preise ein bis zwei Zehnerpotenzen höher liegen und Ausgabe-Tokens ebenfalls abgerechnet werden. In einem öffentlichen Vergleich kostete derselbe Test auf einem großen Reasoning-Modell 176 Dollar und mit JEV 39 Cent.
Der Punkt ist nicht die Ersparnis, sondern die verschobene Schwelle. Eine Prüfung für 176 Dollar können Sie nicht an jede Anfrage hängen; eine für 39 Cent schon. Wenn der Preis fällt, machen Sie dasselbe nicht billiger — Sie fangen an, etwas zu tun, das Sie vorher nie getan haben.
So finden Sie Ihr eigenes Szenario
Suchen Sie in Ihrer Codebasis nach drei Dingen:
- Stichwortlisten. Jedes
if "erstattung" in nachrichtist eine Pseudoregel, die Bedeutung verfehlt — und ein JEV-Kandidat. - Teure Aufrufe „für alle Fälle". Dateien, die Ihr Agent in jeder Runde liest, LLMs, die Sie bei jeder Anfrage rufen. Setzen Sie eine Torfrage davor.
- Prüfungen, die Sie nie gebaut haben. Jedes „schön wäre es, jeden Kommentar zu prüfen, aber das ist zu teuer". Der Preis entkräftet diesen Satz.
Wenn Sie mit einem Coding-Agenten arbeiten, können Sie ihn diese Suche übernehmen lassen; der offizielle Agent Skill von TypeSafe zielt genau darauf, Stellen zu finden, an denen fragiler Parsing-Code durch intelligente Entscheidungen ersetzt werden kann.
Bevor Sie etwas davon produktiv nehmen, lesen Sie die Grenzen und den Harness-Aufbau — keines dieser Szenarien funktioniert, indem man das Modell ansteckt und weggeht.
Die Messwerte stammen aus veröffentlichten Cookbooks von TypeSafe und aus öffentlichen Demos; Ihre eigene Last kann abweichen.
Häufig gestellte Fragen
Wo hilft JEV am meisten?
Überall dort, wo die Entscheidung aus einer geschlossenen Menge kommt, das Volumen hoch ist und Latenz zählt: Moderation, E-Mail- und Ticket-Triage, Tool- und Modellauswahl für Agenten, Filterung von RAG-Passagen, Neusortierung von Suchergebnissen sowie Qualitäts- und Richtlinienprüfung.
Kann JEV ein LLM ersetzen?
Nein. JEV erzeugt keinen Text; Schreiben, Zusammenfassen, Übersetzen und Programmieren bleiben LLM-Arbeit. JEV ist die Entscheidungsschicht davor, die günstig bestimmt, welches Modell mit welchem Kontext wann läuft.
Wie günstig ist JEV wirklich?
Eingabe kostet 0,042 Dollar pro Million Tokens, Ausgabe ist kostenlos. Eine Last mit 50.000 kurzen Texten pro Tag ergibt grob einen Dollar täglich. Dieselbe Aufgabe mit Chatmodellen liegt zwei bis drei Zehnerpotenzen höher.
Wie binde ich JEV an meinen Agenten an?
Die drei häufigsten Anknüpfungspunkte sind Tool-Auswahl (nur kontextrelevante Tools laden), Modell-Routing (das passende Modell nach Aufgabentyp und Schwierigkeit) und Torentscheidungen (soll diese Datei gelesen, soll dieser Schritt übersprungen werden). In allen drei Fällen entscheidet JEV, handelt Ihr Code.
Reicht JEV für Kommentarmoderation?
Die Klassifikation gelingt gut, doch sollten Sie die Aktion nach Konfidenz staffeln statt sie direkt auszuführen: Spam mit hoher Konfidenz wird automatisch entfernt, Fälle mit niedriger Konfidenz gehen in die menschliche Prüfung. Die Dokumentation weist außerdem ausdrücklich darauf hin, dass Texte, die für ihre eigene Einordnung argumentieren, die Antwort verschieben können.
Verwandte Artikel
Was ist JEV? Die Reflexschicht der KI (TypeSafes System-One-Modell)
JEV ist kein Chatmodell, sondern ein Modell, das entscheidet. Die System-One-Idee, die drei Fragetypen, Preise und Grenzen — ab dem ersten API-Aufruf erklärt.
JEV ins System einbauen: Harness, Kosten und bekannte Grenzen
Allein liefert JEV nur eine Wolke aus Wahrscheinlichkeiten. So bauen Sie den Harness, der daraus Handlung macht, welche Architekturmuster helfen und wo das Modell schwach ist.
JEV-Fragetypen: Choice, Score und Noul richtig einsetzen
Die drei Fragetypen von JEV, die Regeln für gute Kriterien, der Unterschied zwischen Wahrscheinlichkeit und Konfidenz und warum Dutzende Fragen in einen Aufruf gehören.