LongCat 2.5 Preview und die KI-Wettbewerber
8 Min. Lesezeit
Meituan hat LongCat-2.5-Preview veröffentlicht und das Rennen um offene Gewichte ist wieder heiß. Die Familie ist von einer hausinternen Forschungslinie rund um agentisches Codieren mit langem Kontext zu einem Ökosystem geworden, das offizielle Anleitungen für zwölf verschiedene Werkzeuge veröffentlicht.
Die eigentliche Geschichte dieser Nachricht sind nicht die Fähigkeiten eines einzelnen Modells, sondern eine strukturelle Verschiebung. Drei Dinge stimmen gleichzeitig: Ein Kontextfenster von einer Million Tokens ist kein unterscheidendes Merkmal mehr, Denkmodi werden optional, und Modelle mit offenen Gewichten holen die Modelle geschlossener Spitzenmodelle beim Preis ein.
Dieser Artikel bringt drei Dinge zusammen: die Benchmark-Werte, die LongCat selbst veröffentlicht hat, die technischen Daten aller beteiligten Modelle und die Frage, wie diese Werte zu lesen sind.
Mit einer Warnung vorab: Das ist ein Nachrichtenbericht, kein unabhängiger Test. Die Werte unten stammen aus der Model-Card von LongCat und sind Messungen von LongCat selbst. Ein erheblicher Teil der Vergleichsspalten wurde jedoch gar nicht von LongCat gemessen, sondern aus den Berichten der Wettbewerber zitiert. Warum dieser Unterschied wichtig ist, erkläre ich in der Mitte des Artikels.
Die veröffentlichte Benchmark-Tabelle
LongCat veröffentlicht in seiner Model-Card eine Tabelle, die das Modell mit Rivalen vergleicht. Ich übernehme sie unverändert, weil der häufigste Fehler in einem Nachrichtenbericht das Umformen der Quellentabelle ist:
| Benchmark | LongCat-2.0 | Gemini 3.1 Pro | GPT-5.5 | Claude Opus 4.6 | Claude Opus 4.7 | Claude Opus 4.8 |
|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 70.8 | 70.7* | 73.8* | - | 71.7* | 78.9* |
| SWE-bench Pro | 59.5 | 54.2* | 58.6* | 57.3* | 64.3* | 69.2* |
| SWE-bench Multilingual | 77.3 | 76.9* | - | 77.8* | 80.5* | 84.8* |
| FORTE | 73.2 | 70.3 | 77.8 | 73.2 | 77.6 | 77.2 |
| BrowseComp | 79.9 | 85.9* | 84.4* | 84.0* | 79.3* | 84.3* |
| RWSearch | 78.8 | 76.3 | 85.3 | 81.3 | 79.3 | 77.3 |
| IFEval | 90.0 | 96.1 | 95.0 | 92.2 | 88.7 | 86.0 |
| Writing Bench | 83.8 | 83.7 | 84.7 | - | 85.3 | 85.2 |
| IMO-AnswerBench | 81.8 | 90.0 | 79.5 | 75.3* | 81.8 | 75.3 |
| GPQA-diamond | 88.9 | 94.3* | 93.6* | 91.3* | 94.2* | 92.4* |
LongCats eigener Hinweis: Das Sternchen (*) bedeutet "aus dem offiziellen Bericht dieses Modells zitiert". LongCats Werte wurden also intern gemessen, die Werte der Wettbewerber stammen aus deren eigenen Messungen.
Wie man diese Tabelle liest
In Nachrichtenberichten wird eine Benchmark-Tabelle meist als Rangliste präsentiert. Das wäre hier irreführend, denn die Sternchen markieren genau den schwächsten Punkt des Vergleichs.
Das Problem: LongCats Wert wurde auf eigener Hardware, in eigener Harness und mit eigener Prompt-Vorlage gemessen. Der Wert des Wettbewerbers wurde auf dessen Hardware, in dessen Harness gemessen. Diese beiden Messungen stammen nicht aus demselben Labor. Dasselbe Modell an zwei Orten zu betreiben ergibt nicht denselben Wert; das ist eine Eigenschaft der Messung, nicht des Modells.
Das zweite Problem: Einige Wettbewerber-Zellen sind leer. In der Spalte Claude Opus 4.6 steht für Terminal-Bench ein "-", also "kein vergleichbarer öffentlicher Wert". LongCat kannte den Wert dort nicht, was für Zurückhaltung spricht statt für einen Punkt im eigenen Sinn.
Das dritte und wichtigste Problem: Die Zeilen gehen nicht in eine Richtung. LongCat liegt bei manchen Coding- und Agent-Zeilen vorn und bei anderen hinten. Bei Terminal-Bench 2.1 ist es zehn Punkte hinter Claude Opus 4.8, bei FORTE drei Punkte vor Gemini 3.1 Pro. Bei IFEval sind die 90,0 der zweithöchste Wert der Tabelle, bei GPQA-diamond gehören die 88,9 zu den niedrigsten.
Diese gemischte Tabelle liefert die eigentliche Botschaft: LongCat ist kein auf ein Gebiet spezialisiertes Modell, sondern eines, das im selben breiten Band wie seine Rivalen liegt. Niemand kann sagen "LongCat hat Codex geschlagen" oder "LongCat führt bei Deep Research". Die korrekte Formulierung lautet: bei Coding-Agenten wettbewerbsfähig, bei grundlegendem Reasoning zurück.
Ist das Rennen um langen Kontext vorbei
Sehen Sie sich die Spezifikationstabelle an:
| Modell | Kontext | Maximale Ausgabe | Eingabeformate | Ein $ / Mio. | Aus $ / Mio. |
|---|---|---|---|---|---|
LongCat-2.5-Preview |
1.048.576 | 131.072 | Text, Bild | 0,30 $ | 1,20 $ |
meituan/longcat-2.0 |
1.048.756 | 262.144 | Text | 0,30 $ | 1,20 $ |
openai/gpt-6-luna |
1.050.000 | 128.000 | Text, Bild, Dateien | 0,10 $ | 0,50 $ |
google/gemini-3.8-flash |
1.048.576 | 65.536 | Text, Bild, Video, Dateien, Audio | 0,75 $ | 3,75 $ |
anthropic/claude-opus-5.5 |
1.000.000 | 128.000 | Text, Bild, Dateien | 4,00 $ | 20,00 $ |
stealth/space-bunny-alpha |
1.000.000 | 524.288 | Text, Bild, Video | 0 $ | 0 $ |
Alle sechs Modelle bieten ein Kontextfenster um eine Million Tokens. Das bestätigt die Beobachtung aus dem Vergleichsartikel: Eine Million Tokens ist kein Merkmal mehr, sondern eine Erwartung. Der Wettbewerb ist von der Größe des Fensters dazu gewandert, wie das Modell es nutzt.
LongCats Unterschied liegt nicht im Fenster, sondern im Mechanismus dahinter. Sparse Attention erlaubt die Nutzung eines 1M-Fensters, ohne jedes Tokenpaar zu vergleichen. Das im 1M-Kontext-Artikel beschriebene Problem der quadratischen Kosten schrumpft, wenn Sparse Attention vorhanden ist. Das Fenster ist gleich, die Kosten nicht.
Die Front der Denkmodi
Das ist die sichtbarste Veränderung der letzten Monate. Es gibt drei Ansätze:
Nicht abschaltbares Reasoning. Space Bunny Alpha macht es verpflichtend, mit max als Standardstufe. Auch Claude Opus 5.5 lässt es nicht abschalten, steht aber standardmäßig auf high. Gewünscht bei langen Antworten, unnötig bei einfachen Aufgaben.
Optionales Reasoning. LongCat-2.5-Preview akzeptiert thinking als enabled oder disabled, standardmäßig enabled. Auch Gemini 3.8 Flash lässt es nicht abschalten. Für jemanden, der ein Produktionssystem baut, ist das das nützlichste Verhalten: Man kann es für einfache Klassifikation abschalten und der Latenz entkommen.
Abschaltbares Reasoning. GPT-6 Luna bietet eine Stufe none und steht standardmäßig auf medium. Sie entscheiden pro Aufruf statt pro Modell.
Praktisches Ergebnis: Bei langlebigen Agentenschleifen trägt die Frage "welches Werkzeug wähle ich" aus dem Vibe-Coding-Artikel jetzt eine zusätzliche Frage: Wie viel Denken lassen Sie beim gewählten Modell zu? Das pro Runde abgestimmte Denkniveau ist die verallgemeinerte Fassung dessen, was der Agenten-Artikel im Beispiel tut.
Die Preisfront
Rechnen wir dasselbe Szenario für alle sechs Modelle. Eine Runde mit 200.000 Eingabetokens und 50.000 Ausgabetokens, dreißig Runden im Monat:
| Modell | Pro Runde | Monatlich | Monatlich mit Zwischenspeicher |
|---|---|---|---|
stealth/space-bunny-alpha |
0,00 $ | 0,00 $ | 0,00 $ |
openai/gpt-6-luna |
0,045 $ | 1,35 $ | 1,20 $ |
LongCat-2.5-Preview |
0,1200 $ | 3,60 $ | 1,76 $ |
google/gemini-3.8-flash |
0,3375 $ | 10,13 $ | 10,13 $ |
anthropic/claude-opus-5.5 |
1,80 $ | 54,00 $ | 53,65 $ |
Die letzte Spalte ist die wirkliche Version von LongCat dank des Preises für Zwischenspeicherung: 1,76 $ statt 3,60 $. Auch GPT-6 Luna hat einen Zwischenspeicherpreis, die Senkung dort fällt geringer aus.
Diese Reihenfolge vervollständigt den dritten Teil der Geschichte. Der Preisvorteil geschlossener Spitzenmodelle verlagert sich bei den Vorschauversionen zu einem Preisvorteil offener Modelle. Während Claude Opus 5.5 monatlich 54 $ kostet, bietet LongCat-2.5-Preview denselben Kontext für 1,76 $. Das ist kein Preiskrieg, sondern ein Wechsel der wirtschaftlichen Klasse.
Eine Einschränkung in einem Satz: LongCats 0,30 $ sind ebenfalls als befristeter Rabatt gelistet. Wie der Space-Bunny-Alpha-Vergleich erklärt, ist die Preisliste von heute nicht die von morgen.
Die Transparenzfront
Hier ist LongCat gleichzeitig am stärksten und am schwächsten.
Stark: LongCat ist ein Unternehmen, also ein rechtlich identifizierbarer Ansprechpartner. Es gibt eine Model-Card, eine offene Lizenz (MIT), einen technischen Blog und ein GitHub-Repository. Die Architektur eines Modells mit 1,8 Billionen Parametern ist als Sparse Attention plus N-gram-Embedding erklärt. Die quantisierten Versionen von LongCat-2.0 sind herunterladbar.
Schwach: Für LongCat-2.5-Preview sind die Gewichte nicht veröffentlicht. "LongCat ist Open Source" ist also ohne Nennung der Version nicht korrekt. Die Wirklichkeit heute ist, dass die Vorschau nur über die API erreichbar ist.
Auf der anderen Seite ist die Lage von Space Bunny Alpha genau umgekehrt: Preis null, eine Million Kontext, Videoeingabe, aber kein Unternehmen, keine Lizenz, keine Gewichte und kein Wissensstand.
Also zwei Extreme auf derselben Achse:
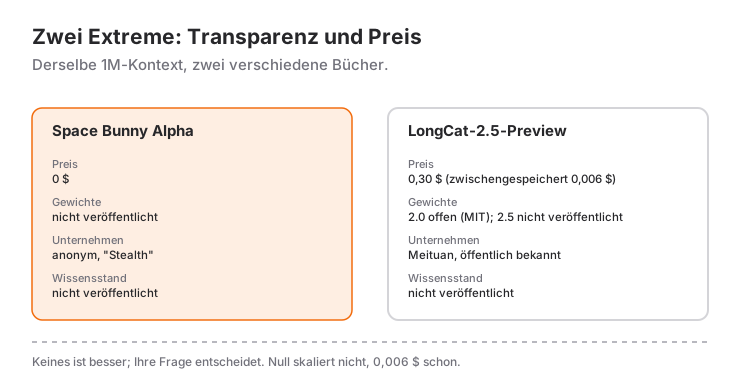
| Transparenz | Preis | Kontext | Bild/Video | |
|---|---|---|---|---|
| Space Bunny Alpha | keine | 0 $ | 1M | Text, Bild, Video |
| LongCat-2.5-Preview | begrenzt (keine Gewichte) | 0,30 $ | 1M | Text, Bild |
Deshalb hängt die Frage "welches ist besser" nicht am Modellnamen, sondern an der Frage, die Sie stellen. Die im JEV-Artikel beschriebene Trennung gilt auch hier: Ein Modell ist eine Funktion, die Text entgegennimmt und Text zurückgibt, und wofür Sie es einsetzen, ist Ihre Entscheidung.
Was diese Nachricht bedeutet
In drei Sätzen:
Erstens. Ein langer Kontext hat seinen Status als erstklassiges Merkmal verloren. Sechs von sechs Rivalen bieten eine Million Tokens. Die Frage lautet nicht mehr "wie viele Tokens", sondern "welcher Mechanismus wählt diese Tokens aus".
Zweitens. Die Denkstufe ist zu einer neuen Kostenposition geworden. Eine lange Agentenschleife zu bauen, ohne reasoning_effort oder thinking zu setzen, heißt, die eigene Abrechnung zu raten.
Drittens. Modelle mit offenen Gewichten haben bei Kontext und multimodalen Fähigkeiten die geschlossenen Rivalen eingeholt; der Unterschied liegt jetzt bei Preis und Integrationsbreite. LongCats konkretester Gewinn ist dieser: offizielle Anleitungen für zwölf Werkzeuge zu veröffentlichen ist nützlicher als jede technische Spezifikation.
Quellen
- Hugging Face: Model-Card meituan-longcat/LongCat-2.0 (Benchmark-Tabelle und Erklärung zum Sternchen, Sparse Attention, N-gram-Embedding, MIT-Lizenz)
- LongCat-Preise: LongCat-2.5-Preview (zwischengespeicherte Eingabe 0,006 $, unzwischengespeichert 0,30 $, Ausgabe 1,20 $)
- LongCat-API-Dokumentation: Retrieve Model (Kontextlänge, unterstützte Parameter,
thinking) - Vercel AI Gateway: LongCat 2.5 Preview (maximale Ausgabe, Modellkennung, multimodale Beschreibung)
- OpenRouter-Modell-API (Kontext, Preis, Eingabeformate und Reasoning-Stufen der Wettbewerber)
- LongCat-Werkzeugleitfäden (Claude Code, Codex, opencode, Cline und weitere Integrationen)
Verwandte Artikel
LongCat 2.5 Preview installieren: News und Anleitung
Meituan hat LongCat-2.5-Preview veröffentlicht: 1M Kontext, Bildeingabe, optionaler Denkmodus, 0,006 $ im Zwischenspeicher. Hier die Einrichtung.
Space Bunny Alpha im Vergleich mit anderen KI-Agenten
Space Bunny Alpha verglichen mit Claude, GPT, Gemini und kostenlosen offenen Modellen: Preis, 1M Kontext, multimodale Eingabe und Agentenfähigkeiten.
Space Bunny Alpha installieren: Schritt für Schritt
Space Bunny Alpha über OpenRouter einrichten: API-Schlüssel, erste Anfrage, Python und TypeScript, Bildeingabe, Open-Source-Agenten.