LongCat 2.5 Preview installieren: News und Anleitung
7 Min. Lesezeit
Meituan hat LongCat-2.5-Preview veröffentlicht, das neueste Mitglied der LongCat-Familie. Das Modell kommt mit einem Kontextfenster von 1.048.576 Tokens, Text- und Bildeingabe und einem optionalen Denkmodus. Der befristete Listenpreis liegt bei 0,30 $ je eine Million Eingabetokens und 1,20 $ je eine Million Ausgabetokens, und die wichtigste Zahl ist die zwischengespeicherte Eingabe mit 0,006 $.
Zusammen mit dem Space-Bunny-Alpha-Artikel ist das die zweite große Modellbewegung der letzten Wochen. Es gibt aber einen wichtigen Unterschied: Space Bunny Alpha hat keine Gewichte, LongCat schon. Die Gewichte von LongCat-2.0 liegen auf Hugging Face unter der MIT-Lizenz, samt 8-Bit- und 4-Bit-quantisierter Versionen. Das "Installieren" beschränkt sich diesmal also nicht auf einen entfernten API-Aufruf.
Zuerst die Nachricht selbst, dann die Einrichtung Schritt für Schritt.
Dieser Artikel ist als Nachrichtenbericht geschrieben und enthält keinen Praxistest. Alle technischen Werte stammen aus der API-Dokumentation von LongCat, der Modellseite der Vercel AI Gateway und der Model-Card der offenen Gewichte. Die Quellen stehen am Ende.
Die Nachricht in Kürze
| Eigenschaft | Wert |
|---|---|
| Modellkennung | LongCat-2.5-Preview |
| Entwickler | Meituan (LongCat-Familie) |
| Versionsstatus | Vorschau (Preview) |
| Kontextfenster | 1.048.576 Tokens |
| Maximale Ausgabe | 131.072 Tokens |
| Eingabeformate | Text, Bild |
| Denkmodus | optional, standardmäßig aktiv |
| Preis Eingabe (pro Mio. Tokens) | 0,30 $ |
| Zwischengespeicherte Eingabe (pro Mio. Tokens) | 0,006 $ |
| Preis Ausgabe (pro Mio. Tokens) | 1,20 $ |
| Eigene API-Basis | https://api.longcat.chat/openai/v1 |
| Zweite kompatible Basis | https://api.longcat.chat/anthropic/v1 |
| Kennung in der Vercel AI Gateway | meituan/longcat-2.5-preview |
Wer LongCat ist
LongCat ist der Name der Modellfamilie von Meituan. Die Familie begann als hausinterne Forschungslinie für Reasoning über langen Kontext, agentisches Codieren und skalierbare KI-Systeme. Unter dem Namen LongCat gibt es heute Modelle für langen Kontext, Vision-Modelle, Audio- und Videoerzeugung sowie Werkzeuge für Deep Research.
Zwei technische Entscheidungen unterscheiden diese Familie von anderen Modellen mit offenen Gewichten.
Sparse Attention (LongCat Sparse Attention). Bei einem Kontext von einer Million Tokens liegt der eigentliche Engpass im Vergleich jedes Tokenpaares. LongCat Sparse Attention senkt diese Kosten durch eine dreistufige Auswahl: hardwareausgerichteter sequenzieller Zugriff, über Schichten hinweg geteilte Indexierung und ein zweistufiges Scoring von grob nach fein. Anders gesagt: Das Modell liest nicht alles, es wählt aus, was es lesen muss.
N-gram-Embedding. Weil "die Sparsität von MoE den Sweet Spot überschritten hat", besitzt das Modell eine 135 Milliarden Parameter große N-gram-Embedding-Schicht, die mit reinem MoE derselben Größe konkurriert. Sie erfasst die repetitiven Muster von Quellcode und spart Speicher.
Beide Entscheidungen zeigen in dieselbe Richtung: Sie wurden für Codierung und Langzeitaufgaben getroffen. Langer Kontext ist hier kein Nebenmerkmal, sondern das Designziel.
Was LongCat-2.5-Preview mitbringt
Zwei konkrete Änderungen stechen im Vergleich zur vorherigen Version hervor.
Bildeingabe. LongCat-2.0 akzeptierte nur Text. Die Vorschau verbindet Bildverständnis, visuelle Fragebeantwortung und Inhaltszusammenfassung mit Textgenerierung in einem Modell. Damit lässt sich ein Agent bauen, der einen Screenshot liest und mit einem einzigen Modell Code schreibt.
Optionaler Denkmodus. Der lange Reasoning-Schritt wird über das Feld thinking im Anfragekörper gesteuert:
{ "thinking": { "type": "enabled" } }Ausgeschaltet wird er mit {"type":"disabled"}, standardmäßig kommt er an. Das ist genau das Gegenteil zum nicht abschaltbaren Reasoning von Space Bunny Alpha. Zwischen zwei Modellen, die dieselbe Arbeit machen, schlägt sich dieser Unterschied bei einfachen Aufgaben direkt als Latenz nieder.
Das Kontextfenster beträgt 1.048.576 Tokens, fast identisch mit Space Bunny Alpha, aber die Ausgabegrenze ist niedriger: 131.072 Tokens.
Die eigentliche Geschichte im Preis: Zwischenspeicherung
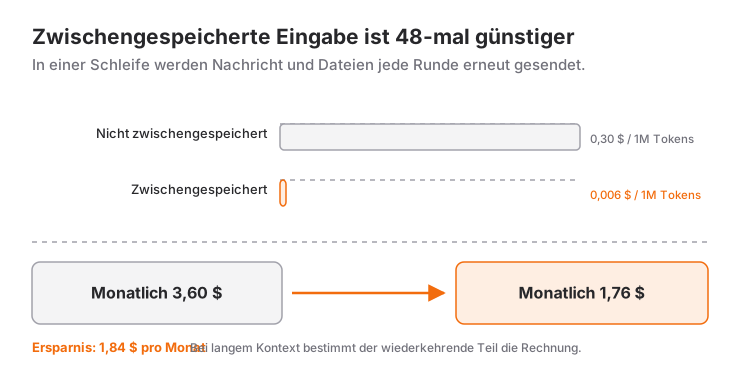
Die 0,30 $ für Eingabe wirken auf den ersten Blick gewöhnlich. Die Zahl, die Aufmerksamkeit verdient, sind die 0,006 $ für zwischengespeicherte Eingabe, also achtundvierzig Mal günstiger.
Warum ist das wichtig? In einer Agentenschleife werden dieselbe Systemnachricht, dieselben Werkzeugschemata und dieselben Dateiinhalte in jeder Runde erneut gesendet. In der Achtrunden-Schleife, die wir gebaut haben, wächst die Nachrichtenhistorie ständig. Zwischengespeicherte Eingabe bedeutet, dass dieser wiederkehrende Teil fast nichts kostet.
Rechnen wir. Eine Runde mit 200.000 Eingabetokens und 50.000 Ausgabetokens:
| Szenario | Eingabekosten | Ausgabekosten | Runde gesamt |
|---|---|---|---|
| Nicht zwischengespeichert | 0,0600 $ | 0,0600 $ | 0,1200 $ |
| Vollständig zwischengespeichert | 0,0012 $ | 0,0600 $ | 0,0612 $ |
Das sind 0,0588 $ gespart bei denselben 200.000 Eingabetokens. Über dreißig Runden im Monat, also ein paar Stunden aktiver Arbeit, spart allein die Zwischenspeicherung 1,76 $. Da der Modellpreis selbst 0,30 $ beträgt, ist die Zwischenspeicherung der größte Einzelposten für jeden, der einen Agenten mit 1M Kontext baut.
Neben die Tabelle im Vergleichsartikel gestellt wird es noch interessanter: Der zwischengespeicherte Preis von LongCat ist streng genommen "teurer" als die null Dollar von Space Bunny Alpha, aber es ist eine skalierbare Zahl. Null skaliert nicht, 0,006 $ schon.
Schritt 1: API-Schlüssel holen
Sie brauchen ein Konto auf der API-Plattform von LongCat, um einen Schlüssel zu erhalten. Schlüssel werden unter longcat.chat/platform/api_keys ausgestellt.
export LONGCAT_API_KEY="lc-..."Schreiben Sie den Schlüssel nicht in eine Datei. Alle Beispiele unten lesen ihn aus der Umgebungsvariable LONGCAT_API_KEY.
Schritt 2: Erste Anfrage mit curl
LongCat stellt zwei kompatible Endpunkte bereit. Beginnen wir mit dem OpenAI-kompatiblen:
curl https://api.longcat.chat/openai/v1/chat/completions \
  -H "Authorization: Bearer $LONGCAT_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "LongCat-2.5-Preview",
    "messages": [
      { "role": "user", "content": "Was ist LongCat-2.5-Preview in einem Satz?" }
    ]
  }'
Die Antwort kommt in OpenAI-Form: Text in choices[0].message.content, Tokenzahlen und Kosten in usage.
Auch die Modelldetails lassen sich abfragen:
curl https://api.longcat.chat/openai/v1/models/LongCat-2.5-Preview \
  -H "Authorization: Bearer $LONGCAT_API_KEY"
Dieser Aufruf liefert Kontextlänge, unterstützte Parameter und Preise. Die Fähigkeiten eines Modells von diesem Endpunkt zu lesen ist immer korrekter, als sie zu vermuten.
Schritt 3: Python und TypeScript
Auf der Client-Seite ändert sich nur die Basis-URL:
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LONGCAT_API_KEY"],
    base_url="https://api.longcat.chat/openai/v1",
    timeout=180.0,
    max_retries=2,
)

response = client.chat.completions.create(
    model="LongCat-2.5-Preview",
    messages=[{"role": "user", "content": "Was ist LongCat-2.5-Preview in einem Satz?"}],
    extra_body={"thinking": {"type": "enabled"}},
)

print(response.choices[0].message.content)
print("Kosten:", response.usage.cost)
import OpenAI from "openai";
const client = new OpenAI({
apiKey: process.env.LONGCAT_API_KEY,
baseURL: "https://api.longcat.chat/openai/v1",
timeout: 180_000,
maxRetries: 2,
});
const completion = await client.chat.completions.create({
model: "LongCat-2.5-Preview",
messages: [{ role: "user", content: "Was ist LongCat-2.5-Preview in einem Satz?" }],
thinking: { type: "enabled" },
});
console.log(completion.choices[0]?.message?.content);Das Feld thinking gibt es im Standard-OpenAI-Schema nicht, deshalb muss es auf der Python-Seite durch extra_body.
Schritt 4: In Coding-Werkzeuge einbinden
LongCats stärkste Seite ist nicht die einfache Installation, sondern die Breite der Integrationen. Die offizielle Dokumentation veröffentlicht eigene Anleitungen für Claude Code, Codex, opencode, Cline, Kilo Code, Cherry Studio, Chatbox, CodeBuddy, OpenClaw, Hermes Agent, CC Switch und WorkBuddy. Diese Liste ist für sich ein Zeichen eines Ökosystems um ein Modell herum.
opencode. Der LongCat-Anbieter ist in opencode fest eingebaut, eine manuelle Konfiguration ist nicht nötig:
opencode auth loginWählen Sie in der Anbieterliste LongCat und fügen Sie den Schlüssel ein. Er wird gespeichert unter:
- macOS / Linux:
~/.local/share/opencode/auth.json - Windows:
%USERPROFILE%\.local\share\opencode\auth.json
Um das Denken abzuschalten, bearbeiten Sie ~/.config/opencode/opencode.json:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "longcat": {
      "models": {
        "LongCat-2.5-Preview": {
          "options": {
            "thinking": {
              "type": "disabled"
            }
          }
        }
      }
    }
  }
}
Claude Code. LongCat bietet unter /anthropic/v1 auch einen Anthropic-kompatiblen Endpunkt. Damit können sich Werkzeuge, die das Anthropic-Format erwarten, direkt verbinden, sodass Sie das Modell wechseln können, ohne Ihren Ablauf anzufassen. Details finden Sie im Claude-Code-Leitfaden von LongCat.
Vercel AI Gateway. Wenn Sie OpenRouter nicht nutzen, lässt sich das Modell auch über die Vercel AI Gateway unter meituan/longcat-2.5-preview aufrufen. Dasselbe Modell, eine andere Vermittlungsschicht.
Die Realität des lokalen Betriebs
Das ist die meistgestellte Frage, und die Antwort ist etwas überraschend.
Die Gewichte von LongCat-2.0 sind offen: Sie liegen unter meituan-longcat/LongCat-2.0 auf Hugging Face mit MIT-Lizenz, 1,8 Billionen Parameter, BF16- und F32-Tensor-Typen. Es gibt außerdem LongCat-2.0-FP8 und LongCat-2.0-INT8 in quantisierter Form. Die Model-Card liefert Installationsanleitungen für vLLM, SGLang und Transformers:
pip install vllm
vllm serve "meituan-longcat/LongCat-2.0"
Die Zahlen sind hier wichtig. 1,8 Billionen Parameter sind bei BF16 etwa 3,6 Terabyte Gewichte. FP8 halbiert das. Das Vorhandensein quantisierter Versionen sollte nicht die Erwartung einer Ein-GPU-Installation wecken: Es bleibt eine Installation über mehrere Karten.
Für LongCat-2.5-Preview sind die Gewichte nicht veröffentlicht. "LongCat ist Open Source" ist also ohne Nennung der Version nicht korrekt. Die langfristige Richtung scheint so zu sein, doch die Wirklichkeit heute ist, dass die Vorschau nur über die API erreichbar ist.
Für wen lohnt es sich
Wenn Sie einen Agenten mit langem Kontext zum Codieren bauen: Dafür wurde LongCat entworfen. Ein Kontextfenster von einer Million Tokens, Sparse Attention und ein Preis für zwischengespeicherte Eingaben machen die Kosten einer langen Sitzung handhabbar.
Wenn Sie ein Werkzeug im Stil von Claude Code nutzen: Der Anthropic-kompatible Endpunkt erlaubt den Modellwechsel ohne Eingriff in Ihren Ablauf.
Wenn die Kosten null sein müssen: LongCat ist nicht die Antwort. Die Null-Dollar-Preise von Space Bunny Alpha passen besser zu diesem Fall, skalieren aber nicht.
Wenn Sie es in der Produktion auf dem eigenen Server betreiben wollen: Sehen Sie sich die Gewichte von LongCat-2.0 an, rechnen Sie aber die Hardware durch. Für 2.5 gibt es diese Möglichkeit noch nicht.
Und vergessen Sie nicht, dass dies eine Vorschau ist. Das Etikett Preview im Versionsnamen bedeutet, dass dieselbe Kennung morgen auf ein anderes Modell zeigen kann. Der Space-Bunny-Alpha-Vergleich erklärt ausführlich, warum Vorschau-Etiketten wichtig sind.
Quellen
- LongCat-API-Dokumentation: Retrieve Model (Endpunkt für Modelldetails, unterstützte Parameter,
thinking) - LongCat-Preise: LongCat-2.5-Preview (zwischengespeicherte und unzwischengespeicherte Eingabe, Ausgabepreise)
- LongCat-Leitfaden: opencode (eingebauter Anbieter, Pfad zu
auth.json, Konfiguration des Denkmodus) - Vercel AI Gateway: LongCat 2.5 Preview (Kontextfenster, maximale Ausgabe, Modellkennung)
- Hugging Face: meituan-longcat/LongCat-2.0 (Sparse Attention, N-gram-Embedding, MIT-Lizenz, vLLM/SGLang-Anleitung, quantisierte Versionen)
- LongCat-Werkzeugleitfäden (Claude Code, Codex, Cline und weitere Integrationen)
Verwandte Artikel
LongCat 2.5 Preview und die KI-Wettbewerber
Meituan, LongCat-2.5-Preview und seine Rivalen: veröffentlichte Benchmark-Werte, Preis, Kontext, Denkmodus und die Frage der Transparenz.
Space Bunny Alpha installieren: Schritt für Schritt
Space Bunny Alpha über OpenRouter einrichten: API-Schlüssel, erste Anfrage, Python und TypeScript, Bildeingabe, Open-Source-Agenten.
Space Bunny Alpha im Vergleich mit anderen KI-Agenten
Space Bunny Alpha verglichen mit Claude, GPT, Gemini und kostenlosen offenen Modellen: Preis, 1M Kontext, multimodale Eingabe und Agentenfähigkeiten.