Space Bunny Alpha: 1M Kontext und multimodale Eingabe
6 Min. Lesezeit
Die beiden auffälligsten Zahlen von Space Bunny Alpha stehen direkt nebeneinander: ein Kontextfenster von einer Million Tokens und Bild- plus Videoeingabe. Zusammen ergeben das eine Kombination, die die meisten anderen Modelle nicht bieten.
Die Größe der Zahlen allein sagt Ihnen aber nicht, was Sie damit anfangen können. Eine Million Tokens bedeutet "ein sehr großes Fenster"; was in dieses Fenster passt und was nicht, hängt davon ab, was Sie hineingeben. Dieser Artikel rechnet aus, was tatsächlich hineinpasst, erklärt das geteilte Budget und zeigt den praktischen Weg, das Token-Budget zu messen und zu verwalten.
Die Einrichtung selbst steht in einem eigenen Artikel; der Funktionsvergleich mit anderen Modellen im Vergleichsartikel.
Wie viel fasst eine Million Tokens?
Das hängt von der Sprache ab. Und hier ist Ehrlichkeit nötig: Der Tokenizer von Space Bunny Alpha wurde nicht veröffentlicht. OpenRouter meldet dieses Feld als Other, wir kennen also weder Namen noch Regeln. Die folgenden Zahlen sind deshalb Näherungen; die echte Zahl erfahren Sie nur, indem Sie die Anfrage senden und das Feld usage auslesen. Ganz am Ende dieses Artikels steht, wie das geht.
Für englischen Fließtext gilt als grobe Regel etwa vier Zeichen pro Token:
| Inhalt | 1M Tokens sind ungefähr |
|---|---|
| Englischer Fließtext | 750.000 Wörter, etwa 4 Millionen Zeichen |
| Türkischer Fließtext | 400.000 bis 500.000 Wörter |
| Dart-, Swift- oder C#-Quellcode | 55.000 bis 80.000 Zeilen |
| Typische Quelldatei (200-400 Zeilen) | 150 bis 400 Dateien |
| Markdown-Dokumentation | 25.000 bis 40.000 Zeilen |
Der Abstand zwischen Türkisch und Englisch überrascht, ist aber real. Suffixe und lange Wörter zerfallen in mehr Tokens, dieselbe Zeichenzahl kostet also mehr. Ein türkisches Projekt in dasselbe Kontextbudget zu pressen wie ein englisches ist entsprechend teurer.
Die Zahlen können atemraubend groß wirken, aber praktisch löst das "Kontextgrenze"-Problem aus dem opencode-Artikel dieses Modell nicht. Der Grund ist einfach: Ein Projekt mit 400 Dateien in das Fenster zu pressen und es zu verstehen sind zwei verschiedene Dinge.
Warum 1M Kontext nicht alles löst
Es gibt vier konkrete Gründe.
Latenz. Aufmerksamkeit skaliert nicht mit der Tokenzahl, sondern mit der Zahl der Vergleiche zwischen Tokenpaaren. Das Verdoppeln des Kontexts vervielfacht die Arbeit quadratisch. 1M Tokens zu erreichen ist deutlich langsamer als 100.000. In einer langen Sitzung ist das das Erste, was in der Oberfläche auffällt.
Aufmerksamkeit verliert sich. Hinweise, die in einem langen Kontext vergraben sind, können am Modell vorbeirutschen. Hundert Seiten Code mit "behebe nur den Fehler in Zeile 40" zu prüfen ist eine andere Aufgabe, als ihn mit "debugge und erkläre" zu prüfen. Ihre Anweisung am Ende des Kontextes zu platzieren wirkt merklich besser als am Anfang.
Ein volles Fenster ist kein nützliches Fenster. Das Fenster zu füllen ist kein Ziel. Zehntausend sachfremde Zeilen hineinzulegen ergibt ein schlechteres Ergebnis als die richtigen fünfhundert. Kapazität ist nicht zum Ausgeben da.
Die Kosten sind nicht immer noch null. Für dieses Modell stimmt das; für die anderen mit demselben Fenster nicht. In der Rechnung aus dem Vergleichsartikel kam gpt-6-luna auf 1,35 $ im Monat. Ein größerer Kontext ist eine Entscheidung, die die Rechnung direkt vergrößert.
Praktische Schlussfolgerung: Bewahren Sie die Million Tokens für Arbeiten auf, die wirklich so viel kosten. Das sind meistens das Lesen einer ganzen Codebasis mit anschließender Änderung, das Scannen langer Dokumentation oder das gemeinsame Deuten von Dutzenden Screenshots.
Ein geteiltes Budget: Text, Bild und Video
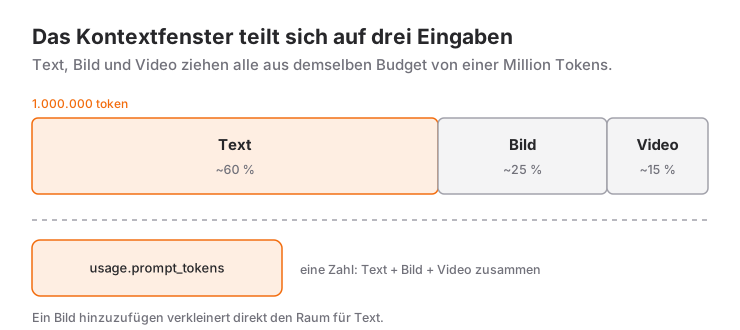
Das Eingabeformat lautet text + image + video. Der entscheidende Punkt: Eine Million Tokens ist ein einziges Budget, das alle drei teilen. Ein Bild hinzuzufügen verkleinert den Raum, der für Text bleibt.
Die Tokenkosten eines Bildes hängen grob an zwei Parametern: Auflösung und Kachelung. Ein hochauflösender Screenshot kostet weit mehr Tokens als eine kleine Version derselben Szene. In einer Fehlersuche können unbeschnittene Screenshots so viel Kontext verbrauchen wie das Problem selbst.
Das folgende Python-Beispiel ist der günstigste Weg, nach einer Anfrage zu messen, was Sie tatsächlich verbraucht haben:
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="stealth/space-bunny-alpha",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Erklären Sie die Fehlermeldung in diesem Screenshot."},
            {
                "type": "image_url",
                "image_url": {"url": "https://example.com/fehler.png"},
            },
        ],
    }],
)

usage = response.usage
print("Eingabetokens :", usage.prompt_tokens)
print("Ausgabetokens :", usage.completion_tokens)
print("Kosten        :", usage.cost)
Das Feld usage.prompt_tokens liefert die gemeinsamen Tokenkosten von Text und Bild. Derselbe Prompt mit und ohne Bild zeigt Ihnen in einer Messung, was ein Screenshot kostet.
Videoeingabe
Videoeingabe wird unterstützt, mit einem Haken: Die Tokenkosten der Videoframes werden aus dem Kontext bezahlt. Ein Video zu senden, das das gesamte Budget von einer Million Tokens füllt, lässt dem Modell keinen Raum für Text.
In der Praxis wird das Video deshalb selbst verarbeitet und es werden Frames ausgewählt. Ein typischer Ablauf:
- Video in Frames zerlegen.
ffprobeliefert die Bildrate. - Eine gleichmäßig verteilte Teilmenge auswählen. Das erhält die Information und senkt die Tokenkosten linear.
- Die Frames zu einem Bild zusammenlegen und dieses eine Bild an das Modell senden.
Das vollständige Extrahieren und Zusammenlegen der Frames steht im Artikel zum Zusammenfügen von Videos. Das Layout dort erzeugt ein einzelnes Frame-Raster, das ein langes Vlog zusammenfasst.
# 0,5 Bilder pro Sekunde: alle zwei Sekunden ein Frame
ffmpeg -i video.mp4 -vf "fps=0.5" frame-%04d.png
Dieser Weg hat einen Nebennutzen: Weil Sie die Umwandlung selbst übernehmen, wissen Sie genau, welche Frames hinausgegangen sind und was sie gekostet haben. Das Hochladen von Rohvideo überlässt diese Kontrolle dem Modell.
Das Token-Budget verwalten
Vier praktische Regeln:
Nicht rechnen, messen. Weil der Tokenizer nicht veröffentlicht ist, ist ein Offline-Zähler nicht verlässlich. usage.prompt_tokens zu lesen ist schneller und genauer als Schätzen. Messen Sie mit einer einzigen Anfrage, bevor Sie Aufwändiges bauen.
Setzen Sie die Anweisung ans Ende. Eine Anweisung in der Mitte eines langen Kontexts wird deutlich häufiger übersehen als eine am Ende. Wenn Sie ein langes Dokument senden und eine Operation darauf wollen, hängen Sie die Anweisung zuletzt an.
Wiederholen Sie die Einschränkung, nicht den Kontext. Dieselbe Vorgabe dreimal zu schreiben kostet weit weniger, als zweitausend Zeilen dreimal zu senden.
Setzen Sie die Ausgabegrenze bewusst. Die maximale Ausgabe beträgt 524.288 Tokens, also fast die Größe des Kontextfensters selbst. Ohne Begrenzung kann das Modell sehr lange Antworten produzieren. Wenn Sie keine lange Antwort wollen, begrenzen Sie mit max_tokens:
-d '{
    "model": "stealth/space-bunny-alpha",
    "messages": [{ "role": "user", "content": "Fassen Sie diese Klasse zusammen." }],
    "reasoning_effort": "low",
    "max_tokens": 800
  }'
Auch Reasoning zieht vom Budget ab. Eine Anfrage mit reasoning_effort: max erhöht durch den Reasoning-Schritt sowohl die Latenz als auch die Zahl der Ausgabetokens. Für eine einfache Zusammenfassung ist low schneller und günstiger.
Wofür 1M Kontext wirklich gut ist
Vier Szenarien, in denen sich das Fenster wirklich verdient:
Eine Änderung über die ganze Codebasis. Ein Refactor über mehrere Dateien, oder alle Verwendungen eines Typs finden. Wenn 400 Dateien hineinpassen, hält der Agent eine Karte bereit, statt in jedem Schritt Dateien zu suchen.
Lange Dokumentation durchsuchen. Die vollständige Versionshistorie einer API lesen und eine einzelne Verhaltensänderung herausziehen.
Dutzende Screenshots. Herausfinden, an welcher Stelle ein Ablauf in einer mehrbildrigen Journey gebrochen ist. Das ist das eine Szenario, in dem die multimodale Seite des 1M-Fensters wirklich anspringt.
Massenhafte Klassifikation. Hunderte Datensätze in einer Anfrage sortieren. Der Wert liegt hier nicht im Kontext, sondern in der Konsistenz, die Sie mit response_format festschreiben.
Dagegen bringt kurze, gezielte Arbeit wie das Korrigieren einer einzelnen Funktion oder das Übersetzen eines Absatzes von einem 1M-Fenster gar nichts. Die Lösung für das im opencode-Artikel beschriebene "im mehrdateiligen Refactor stecken bleiben" ist nicht ein größerer Kontext, sondern ein Agent, der Dateien in sinnvoller Reihenfolge liest.
Quellen
- OpenRouter-Endpunktdetails: Space Bunny Alpha (Eingabeformate, maximale Ausgabe, Tokenizer-Feld,
max_tokens-Unterstützung) - OpenRouter-Modell-API (Tokenizer-Angabe, Kontextfenster, Reasoning-Stufen)
- OpenRouter-API-Dokumentation (
usage-Felder,max_tokens, multimodales Inhaltsformat)
Verwandte Artikel
Space Bunny Alpha im Vergleich mit anderen KI-Agenten
Space Bunny Alpha verglichen mit Claude, GPT, Gemini und kostenlosen offenen Modellen: Preis, 1M Kontext, multimodale Eingabe und Agentenfähigkeiten.
Space Bunny Alpha installieren: Schritt für Schritt
Space Bunny Alpha über OpenRouter einrichten: API-Schlüssel, erste Anfrage, Python und TypeScript, Bildeingabe, Open-Source-Agenten.
Einen KI-Agenten mit Space Bunny Alpha bauen
Vom Werkzeugschema bis zur Schleife: einen Coding-Agenten auf Space Bunny Alpha bauen, Werkzeugfehler zurückgeben, Ausgabe auf JSON festlegen.