Space Bunny Alpha im Vergleich mit anderen KI-Agenten
9 Min. Lesezeit
Die Einrichtung von Space Bunny Alpha ist Thema eines eigenen Artikels. Hier geht es um eine andere Frage: Wo steht es im Feld, was kann es besser als die Alternativen, und was kann es gar nicht?
Die ehrliche Antwort beginnt damit, wie neu das Modell ist. Beim Schreiben dieses Artikels war Space Bunny Alpha seit vier Tagen auf OpenRouter. Deshalb vorab eine Warnung: Der Vergleich unten beruht auf veröffentlichten technischen Spezifikationen, nicht auf einem unabhängigen Benchmark. Bewertungstabellen, Geschwindigkeitsmessungen und Aussagen der Art "X schlägt Y in Test Z" fehlen hier bewusst. Wenn Sie diese Messungen nicht selbst durchgeführt haben, kann sie niemand zuverlässig für Sie tun, und eine erfundene Rangliste würde den ganzen Artikel wertlos machen.
Was wir haben, ist Folgendes: OpenRouter veröffentlicht zu jedem Modell das Kontextfenster, den Preis, die akzeptierten Eingabeformate, die unterstützten API-Parameter und die Reasoning-Stufen. Diese Zahlen sind nicht diskutierbar und haben keine diskutierbare Seite. Ein Vergleich darauf aufzubauen ist ehrlicher und hält länger.
Der Rahmen für diesen Vergleich
Ich sehe mir fünf Fragen an:
- Preis. Was kostet ein Monat wirklich?
- Kontextfenster. Wie viele Tokens passen hinein?
- Eingabeformate. Text, Bild, Video, Audio, Dateien?
- Agentenfähigkeiten. Werkzeugaufrufe, strukturierte Ausgabe, Steuerung des Reasonings?
- Transparenz. Gewichte, Trainingsdaten, Wissensstand, Inhaltsfilter?
Die fünfte Frage wird in Modellvergleichen meist übersehen, ist hier aber die unterscheidendste. Wenn Sie nicht wissen, wer ein Modell gebaut hat, bleibt Ihnen auch nichts mehr, woran Sie sich halten können, wenn Sie wissen wollen, warum es genau diesen Code erzeugt hat.
Alle Daten stammen aus der Modell-API von OpenRouter vom 27. September 2026. Preise sind Listenpreise und können sich ändern.
Die Grunddaten
| Modell | Kontext | Maximale Ausgabe | Eingabeformate | Preis (Ein- / Ausgabe, pro Mio. Tokens) |
|---|---|---|---|---|
stealth/space-bunny-alpha |
1.000.000 | 524.288 | Text, Bild, Video | 0 $ / 0 $ |
anthropic/claude-opus-5.5 |
1.000.000 | 128.000 | Text, Bild, Dateien | 4 $ / 20 $ |
openai/gpt-6-luna |
1.050.000 | 128.000 | Text, Bild, Dateien | 0,10 $ / 0,50 $ |
google/gemini-3.8-flash |
1.048.576 | 65.536 | Text, Bild, Video, Dateien, Audio | 0,75 $ / 3,75 $ |
qwen/qwen3.8-27b:free |
262.144 | 235.929 | Text, Bild, Video | 0 $ / 0 $ |
thinkingmachines/inkling:free |
1.048.576 | 262.144 | Text, Bild, Audio | 0 $ / 0 $ |
nvidia/nemotron-3-ultra-550b-a55b:free |
1.000.000 | 65.536 | Text | 0 $ / 0 $ |
Das Erste, was ins Auge fällt, ist die Preisspalte. Zwei Modelle stehen bei null, und zwischen den übrigen liegen zweihundertfache Unterschiede. In der Kontextspalte unterscheidet sich fast niemand: Sechs der sieben Modelle liegen um eine Million Tokens. Das heißt: Ein Kontextfenster von 1M ist kein unterscheidendes Merkmal mehr, sondern eine Desktop-Erwartung.
Kostenvergleich
Das reine Preisverhältnis zu lesen führt in die Irre. Rechnen wir stattdessen ein realistisches Szenario durch.
Angenommen: 30 Anfragen im Monat, jede mit 200.000 Eingabetokens und 50.000 Ausgabetokens. Das entspricht grob einer Runde einer Agentensitzung in einer Codebasis mit mehreren Dateien. Dreißig Runden bedeuten ein paar Stunden aktiver Arbeit pro Monat.
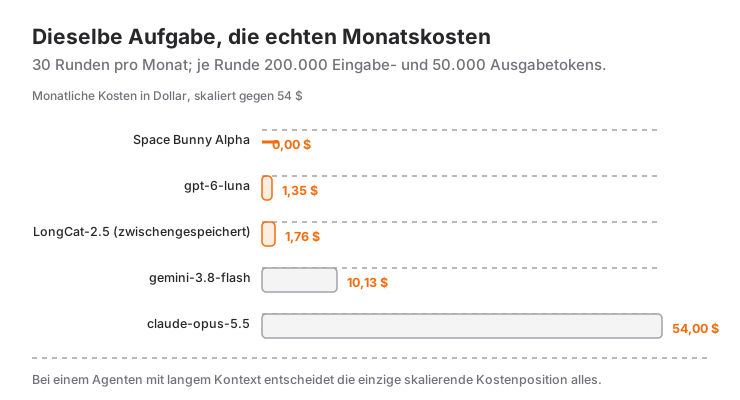
| Modell | Pro Anfrage | 30 Anfragen im Monat |
|---|---|---|
stealth/space-bunny-alpha |
0,00 $ | 0,00 $ |
openai/gpt-6-luna |
0,045 $ | 1,35 $ |
google/gemini-3.8-flash |
0,3375 $ | 10,13 $ |
anthropic/claude-opus-5.5 |
1,80 $ | 54,00 $ |
Berechnet wurde Eingabetokens × Eingabepreis + Ausgabetokens × Ausgabepreis, mit den rohen Tokenzahlen.
Die größte Überraschung ist hier nicht Space Bunny Alpha, sondern openai/gpt-6-luna. Mit 0,10 $ und 0,50 $ liegen die Kosten pro Million Token im Vergleich zu geschlossenen Modellen extrem niedrig. Dass man für 1,35 $ im Monat ein Modell mit 1M Kontext, Werkzeugaufrufen und Bildverständnis bekommt, widerlegt stillschweigend die Annahme "nicht kostenlos heißt teuer".
Der Vorteil von Space Bunny Alpha ist noch deutlicher: Die Zeile ist null, genau null. Aus demselben Grund ist sie aber keine planbare Position im Budget. Fällt das Modell weg, wird die ganze Kostenlage neu bestimmt. Die Festpreis-Tarife aus dem opencode-Artikel sind genau der Weg, diese Unsicherheit zu beseitigen.
Eingabeformate
Die kurze Antwort: Videoeingabe gibt es bei keinem der geschlossenen Modelle, bei kostenlosen offenen Modellen ist sie verbreitet.
Space Bunny Alpha nimmt text + image + video entgegen. Claude Opus 5.5 und GPT-6 Luna lesen Bilder, aber kein Video. Gemini 3.8 Flash akzeptiert alle fünf Formate, allerdings bei 0,75 $ / 3,75 $ und einer Ausgabegrenze von 65.536 Tokens.
Auf der offenen Seite bietet qwen/qwen3.8-27b:free dasselbe Trio mit 262.144 Tokens Kontext. Zwei kostenlose Modelle nehmen also Video entgegen, aber eines bietet nicht den 1M-Kontext. Die Position von Space Bunny Alpha in dieser Zeile ist der einzige Punkt, an dem sich die Grenzen überschneiden: eine Million Tokens, Videoeingabe und Preis null gleichzeitig.
Beim Audio gibt es eine Lücke. Inkling und Gemini nehmen Audio entgegen, Space Bunny Alpha nicht. Wenn Sie ein Sprachprodukt bauen, fällt diese Zeile für Sie weg.
Agentenfähigkeiten
Damit ein Modell als Agent taugt, muss es vier Dinge können: das Werkzeugschema lesen, das richtige Werkzeug wählen, es mit gültigen Argumenten aufrufen und das Ergebnis in der nächsten Runde verwenden. Welche API-Parameter unterstützt werden, entscheidet das direkt.
| Fähigkeit | Space Bunny Alpha | Claude Opus 5.5 | GPT-6 Luna | Gemini 3.8 Flash |
|---|---|---|---|---|
tools |
ja | ja | ja | ja |
tool_choice |
nur auto |
vollständig | vollständig | vollständig |
response_format |
ja | ja | ja | ja |
| Reasoning abschaltbar | nein | nein | ja | nein |
| Standardstufe | max |
high |
medium |
medium |
| Verfügbare Stufen | 5 | 5 | 6 (inkl. none) |
3 |
seed |
nein | nein | ja | ja |
stop |
nein | ja | nein | ja |
temperature / top_p |
ja / ja | ja / nein | nein / nein | ja / ja |
Zwei Zeilen haben hier eine praktische Folge.
tool_choice akzeptiert nur auto. Sie können dem Modell also nicht sagen "rufe ein Werkzeug auf, wähle nicht" oder "rufe genau dieses Werkzeug auf". Für die meisten Agentenschleifen ist das kein Problem, denn die Werkzeugauswahl wird ohnehin dem Modell überlassen. Braucht Ihr Ablauf aber "du musst dieses Werkzeug aufrufen", müssen Sie es entweder im Prompt-Text stark betonen, oder dieses Modell passt nicht zu diesem Ablauf.
reasoning_effort: max ist der Standard. Dieselbe Stufe ist bei Claude Opus 5.5 high und bei GPT-6 Luna medium. Keines der drei Modelle lässt Reasoning abschalten, aber zwei Stufen Unterschied merkt man in der Latenz. Für einfache Aufgaben low zu setzen ist eine spürbare Ersparnis.
Es gibt außerdem eine sichtbare Lücke bei der Reproduzierbarkeit: Es gibt kein seed, zwei Aufrufe mit demselben Prompt garantieren also nicht dieselbe Antwort. Auch temperature: 0 stellt das nicht vollständig wieder her. Wenn Sie in Tests reproduzierbare Ausgaben brauchen, ist das eine echte Einschränkung.
Space Bunny Alpha und JEV: keine Konkurrenten
Eine Frage, die im JEV-Artikel auf dieser Seite immer wieder gestellt wird: JEV ist auch günstig, auch ein Modell, warum sollte ich dann Space Bunny Alpha nehmen?
Die Antwort lautet, dass die beiden auf verschiedenen Ebenen arbeiten. JEV erzeugt keinen freien Text; es nimmt einen Zustand und typisierte Fragen entgegen und gibt eine Entscheidung zurück. Sie nutzen es, um zu erkennen, ob eine E-Mail eine Rechnung, ein Sponsoring-Angebot oder Spam ist. Space Bunny Alpha ist ein generatives Sprachmodell: Es schreibt Code, erklärt Dinge, liest Bilder und ruft Werkzeuge auf.
Die beiden sind also keine Alternativen, sondern Ergänzungen. Wenn Sie eine strenge Klassifikationsschicht bauen, nehmen Sie JEV; wenn Sie einen Agenten bauen, der um diese Entscheidung herum Text erzeugt, nehmen Sie Space Bunny Alpha.
Dieselbe Logik steckt hinter der Trennung im Harness-Artikel: Ein Modell ist eine Funktion, die Text entgegennimmt und Text zurückgibt. Das Verhalten eines Agenten bestimmen das Modell und die Schleife, die Sie darum bauen.
Wer wählt was
Statt das in eine Tabelle zu pressen, beginnen Sie mit der Zeile, die Ihrem Problem am nächsten liegt:
Wenn die Kosten wirklich null sein müssen und Sie experimentierfreudig sind: stealth/space-bunny-alpha. 1M Kontext, Videoeingabe, Werkzeugaufrufe, Rechnung über null. Sie müssen das Risiko tragen können.
Wenn Sie bezahlen können und Qualität an erster Stelle steht: die geschlossenen Flaggschiff-Modelle. gpt-6-luna verdient besondere Aufmerksamkeit, weil es das günstigste geschlossene Modell dieser Tabelle ist und den größten Kontext von allen.
Wenn Sie eine große Codebasis in einer Sitzung lesen lassen müssen: gpt-6-luna oder gemini-3.8-flash. Beide haben 1M Kontext, und die monatlichen Kosten bleiben unter zwölf Dollar.
Wenn Sie ein Modell brauchen, das Sie selbst betreiben können: die kostenlosen offenen Modelle außer Space Bunny Alpha. Deren Gewichte liegen auf Hugging Face, das Feld hugging_face_id ist gefüllt. Sie können sie auf Ihrem eigenen Server mit Ihren eigenen Daten laufen lassen. Für Space Bunny Alpha ist das nicht möglich.
Wenn Sie ein Sprachprodukt bauen: Space Bunny Alpha fällt raus. Es gibt keine Audioeingabe.
Wenn Transparenz am wichtigsten ist: nehmen Sie ein Modell mit offenen Gewichten. Bei nvidia/nemotron-3-ultra-550b-a55b:free oder qwen3.8-27b:free können Sie Trainingsdaten, Lizenz und Gewichte einsehen. Den Wert is_moderated: false müssen Sie außerdem mit eigenen Prüfungen der Eingabe ausgleichen, mit derselben Validierungslogik wie im Artikel zur Sicherheit von Sprachchat-Apps.
Wie lange diese Tabelle gültig bleibt
Ehrlich gesagt ist der kurzlebigste Teil dieses Vergleichs die Preisspalte. Es gibt drei Unsicherheiten, und alle drei liegen außerhalb des Modells:
Kostenlos kann befristet sein. Das Modell steht heute mit 0 $ in der Liste. Andere Modelle standen gestern mit 0 $ in der Liste und waren drei Monate später nicht mehr vorhanden. Zum Zeitpunkt dieses Artikels waren bei OpenRouter genau 21 Modelle für Ein- und Ausgabe kostenlos; das ist eine Beobachtung, kein Versprechen.
Name und Version können sich ändern. Der Anbieter hat eine Version mit dem Zusatz alpha ausgeliefert. Dieser Name ist ein Zeichen der Instabilität: Dieselbe Kennung kann morgen auf ein anderes Modell zeigen. Wenn Sie es produktiv einsetzen, fixieren Sie die Modellkennung und beobachten Sie Verhaltensänderungen.
Der Anbieter ist ein einzelner Punkt. Space Bunny Alpha hat derzeit genau einen Endpunkt, mit einer Verfügbarkeit von rund 99,9 % in den letzten 24 Stunden. Ein einzelner Endpunkt ist gut und schlecht zugleich: Das Routing ist einfach, fällt er aber aus, gibt es keinen anderen als Ausweichziel. Modelle mit mehreren Endpunkten verteilen diese Last.
Außerdem ist kein Wissensstand veröffentlicht. Sie wissen also nicht, bis zu welchem Datum die Welt gesehen hat, was beim Zitieren von Quellen eine wichtige Grenze darstellt.
Quellen
- OpenRouter-Modell-API (Kontextfenster, Preis, Eingabeformate, unterstützte Parameter, Reasoning-Stufen,
hugging_face_id) - OpenRouter-Endpunktdetails: Space Bunny Alpha (
tool_choice-Unterstützung, Verfügbarkeit,is_moderated, Status des impliziten Caching) - OpenRouter-Modellseite: Space Bunny Alpha (Übersicht, Anbieter)
Verwandte Artikel
Space Bunny Alpha installieren: Schritt für Schritt
Space Bunny Alpha über OpenRouter einrichten: API-Schlüssel, erste Anfrage, Python und TypeScript, Bildeingabe, Open-Source-Agenten.
Space Bunny Alpha: 1M Kontext und multimodale Eingabe
Was ein Kontextfenster von einer Million Tokens fasst, wie Bild und Video es teilen und wie man das Token-Budget misst und verwaltet.
Einen KI-Agenten mit Space Bunny Alpha bauen
Vom Werkzeugschema bis zur Schleife: einen Coding-Agenten auf Space Bunny Alpha bauen, Werkzeugfehler zurückgeben, Ausgabe auf JSON festlegen.