Claude Fable 5.2 Karşılaştırma: Opus 5.5, Astra, Carbon
8 dk okuma

Anthropic'in 9 Kasım 2026 tarihli tablosunda Claude Fable 5.2, gösterilen 11 ölçütün 10'unda Claude Opus 5.5, GPT-6 Astra ve Gemini 4 Carbon'un önünde. Tek istisna AutomationBench: Gemini 4 Carbon %53,9 ile Fable 5.2'nin %51,4'ünü geçiyor. Tablonun tamamı Anthropic'in; bağımsız bir yeniden üretim yok.
Bu bir haber ve derleme yazısıdır; modelleri ben denemedim. Rakamlar Anthropic'in duyuru sayfasındaki tablodan alındı. Rakip modellerin sayıları da Anthropic'in tablosundan; üçüncü taraf ölçümü değil. Modelin tanıtımı için Claude Fable 5.2 nedir, fiyat farkları için fiyat ve maliyet yazısına bakın.
Kısa cevap
Fable 5.2, Anthropic'in seçtiği ölçütlerde en yüksek skorlara sahip. En büyük farklar WANDR (%82,1, Opus 5.5 %72,3), Remote Labor Index (%41,3, Opus 5.5 %21,3, yaklaşık iki kat) ve RoboDojo Sim (%64,9, Opus 5.5 %39,4). En küçük fark Chartography'de: Fable 5.2 %73,4, Gemini 4 Carbon %72,5, GPT-6 Astra %71,0. AutomationBench'te Carbon önde, AA-Briefcase altındaki etiketsiz Elo satırında ise Opus 5.5.
Anthropic'in tablosu
Sütunlar: Claude Fable 5.2, Fable 5.1, Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon. "-" Anthropic'in o hücreyi göstermediği anlamına geliyor. Skorlar aksi belirtilmedikçe her modelin en yüksek erişilebilir eforunda.
| Ölçüt | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (ajan tabanlı kodlama) | %49,1 (Xhigh) | %32,4 (Xhigh) | %45,5 | %42,8 | %41,1 (Medium) |
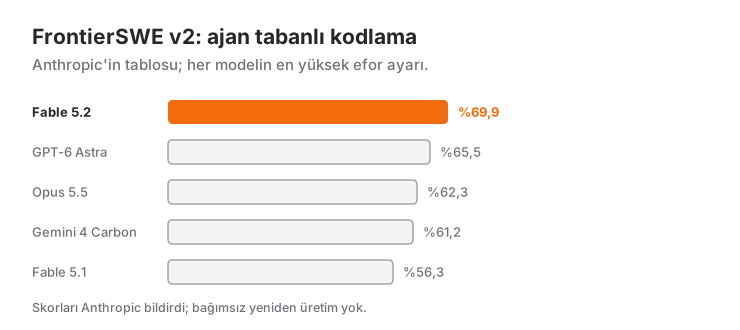
| FrontierSWE v2 (ajan tabanlı kodlama) | %69,9 | %56,3 | %62,3 | %65,5 | %61,2 |
| AutomationBench (iş akışları) | %51,4 | %31,4 | %42,5 | %41,4 | %53,9 |
| Terminal-Bench-Science 0.1 (bilimsel araştırma) | %74,6 | %52,6 | %58,7 | %68,1 | %64,8 |
| OSWorld 2.1 (bilgisayar kullanımı, çevrimdışı alt küme) | %89,3 | %83,5 | %87,2 | %79,5 | %81,5 |
| RoboDojo Sim (robotik; Anthropic iç koşusu) | %64,9 | %27,6 | %39,4 | %29,8 | - |
| AA-Briefcase v1.1 (bilgi işi, rubrik) | %66,1 | %61,5 | %61,2 | %52,0 | %61,8 |
| Remote Labor Index (High efor) | %41,3 | %17,9 | %21,3 | %20,8 | - |
| Humanity's Last Exam (araçlarla) | %74,2 | %65,6 | %67,7 | %57,2 | - |
| Chartography (grafik anlama, araçsız) | %73,4 | %44,8 | %64,4 | %71,0 | %72,5 |
| WANDR (ajan tabanlı arama, relaxed skor) | %82,1 | %68,7 | %72,3 | - | - |
Tablonun dışındaki iki satır: AA-Briefcase altında etiketsiz bir Elo satırı var (Fable 5.2 1785, Fable 5.1 1669, Opus 5.5 1800, GPT-6 Astra 1569, Gemini 4 Carbon 1611). BenchCAD 2.1'de (donanım mühendisliği, araçlarla, 0-100 kısmi puan, Max efor) Fable 5.2 83,5, Opus 5.5 65,3, Fable 5.1 44,4 aldı.
Kodlama ve ajan işleri
Fable 5.2, iki ajan tabanlı kodlama ölçütünde de önde, ama farklar tek haneli. FrontierCode 2.0'da Xhigh eforda %49,1 (Opus 5.5 %45,5, Astra %42,8, Carbon %41,1 Medium eforda). FrontierSWE v2'de %69,9; ikinci sırada GPT-6 Astra %65,5. Anthropic ayrıca FrontierCode 2.0'da High eforda Fable 5.2'nin %45,3 aldığını ve Opus 5.5'in en iyisiyle (%45,5) başa baş olduğunu, ancak görev başına maliyetin yaklaşık yarısı olduğunu söylüyor (fiyat yazısında ayrıntısı var).
Not: Carbon'un FrontierCode 2.0 skoru tabloda Medium eforda gösteriliyor; Fable'ın Xhigh'ı ile aynı efor düzeyi değil. Nedeni yazılmamış, bu yüzden bu iki sayıyı birebir kıyaslamak doğru olmaz.
AutomationBench (iş akışları) farklı bir hikaye: Fable 5.2 %51,4 ile Fable 5.1'e göre büyük sıçrama yaptı (%31,4), ama Carbon %53,9 ile önde. Terminal-Bench-Science 0.1'de Fable 5.2 %74,6, ikinci sırada Astra %68,1.
Sahada araç karşılaştırması için, yani Claude, ChatGPT, Cursor ve Codex'in gerçek işte nasıl durduğuna bakmak isterseniz vibe coding araç karşılaştırması benchmark değil kullanım odaklı.
Bilgisayar kullanımı, görsel ve robotik
Bilgisayar kullanımında fark küçük, robotikte büyük. OSWorld 2.1 çevrimdışı alt kümede Fable 5.2 %89,3, Opus 5.5 %87,2, Carbon %81,5, Astra %79,5: en yakın rakiple fark 2,1 puan.
Grafik anlama (Chartography, araçsız) neredeyse başa baş: Fable 5.2 %73,4, Carbon %72,5, Astra %71,0, Opus 5.5 %64,4.
Robotikte RoboDojo Sim'de Fable 5.2 %64,9; Opus 5.5 %39,4, Astra %29,8, Fable 5.1 %27,6. Bu, Anthropic'in iç koşusu; Anthropic Astra'nın ve Fable 5.1'in iki katından fazla olduğunu söylüyor. Aynı grafikte yalnızca burada görünen Gemini 4 Argon %34,2 almış. Carbon bu satırda gösterilmemiş.
Bilgi işi ve akıl yürütme
Bilgi işi ve akıl yürütme satırlarında Fable 5.2 önde ama bir istisnayla. AA-Briefcase v1.1'de (rubrik) %66,1; Carbon %61,8, Opus 5.5 %61,2. Humanity's Last Exam'de araçlarla %74,2 (Opus 5.5 %67,7, Astra %57,2). Remote Labor Index'te High eforda %41,3, Opus 5.5 %21,3, Astra %20,8. WANDR'de %82,1, Opus 5.5 %72,3; Astra ve Carbon bu satırda gösterilmemiş.
Fable 5.2'nin önde olmadığı yerler
Üç nokta var:
- AutomationBench. Gemini 4 Carbon %53,9, Fable 5.2 %51,4. Tabloda Fable 5.2'nin geride kaldığı tek ölçüt bu.
- AA-Briefcase altındaki etiketsiz Elo satırı. Opus 5.5 1800, Fable 5.2 1785. Bu satırın etiketi Anthropic'in tablosunda yok; bu yüzden neyi ölçtüğünü doğrulayamadım, yorumlamıyorum.
- Chartography'de yakınlık. Fable 5.2 %73,4; Carbon %72,5 ve Astra %71,0 aradaki farkı 1-2 puana indiriyor. Bu satırda "kazandı" demek ölçüm hassasiyetinin ötesine geçmek olur.
Ayrıca yalnızca Fable 5.2, Fable 5.1 ve Opus 5.5'te korumaların açık olduğu dipnotta yazıyor; GPT-6 Astra ve Gemini 4 Carbon için koşul belirtilmemiş.
Bu tabloyu nasıl okumalı
- Tablo üreticinin. Ölçütleri Anthropic seçmiş. Seçimde kendi modelinin lehine bir eğilim olduğuna dair kanıtım yok, ama dışarıdan bakan biri olarak bunu ayırt etmem de mümkün değil.
- Rakip skorlarının koşulu belli değil. Dipnotlar GPT-6 Astra ve Gemini 4 Carbon skorlarının kaynağını ve koşulunu yazmıyor. Benim Carbon yazımda aktardığım Google tablosunda GPT-6 Astra FrontierSWE 2'de %65,5, Carbon %61,2, Opus 5.5 OSWorld-2.1'de %87,2, Carbon %81,5; bu dört sayı Anthropic'in tablosundakilerle aynı. Yani en azından bu satırlarda iki üretici aynı değerleri veriyor (kendi yazımdan aktarıyorum, Google'ın sayfasını yeniden doğrulamadım).
- CyScenarioBench'te her laboratuvarın skoru kendi görevlerine dayanıyor. Bu satırlar doğrudan kıyaslanamaz.
- Bağımsız ölçüm yok. Artificial Analysis ya da benzeri bir üçüncü tarafın Fable 5.2 sonucunu okumadım. Sistem kartını da okumadım.
- Farklı yazılardaki ölçütler farklı koşular. Başka yazılarımdaki Terminal-Bench 4.0 ya da OSWorld 2.1 %80,1 gibi değerleri bu tabloyla karıştırmayın: farklı sürüm ve koşu. Örneğin Gemini 4 Carbon, Argon, Opus 5.5 ve Astra karşılaştırmasındaki sayılar kendi kaynaklarına aittir.
- Mythos 5.2 ayrı bir hat. Korumasız model Terminal-Bench-Science'ta %75,3 alıyor (Fable 5.2'nin %74,6'sı yanında), siber ölçütlerde CVE Rediscovery %89,6; bunlar Fable'ın satırları değil. Mythos genel erişime kapalı.
Hangi model hangi iş için
Benchmark tablosundan çıkarılabilecek yorum şu, ama kendi işinizde ölçmeden karar vermeyin:
| İş | Tablodaki işaret |
|---|---|
| Zor, uzun süreli ajan tabanlı kodlama | Fable 5.2 en yüksek skorlarda (FrontierCode 2.0, FrontierSWE v2) |
| İş akışı otomasyonu | Carbon AutomationBench'te önde; Fable 5.2 ikinci |
| Bilgisayar kullanımı | Fable 5.2 önde, Opus 5.5 yakın |
| Grafik ve görsel anlama | Fable 5.2, Carbon ve Astra çok yakın |
| Robotik, arama, bilimsel araştırma | Fable 5.2 belirgin önde |
| Fiyat öncelikli | Opus 5.5 token başına yarı fiyat (4 $ / 20 $), ama görev başı maliyet işe göre değişir |
Fable 5.2'nin çıktığı yeni işlerin (1.000 ajan, Fermat, fizik) ayrıntısı neler yapabiliyor yazısında. Erişim için kimler kullanabilir yazısına bakın.
Sık Sorulan Sorular
Claude Fable 5.2, Opus 5.5'ten daha mı iyi?
Anthropic'in tablosundaki 11 ölçütün hepsinde Fable 5.2 Opus 5.5'in önünde. Yalnızca AA-Briefcase altındaki etiketsiz Elo satırında Opus 5.5 (1800) Fable 5.2'nin (1785) önünde. Tablo Anthropic'in; bağımsız doğrulama yok.
(Not: Anthropic o Elo satırını etiketsiz veriyor, bu yüzden onu ölçüt sayısına katmadım.)
Fable 5.2, GPT-6 Astra'dan daha mı iyi?
Tabloda Fable 5.2 Astra'dan her ölçütte yüksek skorda. En yakın satır Chartography: %73,4'e karşı %71,0. Astra'nın skorlarının koşulu Anthropic'in dipnotlarında belirtilmemiş.
Gemini 4 Carbon, Fable 5.2'yi geçiyor mu?
AutomationBench'te evet: %53,9'a karşı %51,4. Chartography'de Fable 5.2 %73,4, Carbon %72,5. Diğer satırların çoğunda Fable 5.2 önde.
Fable 5.2 hangi ölçütte en büyük farkı atıyor?
WANDR'de Opus 5.5'e %82,1'e karşı %72,3, Remote Labor Index'te %41,3'e karşı %21,3 ve RoboDojo Sim'de %64,9'a karşı %39,4. RoboDojo Anthropic'in iç koşusu.
Fable 5.2 en iyi kodlama modeli mi?
Anthropic'in tablosundaki iki ajan tabanlı kodlama ölçütünde (FrontierCode 2.0, FrontierSWE v2) en yüksek skor Fable 5.2'de. Farklar 3,6 ve 4,4 puan. Bağımsız bir kodlama karşılaştırması okumadım, "en iyi" demeden önce kendi kod tabanınızda deneyin.
Bu benchmark sonuçlarına güvenebilir miyim?
Sayılar Anthropic'in kendi bildirimi; üçüncü taraf yeniden üretimi yok. Rakip sayılarının kaynağı ve koşulu yazılmamış. Karar vermeden önce kendi işinizde küçük bir deneme yapın.
Sonnet 5.5 bu tabloda neden yok?
Anthropic'in Fable 5.2 tablosu Sonnet 5.5'i içermiyor. Sonnet 5.5 için ayrı yazıya bakın; ölçütleri bu tabloyla birleştirmek için ortak bir koşu yok.
Kaynak
- Anthropic, Claude Fable 5.2 and Claude Mythos 5.2 (9 Kasım 2026; 11 Kasım'da düzenleme notu eklendi): benchmark tablosu, dipnotlar, RoboDojo ve Mythos satırları, maliyet grafikleri.
- Anthropic, Claude Fable ürün sayfası: Fable 5.1 ile karşılaştırma, model zaman çizelgesi.
- Anthropic, Models overview: Claude Fable 5.2: model özellikleri, fiyatlar ve Opus 5.5 ile Sonnet 5.5 karşılaştırması.
- Anthropic, What's new in Claude Fable 5.2: efor ve davranış notları.
İlgili Yazılar
Gemini 4 Carbon, Argon, Opus 5.5 ve Astra Karşılaştırması
Gemini 4 Carbon endekste birinci ama her yerde değil: Opus 5.5 ajan kodlamada, Astra FrontierSWE'de önde; yanılma oranı da Argon'dan yüksek.
Claude Fable 5.2 Nedir? Fiyat, Mythos Farkı, Erişim
Anthropic Claude Fable 5.2'yi 9 Kasım 2026'da yayımladı: 1M bağlam, milyon token başına 8 $ girdi ve 40 $ çıktı, Fable 5.1'den %20 ucuz.
Claude Fable 5.2 Fiyatı: 8 $ / 40 $ ve Efor Seviyeleri
Claude Fable 5.2 milyon token başına 8 $ girdi, 40 $ çıktı. Önbellek, Batch, fast mode ve efor seviyeleriyle görev başına maliyet nasıl değişir, örnek hesapla.