Gemini 4 Neon, Carbon, Opus 5.5, GPT-6.2 Sol Kıyaslama
12 dk okuma
Gemini 4 Neon, Google'ın kendi tablosundaki 19 satırın 16'sında Claude Opus 5.5 ve GPT-6.2 Sol'un önünde; ancak yöntem belgesine ve bağımsız ölçüm sitelerine bakınca tablo daha katmanlı hale geliyor:
- Terminal-Bench 4.1'de Claude Opus 5.5 %65,8 ile Neon'un (%65,2), FrontierCode 2.0'da %47,3 ile Neon'un (%46,2) önünde. Chartography'de ise GPT-6.2 Sol %75,1 ile birinci.
- SWE-sweep'teki %39,0'lık büyük sıçrama Antigravity-CLI v1.5.9'un alt ajan dağıtım aracından geliyor; sade mini-SWE çerçevesinde Neon %12,8, GPT-6.2 Sol %11,6.
- Artificial Analysis Intelligence Index v5.0.1'de Neon
xhigh61 puanda; ancak üst sınıfta Claude Fable 5.2 (65) ve GPT-6.2 Astra (62) Google'ın tablosunda yer almıyor. - Neon,
highseviyesinde Gemini 4 Carbon ile aynı 60 puanı yarıdan az sürede (14,8 dakikaya karşı 36,1 dakika) ve daha düşük maliyetle (3,74 $'a karşı 4,90 $) alıyor. - AA-Omniscience v1.1 yanılma ölçümünde Neon %13,9 - %14,4 ile rakip modellerden (%50,3 ve %55,4) çok daha dürüst, ama Argon (%4,3), Hydrogen (%8,5) ve Carbon'dan (%11,4) daha sık yanlış tahminde bulunuyor.
Modelin kendisi için önce Gemini 4 Neon nedir yazısına, fiyat ve planlar için Gemini 4 Neon ücretsiz mi yazısına, üst sınıf kıyaslaması için ise Claude Fable 5.2 karşılaştırmasına bakabilirsiniz.
Bu yazı bir haber ve derleme metnidir; modelleri kendim aynı görevlerde koşturmadım. Sayılar Google'ın 18 Kasım 2026 duyurusundan, DeepMind'ın model kartı ile değerlendirme yöntemi PDF'inden (gemini_4_neon_model_evaluation.pdf), Artificial Analysis v5.0.1 ve Coding Agent Index v2.1 sayfalarından alındı. Kaynaklar sonda.
Google'ın 19 satırlık tablosu ve yöntem denetimi
Google DeepMind, Gemini 4 Neon'u iki rakiple yan yana koyuyor: Claude Opus 5.5 ve GPT-6.2 Sol.
| Ölçüt | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AA Index v5.0.1 | 61 | 59 | 57 |
| Vals Index v2.2 | %70,9 | %70,1 | %66,1 |
| CursorBench 4.1 | %65,4 | %58,1 | verilmemiş |
| Terminal-Bench 4.1 (hile düzeltmeli) | %65,2 | %65,8 | %61,5 |
| FrontierCode 2.0 (ana skor) | %46,2 | %47,3 | %43,8 |
| SWE-sweep (sağlayıcı çerçevesi) | %39,0 | %10,1 | %8,3 |
| SWE-sweep (Mini-SWE çerçevesi) | %12,8 | %3,6 | %11,6 |
| AutomationBench | %56,3 | %42,5 | %41,3 |
| Agents' Last Exam v1.1 | %75,8 | %71,6 | %73,0 |
| RiemannBench | %84,0 | %80,0 | %80,0 |
| Terminal-Bench-Science 0.1 | %70,5 | %63,3 | %68,0 |
| HLE-Diamond | %71,3 | %67,9 | %64,0 |
| MKA (Climb WSR) | %56,5 | %53,0 | %52,7 |
| Chartography | %73,5 | %66,3 | %75,1 |
| LVBench | %89,0 | %83,7 | %87,6 |
| GraphWalks (256k-1M, BFS F1) | %95,2 | %66,8 | %80,1 |
| CWE-Bench v2 | %70,7 | %67,1 | %66,0 |
| SEC-bench Pro | %90,5 | verilmemiş | %88,3 |
| WebExploitBench v1.2 | %51,3 | %37,1 | verilmemiş |
DeepMind'ın değerlendirme yöntemi PDF'i (gemini_4_neon_model_evaluation.pdf) her satırın arka planını tek tek açıklıyor. Tabloyu sağlıklı okumak için beş ayrıntı önemli:
- SWE-sweep farkı çerçeveden doğuyor. Sağlayıcı çerçevesi satırında Google kendi
Antigravity-CLI v1.5.9aracını kullanmış; Opus 5.5Claude Code, Sol iseCodexile koşulmuş. Belge, Antigravity-CLI'ın kod tabanına paralel dağılan alt ajanlar (fan-out) aracına sahip olduğunu ve bunun SWE-sweep gibi hata arama işlerine özellikle uyduğunu açıkça belirtiyor. Aracı sademini-sweçerçevesine indirince Neon %12,8, GPT-6.2 Sol %11,6 ile birbirine çok yaklaşıyor. - FrontierCode 2.0'da Neon
highayarıyla koşulmuş. Çoğu ölçütte en yüksek düşünme ayarı (xhigh) kullanılmışken FrontierCode 2.0 liderlik tablosu sonucuhighayarına ait. - Çoğu rakip skoru üretici raporu ya da liderlik tablosundan. AA Index, Vals Index, CursorBench 4.1, Terminal-Bench 4.1, AutomationBench, RiemannBench, HLE-Diamond, MKA ve CWE-Bench v2 verileri üçüncü taraf liderlik tablolarından alınmış. Agents' Last Exam v1.1 (Neon
Antigravity-CLI v1.4.8ile 5 saatlik pencerede), Terminal-Bench-Science 0.1 (mini-swe, 5 deneme ortalaması), Chartography, LVBench, GraphWalks, SEC-bench Pro ve WebExploitBench v1.2 ise Google'ın kendi koşusu. - LVBench kare sınırı farklı. API sınırlamaları nedeniyle Neon 1 FPS düşük çözünürlükle, GPT-6.2 Sol 500 kareyle, Claude Opus 5.5 ise 600 kareyle test edilmiş.
- Siber güvenlik ölçütlerinde korumalar kapalı. SEC-bench Pro, ExploitGym ve benzeri siber değerlendirmeler güvenlik filtreleri kapalıyken koşuluyor; günlük kullanımdaki korumalı model aynı davranışı göstermeyebilir.
Bağımsız ölçümler: düşünme seviyesi ve üst sınıf rakipler
Artificial Analysis Intelligence Index v5.0.1'deki canlı sayılar (19 Kasım 2026'da kontrol ettim), hem Neon'un dört düşünme seviyesini hem de Google'ın tablosunda bulunmayan Claude Fable 5.2 ve GPT-6.2 Astra modellerini aynı ölçekte görmeyi sağlıyor:
| Model (düşünme seviyesi) | Endeks | Görev başı maliyet | Görev başı süre |
|---|---|---|---|
Claude Fable 5.2 max |
65 | 26,54 $ | 41,2 dk |
GPT-6.2 Astra max |
62 | 4,00 $ | 13,7 dk |
Claude Fable 5.2 high |
62 | 9,08 $ | 14,9 dk |
Gemini 4 Neon xhigh |
61 | 6,44 $ | 21,5 dk |
Gemini 4 Neon high (varsayılan) |
60 | 3,74 $ | 14,8 dk |
Gemini 4 Carbon high |
60 | 4,90 $ | 36,1 dk |
Claude Opus 5.5 max |
59 | 10,04 $ | 24,6 dk |
GPT-6.2 Sol max |
57 | 1,01 $ | 8,5 dk |
Gemini 4 Neon medium |
55 | 1,90 $ | 8,3 dk |
Claude Sonnet 5.5 max |
55 | 10,02 $ | 32,2 dk |
Gemini 4 Hydrogen xhigh |
54 | 3,16 $ | 15,3 dk |
Gemini 4 Argon high |
50 | 4,97 $ | 29,6 dk |
Gemini 4 Neon low |
44 | 0,75 $ | 3,7 dk |
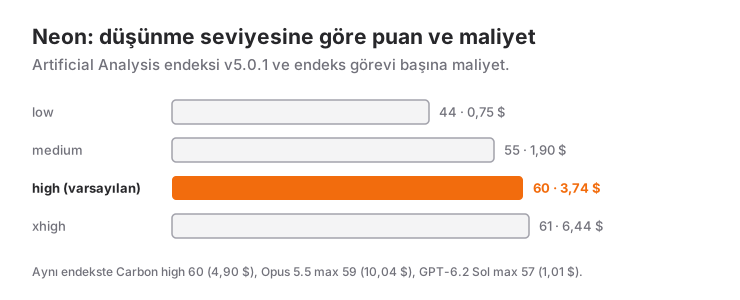
Bu tablodan çıkan beş sonuç var:
- Fable 5.2 ve GPT-6.2 Astra hâlâ en tepede. Astra yalnızca 17 Kasım'da çıktı ve
maxayarda 62 puana 4,00 $ maliyet ve 13,7 dakika süreyle ulaşıyor. Neonxhighise 61 puana 6,44 $ ve 21,5 dakika harcıyor. Yani OpenAI'ın üst modeli ile kıyaslandığında Neon fiyat/süre avantajını koruyamıyor; avantajını asıl Claude Opus 5.5, Claude Fable 5.2 ve Gemini 4 Carbon karşısında gösteriyor. - Neon
high, varsayılan ayar olarak çok dengeli.highilexhigharasındaki puan farkı sadece 1 puan (60'a 61), buna karşılık maliyet 3,74 $'dan 6,44 $'a çıkıyor ve süre 14,8 dakikadan 21,5 dakikaya uzuyor. - Opus 5.5'ten hem yüksek puanlı hem çok daha ucuz. Neon
high(60 puan, 3,74 $), Claude Opus 5.5max'ın (59 puan, 10,04 $) önünde ve maliyetin neredeyse üçte biri kadar. - GPT-6.2 Sol ile yarışta hız-kalite dengesi farklı. Sol
max57 puanı yalnızca 1,01 $ ve 8,5 dakikada alıyor; Neonmediumise 55 puanı 1,90 $ ve 8,3 dakikada veriyor. Yüksek bütçesiz hız arayan işlerde Sol hâlâ çok ucuz, ama uzun bağlam (GraphWalks %95,2'ye %80,1) ve bilgi güvenilirliği (aşağıda) Neon lehine açılıyor. lowbile Hydrogenmedium'u geçiyor. Neonlow44 puan (0,75 $, 3,7 dk) ile Hydrogenmedium'un (41 puan) üzerinde, ama Hydrogenhigh(51 puan, 1,87 $) Neonlow'dan daha akıllı.
Ajan kodlama endeksi (Coding Agent Index v2.1)
Google lansman duyurusunda Neon'un Artificial Analysis Coding Agent Index'te 58,6 puanla 1. sıraya yerleştiğini yazıyor. 19 Kasım'da canlı sayfasını kontrol ettiğimde Neon henüz herkese açık tabloya işlenmemişti; aynı tabloda yer alan diğer modellerin v2.1 skorları şöyle görünüyordu:
Claude Code - Claude Fable 5.2 (xhigh): 58,5 (15,47 $, 53,3 dk)Devin Fusion CLI (Opus 5.5 Max + GPT-6 Luna High): 58,4 (8,75 $, 54,9 dk)Claude Code - Claude Opus 5.5 (max): 58,2 (12,61 $, 65,3 dk)Antigravity CLI - Gemini 4 Carbon (high): 55,5 (6,29 $, 33,6 dk)Codex - GPT-6.2 Astra (max): 53,5 (5,12 $, 25,1 dk)Antigravity CLI - Gemini 4 Hydrogen (xhigh): 52,3 (4,45 $, 32,1 dk)Codex - GPT-6.2 Sol (xhigh): 49,8 (0,90 $, 12,6 dk)Antigravity CLI - Gemini 4 Argon (high): 45,5 (6,84 $, 37,7 dk)
Google'ın bildirdiği 58,6 skoru Fable 5.2 xhigh'ın (58,5) kıl payı önüne denk geliyor. Aynı ölçütte yalnızca Antigravity CLI çerçevesiyle test edildiğini unutmayın; Claude Code ve Codex farklı ajan çerçeveleri kullanıyor.
Neon ile Carbon: kardeşiyle karşılaştırma
Neon, Carbon'dan uyarlandığı için aralarındaki fark özellikle önemli. İki modelin ortak verileri:
- Genel zekâ ve hız: AA v5.0.1'de ikisi de
high'da 60 puan alıyor, fakat Neon 14,8 dakikada (3,74 $) bitirirken Carbon 36,1 dakika (4,90 $) harcıyor. Neonxhigh'da 61 puana çıkabiliyor. - Kodlama ve bilim: Neon, SWE-sweep'te (%12,8 mini-SWE ve %39,0 Antigravity vs. Carbon %9,6), RiemannBench'te (%84,0 vs. %80,0), Terminal-Bench-Science 0.1'de (%70,5 vs. %64,8) ve CWE-Bench v2 / SEC-bench Pro'da Carbon'u geçiyor.
- Carbon'un önde kaldığı yerler: Google'ın önceki Carbon tablosunda Carbon, Agents' Last Exam v1.1'de (%77,4 vs. %75,8), GraphWalks'ta (%96,2 vs. %95,2) ve ExploitGym'de öndeydi; ayrıca AA-Omniscience yanılma oranı Carbon'da (%11,4) Neon'dan (%13,9) bir miktar daha düşük.
- Fiyat dengesi: 30 Kasım'a kadar Carbon'un tanıtım fiyatı (2 $ / 10 $) token başı ucuz; 1 Aralık'tan itibaren Carbon 4 $ / 20 $ olunca Neon (3 $ / 15 $) hem token fiyatında hem görev başı faturada Carbon'dan ucuz hale gelecek.
Yanılma oranı, hız ve gevezelik
Artificial Analysis v5.0.1 verilerine göre (19 Kasım 2026):
Yanılma oranı (AA-Omniscience v1.1). Modelin bilmediği bir soruda "bilmiyorum" demek yerine uydurma sıklığı (düşük olan iyi):
| Model | Doğruluk | Yanılma oranı |
|---|---|---|
Gemini 4 Argon (high) |
%48,3 | %4,3 |
Gemini 4 Hydrogen (xhigh) |
%50,5 | %8,5 |
Gemini 4 Carbon (high) |
%58,3 | %11,4 |
Gemini 4 Neon (high) |
%59,4 | %13,9 |
Gemini 4 Neon (xhigh) |
%60,5 | %14,4 |
Claude Opus 5.5 (max) |
%65,5 | %50,3 |
GPT-6.2 Sol (max) |
%61,6 | %55,4 |
GPT-6.2 Astra (max) |
%68,6 | %59,1 |
Claude Fable 5.2 (max) |
%79,1 | %59,3 |
Buradaki desen çok net: Gemini 4 modelleri bilmediğinde susmayı rakiplerinden çok daha iyi başarıyor. Neon, Argon ve Carbon'a kıyasla birkaç puan daha fazla yanılsa da doğruluk oranı (%60,5) Carbon'dan (%58,3) yüksek; Opus 5.5 ve GPT-6.2 ailesi ise %50-%59 bandında yanlış tahmine gidiyor.
Hız ve gevezelik. Neon xhigh seviyesinde saniyede 110 token (high'da 101 tok/s) üretiyor; yani Carbon'un (84,6 tok/s) üstünde, Hydrogen'in (182 tok/s) altında. İlk cevap tokenı high'da 40,64 sn, xhigh'da 56,51 sn bekliyor. Endeks boyunca high'da 123M, xhigh'da 283M çıktı tokenı harcamış (ortanca 65,1M), bu da çıktı maliyetinin neden dikkatle izlenmesi gerektiğini gösteriyor.
Fiyat karşılaştırması
| Model | Girdi (1M token) | Çıktı (1M token) | Not |
|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | Ücretsiz API katmanı var |
| GPT-6.2 Sol | 2,00 $ | 10,00 $ | Artificial Analysis liste fiyatı |
| Gemini 4 Neon | 3,00 $ | 15,00 $ | Ücretsiz katman yok |
| Gemini 4 Carbon / Argon | 2,00 $ (1 Aralık'tan itibaren 4,00 $) | 10,00 $ (1 Aralık'tan itibaren 20,00 $) | Tanıtım 30 Kasım'da bitiyor |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | Artificial Analysis liste fiyatı |
| GPT-6.2 Astra | 8,00 $ | 40,00 $ | Artificial Analysis liste fiyatı |
| Claude Fable 5.2 | 8,00 $ | 40,00 $ | Artificial Analysis liste fiyatı |
Hangisini ne zaman seçmeli?
Bu bölüm yukarıdaki verilerden çıkardığım pratik özet:
- Fiyat/performans ve hızlı öncü ajan işleri: Varsayılan
highayarında Gemini 4 Neon veya Antigravity içindeOrchestrator (Neon). Opus 5.5 kalitesini daha düşük faturayla ve yarıya yakın sürede verir. - Çok düşük görev başı maliyet ama yeterli kodlama: GPT-6.2 Sol
max(1,01 $ / görev), ancak bilgi sorularında %55,4 yanılma oranını ve daha zayıf uzun bağlam performansını göze almanız gerekir. - En yüksek puan veya en zor bilim/kodlama: Bütçe sınırlı değilse Claude Fable 5.2 (65 puan) ya da görev başı 4,00 $ ile GPT-6.2 Astra
max(62 puan). - Uzun belge, hukuk, finans ve en düşük uydurma: Neon (%13,9 yanılma, Vals #2, Legal ve Tax Bench #1) veya bilgi doğruluğu kritikse Argon (%4,3 yanılma).
- Ücretsiz başlangıç ve hızlı rutin işler: Gemini 4 Hydrogen.
Sık Sorulan Sorular
Gemini 4 Neon, Gemini 4 Carbon'dan daha mı iyi?
Çoğu ölçütte çok yakınlar, hatta Neon daha hızlı ve high seviyesinde görev başına daha ucuz (3,74 $ vs. 4,90 $). Bilim ve güvenlik onarımında Neon biraz önde; çok uzun oturumlarda ve yanılma oranında Carbon hâlâ az farkla ileride.
Gemini 4 Neon, Claude Opus 5.5'ten iyi mi?
Google'ın 19 satırlık tablosunun 17 ortak satırının çoğunda ve Artificial Analysis v5.0.1 genel endeksinde (high 60 vs. max 59) Neon önde; Terminal-Bench 4.1 ve FrontierCode 2.0'da ise Opus 5.5 önde. Görev başına maliyette Neon belirgin şekilde ucuz.
Neon, GPT-6.2 Astra ve Claude Fable 5.2'yi geçiyor mu?
Hayır. Artificial Analysis v5.0.1'de Claude Fable 5.2 (65) ve GPT-6.2 Astra (62), Neon'un (61) önünde yer alıyor. Google'ın duyuru tablosunda Neon yalnızca Opus 5.5 ve daha küçük GPT-6.2 Sol ile karşılaştırılıyor.
Neon neden SWE-sweep'te %39,0 alıp mini-SWE'de %12,8 alıyor?
Antigravity-CLI v1.5.9 ajan çerçevesi, kod tabanında paralel alt ajanlar çalıştıran özel bir arama aracına sahip. Aynı model sade mini-SWE çerçevesiyle koşulduğunda skor %12,8'e düşüyor; bu da ajan çerçevesinin model kadar belirleyici olduğunu gösteriyor.
Neon'da high yerine xhigh kullanmaya değer mi?
Artificial Analysis endeksinde xhigh yalnızca +1 puan (60 → 61) kazandırırken görev başına maliyeti %72 artırıyor (3,74 $ → 6,44 $). Google da çoğu karmaşık iş için high varsayılanını önerip xhigh'ı yalnızca high'ın yetersiz kaldığı adımlara saklamayı tavsiye ediyor.
Neon daha çok mu halüsinasyon görüyor?
AA-Omniscience v1.1'de Neon'un yanılma oranı %13,9-%14,4 ile Argon (%4,3), Hydrogen (%8,5) ve Carbon'dan (%11,4) biraz yüksek, ama Claude Opus 5.5 (%50,3) ve GPT-6.2 Sol'dan (%55,4) çok daha düşüktür.
Kaynak
- Google DeepMind, Gemini 4 Neon: Model evaluation (Kasım 2026): 19 satırlık tablo, Antigravity-CLI v1.5.9 ve mini-SWE yöntemleri, LVBench ve siber test koşulları.
- Google DeepMind, Gemini 4 Neon model kartı (18 Kasım 2026): değerlendirme tablosu ve güvenlik karşılaştırmaları.
- Google, Introducing Gemini 4 Neon (18 Kasım 2026): Coding Agent Index 58,6, Vending-Bench 2, Agent Arena Index, Vals Legal/Tax ve maliyet iddiaları.
- Artificial Analysis, Gemini 4 Neon, LLM Leaderboard ve Coding Agents (19 Kasım 2026'da kontrol ettim): v5.0.1 ve v2.1 verileri, hız, gevezelik ve AA-Omniscience v1.1 değerleri.
İlgili Yazılar
Gemini 4 Carbon, Argon, Opus 5.5 ve Astra Karşılaştırması
Gemini 4 Carbon çıktığı gün endekste birinciydi ama her yerde değil: Opus 5.5 ajan kodlamada, Astra FrontierSWE'de önde; yanılma oranı da Argon'dan yüksek.
Gemini 4 Neon Nedir? Özellikler, Fiyat, Benchmark
Google 18 Kasım 2026'da Gemini 4 Neon'u yayımladı: 1 milyon tokenlık pencere, 3 $ / 15 $ fiyat ve Orchestrator desteği. Özellikler ve ölçümler.
Gemini 4 Carbon, Neon, Argon, Hydrogen: Hangisi Seçilmeli?
Gemini 4 ailesindeki dört modelin yan yana kıyaslaması: hız, düşünme seviyeleri, API fiyatı, plan erişimi ve çoklu model eşleştirme.