Gemini 4 Hydrogen, Sonnet 5.5, GPT-6.1 Terra Karşılaştırması
11 dk okuma
Gemini 4 Hydrogen her yerde önde değil. Google'ın kendi tablosundaki 10 satırın 7'sinde birinci, ama tabloya ve bağımsız ölçümlere yakından bakınca şunlar çıkıyor:
- Terminal-Bench 4.1'de Claude Sonnet 5.5 %63,9, Hydrogen %57,0.
- Bilgisayar kullanımını ölçen OSWorld-2.1'de Sonnet 5.5 %83,9, Hydrogen %77,6.
- Artificial Analysis'in kendi Terminal-Bench koşusunda da Hydrogen (yaklaşık %54) Sonnet 5.5'in (%64) gerisinde.
- Artificial Analysis endeksinde sıralama düşünme seviyesine göre değişiyor: Hydrogen varsayılan ayarda 51, Sonnet 5.5 en yüksek ayarda 55.
- GPT-6.1 Terra için bağımsız bir endeks satırı bulamadım; onunla ilgili bütün sayılar Google'ın tablosundan.
Modelin kendisi için önce Gemini 4 Hydrogen nedir yazısına bakabilirsiniz. Ücretsiz kullanım ve erişim ayrı bir yazıda, rakip tarafı ise Claude Sonnet 5.5 yazısında.
Bu yazı bir haber ve derleme metnidir; modeli kendim denemedim, üç modeli aynı görevlerde yan yana da koşturmadım. Sayılar Google'ın 12 Kasım 2026 tarihli duyurusundan, Google DeepMind'ın model sayfasından, Artificial Analysis'ten ve haber sitelerinden alındı. Kaynaklar sonda.
Yan yana tablo: Google'ın kendi karşılaştırması
Google, Hydrogen'i Claude Sonnet 5.5 ve GPT-6.1 Terra ile karşılaştırıyor. Duyuru yazısındaki tablo bir görsel; aşağıdaki değerleri Google DeepMind'ın model sayfasındaki metin tablosundan aldım ("Kasım 2026 itibarıyla" notuyla yayımlanmış).
| Ölçüt | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep (var olan kodu bozmadan hata bulup onarma) | %13,5 | %3,1 | %5,8 |
| Terminal-Bench 4.1 (hile düzeltmeli) | %57,0 | %63,9 | verilmemiş |
| Agents' Last Exam v1.1 (uçtan uca mesleki iş akışları) | %71,6 | %60,4 | %69,8 |
| AutomationBench-AA | %76,1 | %71,8 | %60,2 |
| Vending-Bench 2 (banka bakiyesi) | 14.549 $ | 11.165 $ | 9.107 $ |
| OSWorld-2.1 (çevrimdışı alt küme, bilgisayar kullanımı) | %77,6 | %83,9 | %74,2 |
| MKA (Multimodal Knowledge Agent) | %53,4 | %52,0 | %43,8 |
| Chartography | %66,6 | %61,6 | %63,2 |
| Terminal-Bench-Science 0.1 | %51,4 | %59,9 | %58,3 |
| HLE-Diamond | %58,8 | %53,3 | %47,3 |
Hydrogen 10 satırın 7'sinde önde. Sonnet 5.5 üç satırda önde: Terminal-Bench 4.1, OSWorld-2.1 ve Terminal-Bench-Science. Terra hiçbir satırda birinci değil; Terminal-Bench-Science'ta Hydrogen'in önünde, Agents' Last Exam'de ise Hydrogen'e iki puandan az farkla yakın.
Tabloyu okurken dört şeye dikkat edin:
- Ölçütleri üretici seçti. Bu, Google'ın Hydrogen'i tanıtmak için hazırladığı tablo. Geride kaldığı üç satırı da koymuş olması iyi, ama hangi ölçütlerin tabloya girdiğine Google karar verdi.
- Rakip sayıları çoğunlukla Google'ın kendi koşusu değil. Google'ın değerlendirme yöntemi belgesine göre Hydrogen sonuçları tek denemeyle (pass@1), Gemini API üzerinden ve aksi belirtilmedikçe en yüksek düşünme ayarıyla alındı. Google dışındaki modellerin sayıları ise aksi belirtilmedikçe üreticilerin kendi bildirdiği değerler; Sonnet 5.5 ve Terra için en yüksek düşünme ayarındaki sonuç, o yoksa bulunan en iyi sonuç kullanılmış.
- Satır satır kaynak. SWE-sweep, Terminal-Bench 4.1 ve Terminal-Bench-Science'ta Hydrogen'i Google kendi koşmuş, rakiplerin sayıları resmî liderlik tablolarından. AutomationBench-AA ve HLE-Diamond Artificial Analysis'in tablosundan, Vending-Bench 2 Andon Labs'in tablosundan. Agents' Last Exam'da Hydrogen'i ve Sonnet 5.5'i Google koşmuş, Terra liderlik tablosundan. Chartography'de Hydrogen'i ve Terra'yı Google koşmuş, Sonnet 5.5 sistem kartından. MKA'da Hydrogen Google'ın koşusu, diğerleri Artificial Analysis'ten.
- İki satırda koşullar eşit değil. Terminal-Bench 4.1'de Hydrogen
highseviyesinde (en yüksek olan xhigh'da değil) ve görev başına beş denemenin ortalamasıyla koşulmuş. OSWorld-2.1'de Hydrogen ve Sonnet 5.5 için üç koşunun en iyisi alınmış, Terra'nın değeri ise sistem kartından. Bu ikisi, Sonnet 5.5'in önde olduğu satırlar. Aşağıda göreceğiniz gibi düşünme seviyesi sonucu çok değiştiriyor. - Terminal-Bench sürümü farklı. Bu tabloda Terminal-Bench 4.1 (hile düzeltmeli) var. Carbon karşılaştırmasındaki tabloda Terminal-Bench 4.0 kullanılmıştı (Carbon %65,2, Argon %57,1). İki sürümün sayılarını aynı sütuna koymayın.
- SWE-sweep'te herkes düşük. Hydrogen'in %13,5'i rakiplerinin birkaç katı, ama mutlak değer olarak görevlerin büyük kısmını üç model de çözemiyor.
Bağımsız ölçümler: düşünme seviyesi her şeyi değiştiriyor
Artificial Analysis, modelleri farklı düşünme seviyelerinde ayrı ayrı ölçüyor. Intelligence Index v5.0.1 sayfasındaki değerler (14 Kasım 2026'da kontrol ettim):
| Model (düşünme seviyesi) | Endeks | Endeks görevi başına maliyet | Görev başına süre |
|---|---|---|---|
| Hydrogen xhigh | 54 | 3,16 $ | 14,1 dk |
| Hydrogen high (varsayılan) | 51 | 1,87 $ | 7,8 dk |
| Hydrogen medium | 41 | 0,80 $ | 3,7 dk |
| Hydrogen low | 27 | 0,29 $ | 1,3 dk |
| Claude Sonnet 5.5 max | 55 | 10,02 $ | 34,0 dk |
| Claude Sonnet 5.5 xhigh | 50 | 4,09 $ | 14,6 dk |
| Claude Sonnet 5.5 high | 42 | 1,64 $ | 6,8 dk |
| GPT-6.1 Sol max | 55 | 1,27 $ | yok |
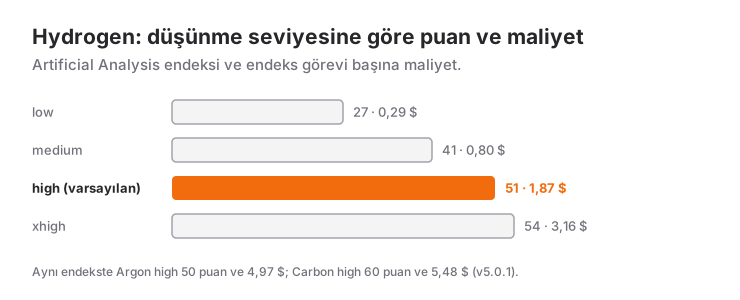
Bu tablodan çıkanlar:
- Aynı seviyede Hydrogen önde. high ayarında Hydrogen 51, Sonnet 5.5 42. Görev başı maliyetleri yakın (1,87 $ ve 1,64 $).
- En üst ayarda Sonnet 5.5 bir puan önde. Sonnet 5.5 max 55, Hydrogen xhigh 54. Ama Sonnet bu puana görev başına 10,02 $ ile ulaşıyor; Hydrogen'in 3,16 $'ının yaklaşık üç katı.
- Benzer puan, farklı fatura. Hydrogen high (51) ile Sonnet 5.5 xhigh (50) neredeyse aynı puanda. Hydrogen bunu yarısından az maliyetle ve yaklaşık yarı sürede yapıyor.
- Hydrogen'de varsayılanı düşürmek pahalıya patlıyor. high'dan medium'a inince puan 51'den 41'e, low'da 27'ye düşüyor. Maliyeti kısmak için seviyeyi indirirseniz farklı bir model kullanıyormuş gibi olursunuz.
- Terra satırı yok. Artificial Analysis'te GPT-6.1 Terra için bir satır bulamadım. Tablodaki OpenAI modeli GPT-6.1 Sol; Google'ın tablosundaki ise Terra. Bunlar farklı modeller, birinin sayısını diğerinin yerine koymayın.
Terminal işinde bağımsız veri Google'ın tablosuyla aynı yönü gösteriyor. DataCamp'in aktardığına göre Artificial Analysis'in kendi Terminal-Bench 4.0 koşusunda Hydrogen yaklaşık %54 (BenchLM %53,5 olarak listeliyor), Claude Sonnet 5.5 %64, GPT-6.1 Sol %56. DataCamp'in vardığı sonuç: Hydrogen terminal ağırlıklı işler için eldeki en iyi model değil.
Gemini 4 ailesi içinde Hydrogen nerede?
Aynı Artificial Analysis sayfasında, high seviyesinde Gemini 4 Carbon 60, Hydrogen 51, Gemini 4 Argon 50 puan alıyor.
| Model (high) | Endeks | Endeks görevi başına maliyet | Görev başına süre |
|---|---|---|---|
| Gemini 4 Carbon | 60 | 5,48 $ | 29,0 dk |
| Gemini 4 Hydrogen | 51 | 1,87 $ | 7,8 dk |
| Gemini 4 Argon | 50 | 4,97 $ | 30,0 dk |
Yani Hydrogen, Argon'la aynı puan bandında, ama görev başına belirgin biçimde ucuz ve hızlı. Carbon dokuz puan önde ve karşılığında görev başına yaklaşık üç kat maliyet istiyor. (Carbon karşılaştırmamda NeuralTrust'ın aktardığı görev başı maliyetler daha yüksekti; buradakiler endeksin güncel v5.0.1 sayfasındaki değerler.)
Google'ın kendi tablolarında da benzer bir resim var, ama Hydrogen ve Carbon tabloları ayrı tablolar; her birini kendi içinde okuyun. Agents' Last Exam v1.1'de Carbon %77,4, Hydrogen %71,6, Argon %69,0. OSWorld-2.1'de Carbon %81,5, Hydrogen %77,6, Argon %74,7. Chartography'de Hydrogen (%66,6) hem Carbon'un (%72,5) hem Argon'un (%71,6) gerisinde. Tek ters örnek SWE-sweep: Hydrogen %13,5, Carbon %9,6. Carbon'un rakipleriyle karşılaştırması ayrı yazıda.
Yanılma, hız ve gevezelik
Yanılma oranı. BenchLM'in Artificial Analysis'e dayanarak verdiği AA-Omniscience değerlerine göre Hydrogen'in yanılma oranı %8,5, doğruluğu %50,5 (DataCamp oranı "%8" diye yazıyor). Bu oran, modelin bilmediği bir soruda "bilmiyorum" demek yerine yanlış cevap verme sıklığı; düşük olması iyi. Önceki yazılarımdaki değerlerle yan yana koyunca Hydrogen, Argon (%4) ile Carbon (%11) arasında kalıyor. Sonnet 5.5 ve Terra için elimde bu ölçütten bir değer yok. Google ise Gemini 3.8 Flash'a göre uydurma iddiaların 5 kattan fazla azaldığını söylüyor; bu Google'ın kendi ölçümü ve karşılaştırma rakiplerle değil, eski Flash modeliyle.
Hız. Artificial Analysis'in model sayfasında xhigh ayarında saniyede 182 çıktı tokenı görünüyor. İlk cevap tokenına kadar geçen süre xhigh'da 42,9 saniye, high'da 16,3 saniye. Sayfa, modeli görev başına ortalamadan yavaş diye tarif ediyor. Google'ın, modelin varsayılan high ayarında işleri Gemini 3.8 Flash'a göre 2,5 kat hızlı bitirdiği iddiası kendi ölçümü ve yöntemi yayımlanmadı.
Gevezelik. Hydrogen endeksi xhigh ayarında tamamlamak için 304 milyon çıktı tokenı harcamış; ortanca 77,3 milyon. Artificial Analysis bunu "çok geveze" diye niteliyor. Token başı fiyat düşük olsa da harcanan token sayısı yüksek; görev başı maliyet tablosuna bakmanın sebebi bu.
Fiyat
| Model | Girdi (1M token) | Çıktı (1M token) | Kaynak |
|---|---|---|---|
| Gemini 4 Hydrogen (standart) | 1,50 $ | 7,50 $ | Google fiyat sayfası |
| Gemini 4 Hydrogen (Batch / Flex) | 0,75 $ | 3,75 $ | Google fiyat sayfası |
| Claude Sonnet 5.5 | 2 $ | 10 $ | Üçüncü taraf liste |
| GPT-6.1 Terra | 1 $ | 5 $ | Üçüncü taraf liste |
| GPT-6.1 Sol | 2 $ | 10 $ | Üçüncü taraf liste |
| Gemini 4 Argon ve Carbon | 2 $ (1 Aralık'tan itibaren 4 $) | 10 $ (1 Aralık'tan itibaren 20 $) | Google fiyat sayfası |
Hydrogen fiyatlarını Google'ın fiyat sayfasında 14 Kasım 2026'da kontrol ettim. Hydrogen'in ayrıca hız sınırlı bir ücretsiz API katmanı var; Argon ve Carbon'da yok. Claude ve GPT fiyatları üçüncü taraf listelerden geliyor, satıcıların kendi sayfalarından doğrulamadım; karar vermeden önce resmî sayfaya bakın.
Liste fiyatına göre en ucuz Terra, sonra Hydrogen. Ama Hydrogen'de düşünme tokenları da çıktı fiyatından faturalanıyor ve modeller aynı iş için farklı sayıda token harcıyor. O yüzden liste fiyatı tek başına yetmez; yukarıdaki görev başı maliyet daha gerçekçi bir ölçü.
Hangisini ne zaman seçmeli?
Bu kısım benim yorumum; yukarıdaki sayılardan çıkardığım genel sonuçlar.
- Ücretsiz başlamak ya da düşük bütçe: Hydrogen. Ücretsiz API katmanı var ve varsayılan ayarda görev başı maliyeti düşük.
- Terminalde çalışan ajanlar: Sonnet 5.5. Hem Google'ın tablosu hem Artificial Analysis'in koşusu aynı şeyi söylüyor.
- Bilgisayar kullanımı (OSWorld): Sonnet 5.5.
- Uçtan uca iş akışları ve otomasyon: Google'ın tablosunda Hydrogen önde (Agents' Last Exam, AutomationBench-AA), ama bu satırlar için bağımsız bir doğrulama görmedim.
- Grafik ve çok kipli sorular: Hydrogen az farkla önde (Chartography, MKA).
- En yüksek puan gerekiyorsa: Bu üçlü yerine bir üst sınıfa bakın. Sonnet 5.5 max ile Hydrogen xhigh arasında bir puan var; Carbon 60'ta.
- GPT-6.1 Terra: Liste fiyatı en düşük ve Agents' Last Exam'de Hydrogen'e yakın. Bağımsız endeks verisi bulamadığım için daha fazlasını söyleyemem.
Benchmark'lara nasıl bakmalı?
- Üretici tablosu üreticinin seçtiği ölçütlerdir. Hız, gevezelik ve yanılma oranı Google'ın tablosunda değil, üçüncü tarafların sayfalarında.
- Düşünme seviyesini sorun. "Hydrogen 51 aldı" cümlesi ancak "high ayarında" eklenince anlam kazanıyor. Karşılaştırılan iki model aynı seviyede mi, bakın.
- Ajan çerçevesi sonucu değiştirir. Aynı model farklı bir araç setiyle farklı puan alır. Harness nedir yazısında bunu anlattım.
- Kendi görevinizi ölçün. Beş kendi göreviniz, elli başkasının görevinden daha öğretici.
Daha üst sınıftaki modellerin aynı ölçütlerde nerede durduğunu görmek için Claude Fable 5.2 karşılaştırmasına bakabilirsiniz.
Sık Sorulan Sorular
Gemini 4 Hydrogen, Claude Sonnet 5.5'ten daha mı iyi?
İş türüne bağlı. Google'ın tablosunda 10 satırın 7'sinde Hydrogen önde; terminal işinde ve bilgisayar kullanımında Sonnet 5.5 önde. Artificial Analysis endeksinde aynı düşünme seviyesinde Hydrogen, en yüksek ayarda Sonnet 5.5 bir puan önde.
Hydrogen, GPT-6.1 Terra'dan iyi mi?
Google'ın tablosunda değeri verilen dokuz satırın sekizinde Hydrogen önde; Terra yalnızca Terminal-Bench-Science'ta Hydrogen'in üstünde. Terra için bağımsız bir Artificial Analysis satırı bulamadım, o yüzden bu karşılaştırma tek kaynağa dayanıyor.
Kod yazmak için hangisi daha iyi?
Terminalde komut çalıştıran ajan işleri için ölçümler Sonnet 5.5'i gösteriyor. Var olan kodu bozmadan hata onarmayı ölçen SWE-sweep'te Hydrogen önde, ama oradaki mutlak değerler düşük. Kendi kod tabanınızda denemeden karar vermeyin.
Hangisi daha ucuz?
Liste fiyatında Terra (1 $ / 5 $, üçüncü taraf liste), sonra Hydrogen (1,50 $ / 7,50 $), sonra Sonnet 5.5 (2 $ / 10 $, üçüncü taraf liste). Artificial Analysis'in görev başı maliyetinde Hydrogen high 1,87 $, Sonnet 5.5 high 1,64 $; üst ayarlarda Sonnet belirgin biçimde pahalı.
Hydrogen daha çok mu uyduruyor?
AA-Omniscience ölçümünde yanılma oranı %8,5; Argon'dan (%4) yüksek, Carbon'dan (%11) düşük. Sonnet 5.5 ve Terra için aynı ölçütten bir değer elimde yok.
Düşünme seviyesi neden bu kadar önemli?
Çünkü aynı model farklı seviyede çok farklı puan alıyor: Hydrogen low'da 27, high'da 51, xhigh'da 54. Maliyet ve süre de seviyeyle birlikte artıyor.
Kaynak
- Google DeepMind, Gemini 4 Hydrogen: Model evaluation (Kasım 2026): her ölçütte Hydrogen ve rakip sayılarının nasıl elde edildiği.
- Google, Introducing Gemini 4 Hydrogen (12 Kasım 2026): karşılaştırma tablosu (görsel), hız ve uydurma iddiaları.
- Google DeepMind, Gemini modelleri sayfası: benchmark tablosunun metin hali, aynı aileden Carbon ve Argon değerleri.
- Google DeepMind, Gemini 4 Hydrogen model kartı: benchmark değerleri.
- Google, Gemini API fiyatlandırma: Hydrogen, Argon ve Carbon fiyatları, ücretsiz katman (14 Kasım 2026'da kontrol edildi).
- Artificial Analysis, Gemini 4 Hydrogen: hız, ilk token süresi, harcanan çıktı tokenı.
- Artificial Analysis, model liderlik tablosu: düşünme seviyesine göre endeks, görev başı maliyet ve süre.
- DataCamp, Gemini 4 Hydrogen (13 Kasım 2026): Artificial Analysis'in Terminal-Bench 4.0 koşusu, yanılma oranı.
- BenchLM, Gemini 4 Hydrogen (13 Kasım 2026): AA-Omniscience yanılma oranı ve doğruluk, Terminal-Bench değeri.
İlgili Yazılar
Gemini 4 Hydrogen'i Denedim: 4 Düşünme Seviyesi, 1 Görev
Aynı kodlama görevini Gemini 4 Hydrogen'e dört düşünme seviyesinde verdim. Dördü de doğru çözdü; süre 14 saniyeden 198 saniyeye, token 14 katına çıktı.
Gemini 4 Hydrogen Ücretsiz mi? Kimler Kullanabilir?
Gemini 4 Hydrogen üç yerde ücretsiz: Gemini uygulaması, Google Arama ve API'nin ücretsiz katmanı. Ücretli fiyatlar, örnek hesap ve planlara göre erişim.
Gemini 4 Hydrogen Nedir? Özellikler, Fiyat, Benchmark
Google 12 Kasım 2026'da Gemini 4 Hydrogen'i herkese açtı: 1 milyon tokenlık pencere, 1,50 $ girdi fiyatı ve ücretsiz API katmanı. Özellikler ve ölçümler.