JEV Kullanım Alanları: 10 Gerçek Senaryo ve Maliyet Hesabı
7 dk okuma
JEV'in ne olduğunu ve üç soru tipini anlattım. Şimdi asıl soruya geldik: bununla ne yapacaksınız?
Bu soru göründüğünden zor, çünkü JEV bir ürün değil bir parça. Kutudan çıkan bir çözüm bekliyorsanız hayal kırıklığı yaşarsınız. Ama "kodumda hangi kararları pahalı bir modele sorduğum için yapmaktan vazgeçtim?" diye sorarsanız, liste hızla uzuyor.
Aşağıda on senaryo var. Hepsinin ortak paydası şu: karar kapalı bir kümeden geliyor, hacim yüksek, gecikme önemli ve bugüne kadar ya anahtar kelimeyle ya da pahalı bir LLM çağrısıyla çözülüyordu.
1. Yorum ve mesaj moderasyonu
En doğrudan senaryo. Gelen her yoruma tek çağrıda birkaç soru birden sorarsınız: spam mi, hakaret mi, şaka mı, soru mu, istek mi?
questions = {
    "tip": Choice(
        instructions="`yorum` hangi kategoriye giriyor?",
        criteria={
            "soru": "Bir şey soruyor.",
            "istek": "İçerik ya da özellik talebi.",
            "elestiri": "Olumsuz ama yapıcı geri bildirim.",
            "spam": "Reklam, bağlantı tuzağı ya da toplu gönderim.",
            "hakaret": "Kişiye yönelik saldırgan dil.",
            "muhabbet": "Genel sohbet.",
        },
    ),
    "aksiyon_gerekli": Noul(instructions="Bu yoruma moderatör müdahalesi gerekiyor mu?"),
}
Anahtar kelime listeleriyle yapılan moderasyonun kronik sorunu, anlamı kaçırması: "sen bu kafayla modem resetlersin" cümlesi kelime listesinde hakaret, bağlamında şakadır. Kapalı kümeden karar veren bir model bu farkı yakalıyor.
Kamuya açık bir denemede 805 YouTube yorumunun tek seferde sınıflandırılması yaklaşık 37 saniye sürmüş ve 14 sente mal olmuş. Aynı hacmi bir sohbet modeline tek tek sorduğunuzda hem süre hem fatura başka bir mertebeye çıkıyor.
2. E-posta ve destek talebi triyajı
Gelen kutusu sınıflandırma, JEV'in en rahat çözdüğü iş. Fatura mı, sponsorluk teklifi mi, resmî bir belge mi, destek talebi mi? Üstüne aciliyet skoru ve "kişisel veri içeriyor mu" kontrolü ekleyin — hepsi aynı çağrıda.
Buradaki asıl kazanç sınıflandırma değil, yönlendirme: hangi ekibe, hangi kuyruğa, hangi SLA'ya gideceği. Yanlış kuyruğa düşen bir talebin maliyeti, çağrının maliyetinin binlerce katı.
3. Ajan için araç seçimi
Bir ajana 150 araç tanımlamak istiyorsunuz. Hepsini bağlama yüklerseniz hem pahalı hem de model dikkatini dağıtıyor. Çözüm: araç listesini JEV'e sordurmak.
Her turda, o anki bağlama göre JEV hangi araçların ilgili olduğuna karar veriyor; ana ajanın bağlamına yalnızca o birkaç araç giriyor. Ana modelin bağlamı şişmiyor, maliyet düşüyor, doğruluk artıyor.
TypeSafe'in yayımladığı bir örnek çalışmada bu tam olarak ölçülmüş: 182 yetenekten oluşan bir katalogda, bir istek için en fazla bir yeteneği seçmek üzere iki aşamalı bir kurgu kullanılıyor — önce tek çağrıda bütün katalog sıralanıyor ve "bu tur gerçekten bir yeteneğe ihtiyaç duyuyor mu?" sorusu soruluyor, sonra ilk üç aday düzgünce okunup hepsi reddedilebiliyor.
4. Model ve alt ajan yönlendirme (router)
Elinizde farklı güçte modeller var. Basit görevi küçük modele, zor görevi güçlü modele vermek istiyorsunuz. Bunu sohbet akışının ortasında modeli değiştirerek yapamazsınız — önbelleği bozar, bağlamı dağıtır.
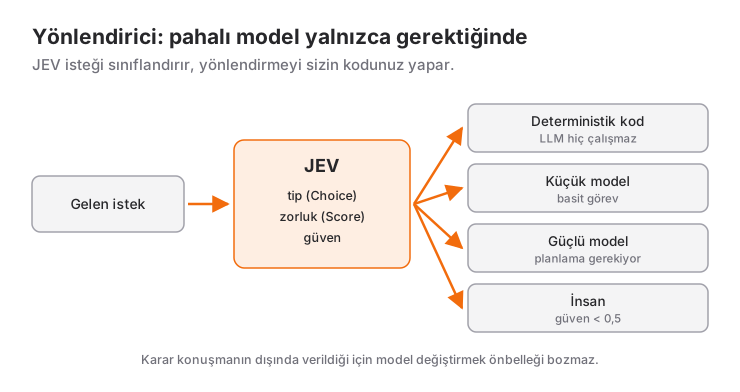
Ama kararı dışarıda, JEV ile verirseniz temiz çalışıyor:
questions = {
    "gorev_tipi": Choice(
        instructions="Kullanıcının isteği hangi tipte?",
        criteria={
            "arama": "Bilgi bulma ya da veritabanı sorgusu.",
            "duzenleme": "Var olan metin ya da kod üzerinde küçük değişiklik.",
            "tasarim": "Mimari karar ya da çok adımlı planlama.",
        },
    ),
    "zorluk": Score(
        instructions="Görev ne kadar zor?",
        criteria=["Tek adımda biter.", "Birkaç adım gerekir.", "Uzun planlama ve doğrulama gerekir."],
    ),
}
Ardından yönlendirmeyi kodda yaparsınız — ve burada güven skorunu kapı olarak kullanırsınız: güven 0,5'in altındaysa karar vermeyin, güçlü modele ya da insana düşürün. Dokümantasyonun intent routing ve confidence-gated routing dediği kalıp bu.
5. Ajanın gereksiz adımlarını kesmek
Bir ajanın en pahalı alışkanlığı, gerekmeyen dosyayı okumak. Her okuma bağlamı şişiriyor, her şişme sonraki turların hepsini pahalılaştırıyor.
Araya tek bir Noul sorusu koyun: "Bu görevi tamamlamak için bu dosyanın içeriği gerçekten gerekli mi?" Cevap 0,3'ün altındaysa okuma atlanır. Tek başına küçük görünen bu kapı, uzun oturumlarda bağlam bütçesinin ciddi kısmını kurtarıyor.
Aynı mantık şurada da işliyor: test çalıştırılsın mı, bu hata kullanıcıya gösterilsin mi, bu adım tekrar denensin mi?
6. RAG için parça filtreleme ve prompt injection kalkanı
Getirdiğiniz her parçayı ana modele vermek hem pahalı hem riskli. Her parçaya tek çağrıda sorun: soruyla alakalı mı, soruyla çelişiyor mu, içinde gizli talimat var mı?
Sonuncusu ciddi bir güvenlik kazancı. Getirilen bir belgeye gömülmüş "önceki talimatları unut" tarzı bir enjeksiyon, ana modele hiç ulaşmadan elenebiliyor. TypeSafe'in belgeleri bu kullanımı ayrı bir kalıp olarak veriyor.
Benzer bir kalıp da alıntı doğrulama: bir cevabın gösterdiği kaynak, iddiayı gerçekten destekliyor mu? Tek bir Choice sorusu bunu karara bağlıyor, güven skoru da şüphelileri insan incelemesine düşürüyor.
7. Arama sonuçlarını yeniden sıralamak
Klasik arama (BM25, vektör araması) hızlıdır ama anlamı kaçırır. Üstüne pahalı bir yeniden sıralayıcı koymak da maliyetli.
JEV burada tam oturuyor: aday listesindeki her parça-sorgu çifti için bir soru sorup sonucu yeniden sıralıyorsunuz. TypeSafe'in yayımladığı bir hukuk verisi çalışmasında, 30 adaylık BM25 listeleri üzerinde bu yöntem ilk sıra doğruluğunu %5'ten %18'e, ilk on doğruluğunu %38'den %62'ye çıkarmış.
8. Yapılandırılmamış metinden alan çıkarma
JEV metin üretmediği için "çıkarma" işini farklı kuruyorsunuz: adayları kodda bulup seçimi modele yaptırıyorsunuz.
Tarih, tutar, telefon numarası gibi alanlarda düzenli ifadeyle adayları çıkarıyor, "istenen değer bunlardan hangisi?" diye Choice soruyorsunuz. Böylece hem verbatim (birebir) bir değer alıyorsunuz hem de modelin uydurma ihtimalini sıfırlıyorsunuz.
Bu ayrım önemli: JEV tarihleri karşılaştıramıyor, sayıları sayamıyor. Ama "bu belgede geçen tarihlerden hangisi son ödeme tarihi?" sorusunu cevaplayabiliyor. Aritmetiği kodda yaparsınız.
9. Kalite ve politika denetimi
Bir metnin özelliklerini puanlamak, JEV'in hızlı olduğu bir alan. Bir içerik için şu soruları tek çağrıda sorabilirsiniz: kaynak gösteriyor mu, kesin iddia atıyor mu, FOMO yaratmaya çalışıyor mu, ürün tanıtımı içeriyor mu, ne kadarı dolgu?
Kamuya açık bir denemede 3,5 dakikalık bir konuşma kaydının somut bilgi / dolgu / tekrar / muğlaklık / öz tanıtım eksenlerinde puanlanması 1 sent civarında bir maliyetle yapılmış. Aynı ölçümü büyük bir modele yaptırmak, yüzlerce içerik ölçeğinde bütçe meselesine dönüşüyor.
LLM ürünleri için aynı yapı guardrail oluyor: modele giden ve modelden çıkan her mesajı tek çağrıda tarayıp "bu bir jailbreak denemesi mi", "uyulması ne kadar zarar verir" sorularını sormak.
10. Oyun, simülasyon ve anlık karar
Son senaryo, en eğlencelisi ve mimari olarak en öğreticisi. Oyunlarda ve simülasyonlarda her karede alınacak kararlar var: bu bloğu kır, bu düşmandan kaç, bu birliği şuraya taşı.
Bir LLM bu döngüye giremiyor — hem yavaş hem pahalı. JEV, önüne konan seçenekler arasından anlık seçim yaparak girebiliyor. Uzun vadeli planı bir LLM kurarken anlık refleksleri JEV'in verdiği kurgular, kamuya açık demolarda gösterildi.
Aynı mimari oyun dışında da geçerli: robotik, trafik simülasyonu, tarayıcı otomasyonu. "Şu anki ekranda hangi öğeye tıklanmalı?" tam bir Choice sorusu.
Maliyet hesabı: neden bu kadar fark ediyor?
Somutlaştıralım. Diyelim günde 50.000 kısa metin sınıflandırıyorsunuz, her biri ortalama 400 token.
- Toplam girdi: 20 milyon token/gün.
- JEV fiyatı milyon girdi token'ı başına 0,042 dolar, çıktı ücretsiz.
- Günlük maliyet: 1 dolar civarı.
Aynı işi orta seviye bir sohbet modeline yaptırdığınızda, token fiyatları bir-iki basamak yukarıda olduğu ve çıktı token'ları da ücretlendirildiği için bu rakam üç haneli dolara çıkıyor. Kamuya açık bir karşılaştırmada aynı testin büyük bir akıl yürütme modelinde 176 dolara, JEV'de 39 sente mal olduğu paylaşıldı.
Asıl mesele tasarruf değil, eşiğin değişmesi. 176 dolarlık bir kontrolü her isteğe koyamazsınız; 39 sentlik kontrolü koyarsınız. Fiyat düştüğünde daha ucuz yapmıyorsunuz — daha önce hiç yapmadığınız şeyi yapmaya başlıyorsunuz.
Bu listeden kendi senaryonuzu nasıl çıkarırsınız?
Kod tabanınızda şu üç şeyi arayın:
- Anahtar kelime listeleri.
if "iade" in mesajtarzı her kontrol, anlamı kaçıran sahte bir kuraldır ve JEV adayıdır. - "Her ihtimale karşı" yapılan pahalı çağrılar. Ajanınızın her turda okuduğu dosyalar, her istekte çağırdığı LLM'ler. Önlerine bir kapı sorusu koyun.
- Hiç yapmadığınız kontroller. "Keşke her yorumu kontrol edebilsek ama pahalı" dediğiniz her yer. Fiyat artık o cümlenin geçerliliğini kaldırıyor.
Kodlama ajanı kullanıyorsanız bu taramayı ona da yaptırabilirsiniz; TypeSafe'in resmî agent skill'i tam olarak "projede kırılgan ayrıştırma kodunun yerine akıllı kararın geçebileceği yerleri bul" işini hedefliyor.
Üretime almadan önce mutlaka sınırları ve harness kurulumunu okuyun — çünkü bu senaryoların hiçbiri modeli takıp bırakmakla çalışmıyor.
Buradaki ölçümler TypeSafe'in yayımladığı örnek çalışmalara ve kamuya açık denemelere dayanıyor; kendi iş yükünüzde farklı sonuç alabilirsiniz.
Sık Sorulan Sorular
JEV en çok nerede işe yarıyor?
Kararın kapalı bir kümeden geldiği, hacmin yüksek ve gecikmenin önemli olduğu yerlerde: moderasyon, e-posta ve talep triyajı, ajanlar için araç ve model seçimi, RAG parçalarını filtreleme, arama sonuçlarını yeniden sıralama, kalite ve politika denetimi.
JEV bir LLM'in yerini alabilir mi?
Hayır. JEV metin üretmez; yazma, özetleme, çeviri ve kod üretme hâlâ LLM işidir. JEV bu modellerin önüne konan karar katmanıdır: hangi modelin, hangi bağlamla, ne zaman çalışacağını ucuza belirler.
JEV gerçekten ne kadar ucuz?
Girdi tarafı milyon token başına 0,042 dolar, çıktı ücretsiz. Günde 50.000 kısa metni sınıflandıran bir iş yükü, kabaca 1 dolar civarında bir günlük maliyete karşılık geliyor. Aynı işin sohbet modelleriyle maliyeti iki-üç basamak yukarıda kalıyor.
JEV'i ajanıma nasıl bağlarım?
En yaygın üç bağlanma noktası: araç seçimi (bağlama göre yalnızca ilgili araçları yüklemek), model yönlendirme (görevin tipine ve zorluğuna göre doğru modeli seçmek) ve kapı kararları (bu dosya okunsun mu, bu adım atlansın mı). Üçünde de kararı JEV verir, uygulamayı sizin kodunuz yapar.
Yorum moderasyonu için JEV yeterli mi?
Sınıflandırma tarafında oldukça iyi çalışıyor, ancak kararı doğrudan uygulamak yerine güven skoruna göre kademelendirmek gerekiyor: yüksek güvenli spam otomatik silinir, düşük güvenli vakalar insan incelemesine düşer. Ayrıca modelin, kendi sınıfını savunmak için yazılmış metinlerden etkilenebildiği dokümantasyonda açıkça belirtiliyor.
İlgili Yazılar
JEV Nedir? Yapay Zekânın Refleks Katmanı (System One Modeli)
JEV bir sohbet modeli değil; karar veren bir model. System One mantığını, üç soru tipini, fiyatını ve sınırlarını ilk çağrıdan itibaren anlatıyorum.
JEV'i Sisteminize Bağlamak: Harness, Maliyet ve Bilinen Sınırlar
JEV tek başına bir olasılık bulutu üretir. Kararı eyleme çeviren harness'ı nasıl kurarsınız, hangi mimari kalıpları kullanırsınız ve modelin bilinen zayıf noktaları neler?
JEV Soru Tipleri: Choice, Score ve Noul'u Doğru Kullanmak
JEV'in üç soru tipini, kriter yazmanın kurallarını, olasılık ile güven farkını ve tek çağrıda onlarca soru sormanın maliyet etkisini örneklerle anlatıyorum.