JEV Soru Tipleri: Choice, Score ve Noul'u Doğru Kullanmak
7 dk okuma
JEV'in ne olduğunu anlattığım yazıda üç soru tipinden kısaca bahsetmiştim. Pratikte işin kalitesini belirleyen şey tam olarak burası: JEV'den aldığınız cevabın değeri, sorduğunuz sorunun biçimine bağlı. Yanlış tipi seçmek ya da kriterleri özensiz yazmak, modeli suçlamanıza yol açan en yaygın sebep.
Bu yazıda üç tipi tek tek, çalışan kodla ve ne zaman hangisini seçeceğinizle anlatıyorum. Sonunda da asıl kazancın nerede olduğunu göstereceğim: tek çağrıda onlarca soru sormak.
Üç tip, üç cevap biçimi
| Tip | Soru | Dönen alanlar |
|---|---|---|
| Choice | "Bunlardan hangisi?" | choice, probabilities, confidence |
| Score | "Hangi seviye?" | score, legend, probabilities, confidence |
| Noul | "Bu doğru mu?" | noul (0-1 arası olasılık) |
Üçü de aynı istekte karışık kullanılabiliyor ve hepsi aynı state (durum) üzerinde çalışıyor.
Choice: sıralaması olmayan kapalı küme
Cevap, aralarında sıralama ilişkisi olmayan bilinen bir kümedense Choice kullanın: talebi departmana yönlendirmek, belge tipini sınıflandırmak, bir kod parçasının dilini belirlemek.
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state={"mail": "Merhaba, eylül ayı faturanızı ekte gönderiyoruz."},
    questions={
        "mail_tipi": Choice(
            instructions="`mail` hangi kategoriye giriyor?",
            criteria={
                "fatura": "Bir ödeme belgesi ya da fatura iletiliyor.",
                "sponsorluk": "İşbirliği ya da reklam teklifi.",
                "destek": "Bir ürün ya da hizmetle ilgili sorun bildiriliyor.",
                "spam": "İstenmeyen toplu gönderim.",
            },
        ),
    },
)

answer = response.answers["mail_tipi"]
print(answer.choice)         # "fatura"
print(answer.probabilities)  # {"fatura": 0.94, "spam": 0.03, ...}
print(answer.confidence)     # 0.91
Bir Choice sorusunda en fazla 255 seçenek tanımlayabiliyorsunuz. Bu sayı ilk bakışta fazla gelebilir; ama 182 yetenekten birini seçmek ya da bir belgeyi 75 sektör grubundan birine yerleştirmek gibi işler TypeSafe'in kendi örnek çalışmalarında yer alıyor. Yani 255, süs değil, tasarım kararı.
İki pratik kural:
- Seçenek açıklaması yazın, sadece etiket değil.
"fatura"yerine"fatura": "Bir ödeme belgesi ya da fatura iletiliyor."Model etiketten değil, tanımdan karar veriyor. - Kümeyi kapatın. Hiçbirine uymayan girdiler için bir
"diğer"ya da"belirsiz"seçeneği bırakın. Yoksa model en yakın yanlış kutuya zorlanır.
Score: tarif edilebilir bir cetvel
Cevap bir spektruma düşüyorsa ve o spektrumun her noktasını kelimelerle tarif edebiliyorsanız Score kullanın: hata önem derecesi, müşteri sinirlilik seviyesi, aday deneyimi.
from typesafe_sdk import Score

questions = {
    "aciliyet": Score(
        instructions="Bu destek talebi ne kadar acil?",
        criteria=[
            "Bilgi amaçlı, beklemeye alınabilir.",
            "Kullanıcı rahatsız ama işi devam ediyor.",
            "İş durmuş, aynı gün müdahale gerekiyor.",
            "Veri kaybı ya da güvenlik riski var.",
        ],
    ),
}
Score en az iki seviye ister, API en fazla 10 seviye kabul ediyor. Seviye sayısını artırmak doğruluk getirmiyor; tam tersine, birbirinden ayırt edilemeyen seviyeler dağılımı bulanıklaştırıyor. Üç-dört iyi tarif edilmiş seviye, sekiz muğlak seviyeden daha iyi çalışıyor.
Kritik bir sınır: dokümantasyon, Score seviyelerinin sayısal kalibrasyonunun zayıf olduğunu açıkça söylüyor. Yani "2 ile 3 arasında bir yerde, 2,4 civarı" gibi bir ara değer üretmeye çalışmayın. Score'u eşik kontrolü için kullanın ("2'nin üstü mü?"), ölçüm için değil.
Noul: olasılığın kendisi sinyalse
Temiz bir evet/hayır sorunuz varsa ve olasılığın kendisi işinize yarıyorsa Noul kullanın: bu mesaj kişisel veri içeriyor mu, müşteri iade mi istiyor, bu cümle kaynak göstermeden kesin iddia mı atıyor.
from typesafe_sdk import Noul

questions = {
    "kisisel_veri": Noul(
        instructions="`mesaj` içinde telefon, adres ya da kimlik numarası geçiyor mu?",
    ),
}
# response.answers["kisisel_veri"].noul -> 0.02
Buradaki en sık hata, 0,5'i "orta seviye" sanmak. 0,5 orta değil, kararsız demek. "Adayın orta düzey deneyimi var" anlamına gelmiyor; "evet ile hayır eşit olasılıkta" anlamına geliyor. Orta seviye istiyorsanız o Score sorusudur, Noul değil.
Kriter ve talimat yazmanın kuralları
Üç tipte de girdi aynı iki alandan oluşuyor: instructions (sorduğunuz soru) ve criteria (seçenekler, seviyeler ya da evet/hayır açıklaması).
JEV yazdığınız soruyu cevaplıyor, kastettiğiniz soruyu değil. Kapsam belirten kelimeler, olumsuzlamalar ve ima edilen koşullar birebir okunuyor. Bu yüzden:
- Durumun alanlarına adıyla atıfta bulunun.
`ticket.messages[0].text`gibi. "Metinde" demek yerine hangi alandan bahsettiğinizi söyleyin. - Çift olumsuzdan ve dolaylı anlatımdan kaçının. "Uygunsuz olmayan içerik değil mi?" gibi bir soru doğruluk kaybettiriyor. Dokümantasyon buna indirection diyor ve her ek çıkarım adımının doğruluktan yediğini söylüyor.
- Talimat ile kriterleri çelişkiye düşürmeyin. İkisi farklı şeyler istiyorsa model şaşırıyor. Kriterleri talimatın devamı gibi yazın.
- Muğlak soruyu bölün. "Bu talep hem acil hem de yetkilendirme gerektiriyor mu?" tek soru değil, iki sorudur. İkisini ayrı sorup birleştirmeyi kodda yapın.
- Durumu temizleyin. Kararla ilgisi olmayan içerik doğruluğu düşürüyor. İlgili alanları kodda seçip gönderin; her şeyi atıp modelin ayıklamasını beklemeyin.
Bu beş maddeyi uygulamak, model değiştirmekten daha çok fark yaratıyor.
Olasılık ve güven: aynı şey değil
Choice ve Score cevaplarında iki ayrı sayı dönüyor ve karıştırılmaları çok yaygın.
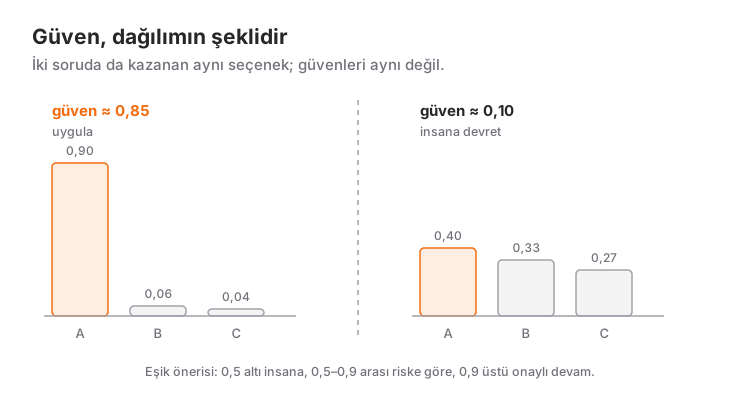
Olasılık (probabilities), her seçeneğe ayrı ayrı verilen ihtimal. Güven (confidence) ise bu dağılımın şeklini özetleyen tek bir sayı: olasılık tek bir seçenekte toplanmışsa yüksek, seçeneklere yayılmışsa düşük.
Üç seçenekli bir soruda [0,90 / 0,06 / 0,04] ile [0,40 / 0,33 / 0,27] dağılımlarını düşünün. İkisinde de "kazanan" birinci seçenek, ama ikincisinde model neredeyse yazı tura atıyor. Güven skoru bu farkı tek sayıya indiriyor; üç seçenek için yaklaşık (3 × en büyük olasılık − 1) / 2 şeklinde hesaplanıyor. Dağılım tamamen tek noktada toplanırsa 1,0; eşit dağılırsa 0,0 oluyor.
Dokümantasyonun önerdiği eşikler şöyle:
- 0,5'in altı: model gerçekten emin değil. Tahmin yürütmeyin; insana yönlendirin ya da akışı durdurun.
- 0,5 - 0,9: düşük riskli işlerde doğrudan uygulayın (bilgi göstermek, etiketlemek). Yüksek riskli işlerde kullanıcıya onaylatın.
- 0,9 üstü: geri dönüşü olmayan işlemlerde bile devam edilebilir, ama yine de onay isteyin.
Bunun kıymeti şurada: elinizde iki eksen oluyor. Cevap size ne olduğunu söylüyor, güven ise harekete geçip geçmeyeceğinizi. Klasik bir sınıflandırıcıda bu ikinci eksen yok; ya eşik uydurursunuz ya da hepsine aynı davranırsınız.
Bir uyarı: eşikleri tipler arasında taşımayın. Bir Noul sorusunda işe yarayan 0,7 eşiği, bir Choice sorusunun güven skorunda aynı anlama gelmiyor. Her soru için eşiği kendi verinizle belirleyin.
Asıl kazanç: tek çağrıda onlarca soru
Şimdi en önemli kısma geldik. JEV bir istekteki bütün soruları paralel değerlendiriyor. Soru eklemek yanıt süresini neredeyse hiç değiştirmiyor, yalnızca o sorunun token'ları kadar maliyet ekliyor — ki o da çok ucuz.
response = client.system_one(
    state=state,
    questions={
        "iade_talebi": Noul(instructions="Müşteri para iadesi mi istiyor?"),
        "talep_tipi": Choice(instructions="Ana talep ne?", criteria={...}),
        "sinirlilik": Score(instructions="Müşteri ne kadar sinirli?", criteria=[...]),
        "kisisel_veri": Noul(instructions="Kişisel veri geçiyor mu?"),
        "yetki_gerekli": Noul(instructions="Yönetici onayı gerekiyor mu?"),
    },
)
TypeSafe'in yayımladığı bir örnek çalışmada, 13 soruluk bir değerlendirmenin tek çağrıda sorulması, 13 ayrı çağrıya kıyasla yaklaşık 12 kat daha ucuz ve 10 kat daha hızlı oluyor — hem de cevaplar değişmeden.
Bu, alışkanlığınızı tersine çeviriyor. Normalde "gerekmedikçe sorma" diye düşünürüz; burada tam tersi rasyonel: belki lazım olur dediğiniz soruları da sorun. Dokümantasyonun speculative fan-out dediği kalıp bu. Kullanıcı ekranı hangi yöne giderse gitsin, cevap zaten elinizde; ikinci bir tura gerek kalmıyor.
Aynı mantık şu ana kadar maliyetli olduğu için yapmadığınız şeyleri de açıyor: her gelen mesajda kişisel veri kontrolü, her RAG parçasında alaka ve prompt injection kontrolü, her yanıtta politika kontrolü. Tek tek sorulduğunda pahalı olan bu kontroller, aynı çağrıya eklendiğinde neredeyse bedava.
Hangi tipi seçeceğinizi bilmiyorsanız
Basit bir karar akışı:
- Cevap kapalı bir kümeden mi geliyor ve aralarında sıra yok mu? → Choice
- Cevap bir spektruma mı düşüyor ve her noktayı tarif edebiliyor musunuz? → Score
- Temiz bir evet/hayır mı ve olasılığın kendisi işinize yarıyor mu? → Noul
- Hiçbiri değilse — muhtemelen bu bir üretim işidir ve JEV'in işi değildir.
Dördüncü madde sandığınızdan sık çıkıyor. "Bu maili özetle" JEV sorusu değil. Ama "bu mailin özeti hangi departmana gitmeli" tam JEV sorusu.
Kalıpları gerçek senaryolar üzerinde görmek için JEV kullanım alanları yazısına, üretime almadan önce bilmeniz gereken sınırlar için harness, maliyet ve sınırlar yazısına bakın.
Teknik değerler TypeSafe'in resmî dokümantasyonuna dayanıyor ve sürümle değişebilir.
Sık Sorulan Sorular
JEV'de Choice ve Score arasındaki fark nedir?
Choice, aralarında sıralama olmayan kapalı bir kümeden tek seçenek seçer (departman, belge tipi, dil). Score ise sıralı seviyelerden oluşan bir cetvelde konum belirler (aciliyet, sinirlilik, önem). Cevaplarınız arasında "daha az / daha çok" ilişkisi varsa Score, yoksa Choice kullanın.
Noul cevabında 0,5 ne anlama geliyor?
Kararsızlık. "Orta seviye" demek değil; evet ile hayırın eşit olasılıkta olduğu anlamına geliyor. Ara bir seviye ölçmek istiyorsanız Noul değil Score sorusu yazmanız gerekiyor.
Bir Choice sorusuna kaç seçenek koyabilirim?
API en fazla 255 seçenek kabul ediyor. Pratikte seçeneklerin etiketten ibaret kalmaması, her birinin kısa bir tanımla verilmesi doğruluğu belirgin biçimde artırıyor. Hiçbirine uymayan girdiler için ayrıca bir "belirsiz" seçeneği bırakmak iyi bir alışkanlık.
Güven skoru ile olasılık arasındaki fark nedir?
Olasılık her seçeneğe ayrı ayrı verilen ihtimaldir; güven ise bu dağılımın ne kadar tek noktada toplandığını özetleyen tek bir sayıdır. Aynı kazanan seçenekle çok farklı güven skorları görebilirsiniz; hangi cevaba göre hareket edeceğinize güvene bakarak karar verirsiniz.
Tek çağrıda kaç soru sormalıyım?
Aynı durum üzerine soracağınız tüm soruları tek çağrıya koyun. Sorular paralel değerlendirildiği için ek soru süreyi neredeyse değiştirmiyor, maliyeti de yalnızca kendi token'ları kadar artırıyor. Yayımlanmış bir örnekte 13 sorunun tek çağrıda sorulması, ayrı ayrı sormaya göre yaklaşık 12 kat daha ucuz ve 10 kat daha hızlı.
Soruları Türkçe mi İngilizce mi yazmalıyım?
Dokümantasyon modelin birincil eğitim dilinin İngilizce olduğunu söylüyor. Talimat ve kriterleri İngilizce yazıp değerlendirilecek metni kendi dilinde bırakmak makul bir başlangıç noktası; ancak karar vermeden önce kendi verinizden 50-100 örnekle iki kurulumu karşılaştırın.
İlgili Yazılar
JEV Nedir? Yapay Zekânın Refleks Katmanı (System One Modeli)
JEV bir sohbet modeli değil; karar veren bir model. System One mantığını, üç soru tipini, fiyatını ve sınırlarını ilk çağrıdan itibaren anlatıyorum.
JEV Kullanım Alanları: 10 Gerçek Senaryo ve Maliyet Hesabı
Yorum moderasyonundan ajan araç seçimine, model yönlendirmeden RAG filtrelemeye: JEV'in gerçekten işe yaradığı 10 senaryo, kodu ve maliyet karşılaştırmasıyla.
JEV'i Sisteminize Bağlamak: Harness, Maliyet ve Bilinen Sınırlar
JEV tek başına bir olasılık bulutu üretir. Kararı eyleme çeviren harness'ı nasıl kurarsınız, hangi mimari kalıpları kullanırsınız ve modelin bilinen zayıf noktaları neler?