JEV'i Sisteminize Bağlamak: Harness, Maliyet ve Bilinen Sınırlar
7 dk okuma
JEV hakkında en çok tekrarlanan cümle şu: "etrafına bir sistem kurmazsan hiçbir işe yaramaz." Bu cümle abartı değil, tanımın kendisi. JEV size bir eylem vermiyor; bir olasılık bulutu veriyor. O bulutu karara, kararı eyleme çeviren makineyi siz yazıyorsunuz.
Harness yazısında modelin bir fonksiyon, aracın ise onun etrafındaki program olduğunu anlatmıştım. JEV bu ayrımın en saf hâli: model gerçekten sadece bir fonksiyon, geri kalan her şey sizin.
Bu yazı, o "geri kalan her şey" hakkında.
Harness'ın beş görevi
Bir JEV entegrasyonunda kodunuzun üstlendiği işler şunlar:
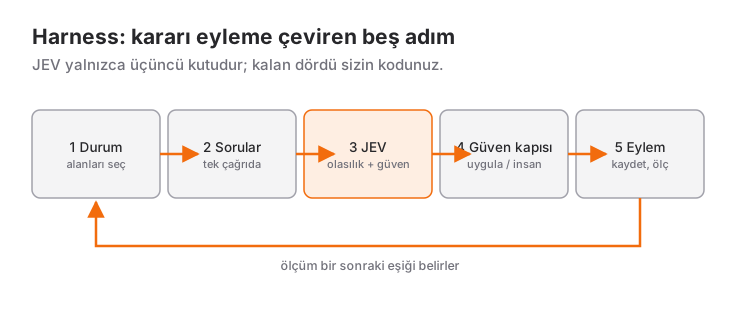
1. Durumu (state) hazırlamak
Modele ne göndereceğinize siz karar veriyorsunuz. Bu, entegrasyonun kalitesini belirleyen en önemli adım. Dokümantasyonun açıkça söylediği bir sınır var: durum büyüdükçe ve kararla ilgisi olmayan içerik arttıkça doğruluk düşüyor. İlgisiz ayrıntı dikkat dağıtıcı gibi davranıyor.
Yani "hepsini gönderelim, model ayıklasın" yaklaşımı burada çalışmıyor. İlgili alanları kodda seçin, adlandırın ve soruda o adlara atıfta bulunun.
2. Soruları tasarlamak
Aynı durum üzerine soracağınız tüm soruları tek çağrıya koyun. Sorular paralel değerlendirildiği için ek sorunun süre maliyeti neredeyse yok. Bu yüzden "belki lazım olur" sorularını da sormak rasyonel; hangi cevabı kullanacağınıza kodunuz sonra karar verir.
3. Güveni kapı olarak kullanmak
Cevabın kendisi ne olduğunu, güven skoru harekete geçip geçmeyeceğinizi söylüyor. Kodunuz üç yol ayrımı kurmalı: uygula, onay iste, insana devret.
answer = response.answers["talep_tipi"]

if answer.confidence < 0.5:
    devret_insana(talep)
elif answer.confidence < 0.9 and riskli(answer.choice):
    kullanicidan_onay_iste(answer.choice)
else:
    uygula(answer.choice)
Eşikleri tahminle değil, kendi verinizle belirleyin — ve bir sorudan diğerine taşımayın.
4. Kararı eyleme çevirmek
JEV "şu aracı kullan" der; aracı çağıran sizsiniz. "Bu talep acil" der; kuyruğa koyan sizsiniz. Bu katman sıkıcı görünür ama sistemin gerçek davranışı burada oluşur: yeniden deneme, geri alma, kayıt, denetim izi.
5. Ölçmek
Bu adım atlanırsa gerisi anlamsız. En az 50-100 gerçek örneği elle etiketleyin, JEV'in cevaplarıyla karşılaştırın, doğruluğu güven aralıklarına göre ayırın. Tipik bulgu şu olur: 0,9 üstü güvende doğruluk çok yüksek, 0,5 altında rastgeleye yakın. Eşiğinizi bu tablo belirler, sezginiz değil.
Dört mimari kalıp
TypeSafe'in dokümantasyonu kalıpları isimlendirmiş; pratikte hepsi işe yarıyor.
Speculative fan-out. Tek çağrıda, kesin gerekenlerin yanında "belki gerekir" sorularını da sorun. Kullanıcı hangi yöne giderse gitsin cevap elinizde olur, ikinci tur gerekmez.
Confidence-gated routing. Güveni ikinci eksen olarak kullanın. Aynı cevap, yüksek güvende otomatik işlenirken düşük güvende insana gider.
Composite scoring. Karmaşık bir yargıyı tek soruya sıkıştırmayın; atomik skorlara bölün ve ağırlıklandırmayı kodda yapın. Böylece hem her bileşeni ayrı ayrı doğrulayabilirsiniz hem de ağırlıkları model yeniden eğitilmeden değiştirebilirsiniz.
Intent routing. Gelen isteği sınıflandırıp her birini en uygun işleyiciye yönlendirin: deterministik kod, uzman bir LLM ya da insan. Dokümantasyondaki örnekte sipariş durumu sorgusu hiç LLM görmeden veritabanına gidiyor, ürün sorusu ürün bağlamı yüklü bir modele düşüyor, şikâyet ise karmaşıklık skoruna göre modele ya da insana gidiyor.
Bu dördü birleştiğinde ortaya çıkan mimari şu: pahalı zekâ yalnızca gerçekten gerektiğinde, doğru bağlamla çalışır. Kalan her şeyi ucuz karar katmanı ve düz kod halleder.
Bilinen sınırlar
TypeSafe, jev-1.13 için bilinen zayıf noktaları ayrı bir sayfada yayımlıyor. Bu şeffaflık işinizi kolaylaştırıyor; çünkü aşağıdakilerin hepsi, farkında olmazsanız üretimde sizi vuracak şeyler.
Birebir okuma. Model yazdığınız soruyu cevaplıyor, kastettiğinizi değil. Kapsam belirten kelimeler, olumsuzlamalar ve ima edilen koşullar harfiyen okunuyor. Koşulları açıkça yazın, sınır durumları söyleyin, muğlak soruyu parçalara bölüp birleştirmeyi kodda yapın.
Sayma ve matematik. Güvenilir biçimde saymıyor: bir kelimedeki harfleri, bir metindeki geçiş sayısını, uzun bir listedeki öğeleri. Sayma işini düzenli ifade ya da ayrıştırıcıyla kodda yapın; gerekiyorsa her öğe için ayrı soru sorup sonuçları toplayın.
Sayısal gösterimler. Hex değerler, RGB üçlüleri, ikili kodlanmış veri zayıf alanları. Bunları kodda anlamlı kovalara çevirip öyle sorun.
Skor ara değeri. Score seviyeleri sayısal olarak zayıf kalibre. İki seviye arasını interpolasyonla bulmaya çalışmayın; eşik geçildi mi diye bakın.
Tarih ve zaman. Tarihleri sıralı büyüklük olarak değil, metin olarak okuyor. Hangi tarih önce, arada kaç gün var, şu aralığa düşüyor mu — bunlar güvenilir değil. Tarih parçalarını Choice ile çıkarın, karşılaştırmayı kodda yapın.
Dolaylılık. Çift olumsuz, bir özelliğin özelliği, çok adımlı çıkarım gerektiren sorular doğruluktan yiyor. Doğrudan yazın.
Büyük ve alakasız durum. Yukarıda geçti ama tekrar etmeye değer: gereksiz içerik doğruluğu düşürüyor.
Düşmanca içerik. Modeli yönlendirmek için yazılmış metin — gömülü talimat, kasıtlı yanıltıcı çerçeveleme ya da kendi sınıflandırmasını savunan metin — cevabı kaydırabiliyor. Kriterleri açık yazın ve entegrasyonu üretime almadan bu senaryoyu özellikle test edin.
Çelişkili talimat ve kriter. İkisi farklı şey istiyorsa model şaşırıyor. Kriteri talimatın devamı gibi kurgulayın.
Yapısal değişmezler. "P(evet) = 1 − P(hayır)" gibi matematiksel özdeşliklerin ayrı sorular arasında korunacağını varsaymayın. Her soruyu kendi anlamıyla yazın, eşikleri tipler arasında taşımayın.
Üretim. Metin üretmek için eğitilmemiş. Choice zincirleyerek zorlamak mümkün ama iyi çalışmıyor ve çok yavaş.
Bu listeye bakınca çıkan sonuç şu: JEV'in zayıf olduğu her yer, aslında kodun güçlü olduğu yer. Sayma, karşılaştırma, aritmetik, sıralama — bunlar zaten deterministik kodun işi. Model yalnızca gerçek yargı gerektiren kısımda kalsın.
Maliyeti nasıl hesaplarsınız?
Fiyatlandırma iki cümlede biten türden: girdi milyon token başına 0,042 dolar, çıktı ücretsiz. Bağlam istek başına toplam 64k token; durum artı en uzun soru için 32k. Hız limitleri saniyede 250.000 token ve dakikada 1.200 istek olarak veriliyor (talep yoğunluğuna göre dinamik ayarlandığı notu düşülmüş).
Hesap şöyle kuruluyor:
günlük maliyet ≈ (günlük istek × ortalama girdi token) / 1.000.000 × 0,042Kritik nokta: aynı duruma sorduğunuz her ek soru, yalnızca kendi token'ları kadar maliyet ekliyor. Durum metnini tekrar tekrar göndermediğiniz için 13 soruyu tek çağrıda sormak, ayrı ayrı sormaya göre yayımlanmış bir örnek çalışmada yaklaşık 12 kat daha ucuz ve 10 kat daha hızlı çıkıyor.
Pratik sonuç: çağrı sayısını değil, çağrı başına soru sayısını optimize edin. Çoğu ekip tam tersini yapıyor.
Üretime alma sırası
Önerdiğim sıra şu:
- Tek bir karar seçin. En yüksek hacimli, en düşük riskli kararla başlayın. Moderasyon etiketi iyi bir başlangıç; ödeme onayı değil.
- Gölge modda çalıştırın. JEV'in kararını kaydedin ama uygulamayın. Mevcut sisteminizle yan yana koyun.
- Eşiği verinizle belirleyin. Güven aralıklarına göre doğruluk tablosu çıkarın.
- Kademeli açın. Önce yüksek güvenli vakaları otomatikleştirin, kalanı insana bırakın. Otomasyon oranını zamanla yukarı çekin.
- Kayıt tutun. Her karar için durum, soru, cevap ve güveni saklayın. Model sürümü değiştiğinde (
jev-latesttakma ad, sabit değil) neyin değiştiğini ancak böyle görürsünüz.
Beşinci madde özellikle önemli. Takma ad kullanmak kolaylık sağlıyor ama sürüm sabitlemek — jev-1.13.0 gibi — üretimde daha öngörülebilir. Yeni sürümü kendi verinizle test edip geçin.
Kodlama ajanınıza yaptırmak
Bu entegrasyonu elle yazmak zorunda değilsiniz. TypeSafe resmî bir agent skill yayımlıyor:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Diğer ajan ortamları için de npx skills add typesafe-ai/skills --skill typesafe-ai çalışıyor. Yetenek, ajana soru tiplerini, mimari kalıpları ve değerlendirme pratiklerini öğretiyor; böylece "projede kırılgan ayrıştırma kodunun yerine akıllı kararın geçebileceği yerleri bul" diyebiliyorsunuz.
Yeteneğin nasıl çalıştığı ve kurmadan önce neye bakmanız gerektiği için agent skill yazısına bakabilirsiniz.
Son söz
JEV'i değerlendirirken sorulması gereken soru "ne kadar zeki?" değil, "bu kararı benim kodum mu vermeli, model mi?" Cevabı netleştiren üç ölçüt var: karar kapalı bir kümeden mi geliyor, kural yazılabilir mi, yanlış kararın bedeli ne?
Kural yazılabiliyorsa kod yazın. Kapalı küme değilse LLM kullanın. İkisinin arasında kalan o geniş alan — kural yazılamayan ama cevabı kısa olan kararlar — bugüne kadar ya anahtar kelimeyle kabaca ya da pahalı modelle savurganca çözülüyordu. JEV'in doldurduğu boşluk tam olarak orası.
Serinin diğer yazıları: JEV nedir, Choice, Score ve Noul, 10 kullanım senaryosu.
Sınırlar ve fiyat bilgileri TypeSafe'in jev-1.13 dokümantasyonuna dayanıyor; sürümle değişebilir.
Sık Sorulan Sorular
JEV'i tek başına kullanabilir miyim?
Hayır. JEV bir cevap değil, bir karar üretiyor: seçenek, skor ya da olasılık. Bu kararı uygulayan akış — durumu hazırlayan, güvene göre yol ayıran, eylemi yürüten ve sonucu kaydeden kod — sizin sorumluluğunuzda. Etrafında sistem olmadan elinizde yalnızca sayılar olur.
JEV'in bilinen zayıf noktaları neler?
Saymıyor, tarih karşılaştırmıyor, aritmetik yapmıyor, hex/RGB gibi sayısal gösterimlerde zayıf, Score seviyeleri arasında ara değer üretmiyor, çift olumsuz ve dolaylı sorularda doğruluk kaybediyor, büyük ve alakasız durumdan etkileniyor, düşmanca yazılmış metin cevabı kaydırabiliyor. Bunların hepsi üreticinin yayımladığı listede yer alıyor.
Güven eşiğini kaç yapmalıyım?
Sabit bir cevap yok; kendi verinizle belirleyin. Başlangıç için dokümantasyonun önerisi: 0,5 altı insana, 0,5-0,9 arası düşük riskte otomatik yüksek riskte onaylı, 0,9 üstü geri dönüşü olmayan işlemlerde bile onaylı devam. Eşiği bir sorudan diğerine taşımayın.
JEV maliyeti nasıl hesaplanır?
Girdi tarafı milyon token başına 0,042 dolar, çıktı ücretsiz. Günlük maliyet kabaca "(istek sayısı × ortalama girdi token) / 1.000.000 × 0,042" oluyor. Aynı duruma birden fazla soru sorduğunuzda durum metni tekrar gönderilmediği için ek soruların maliyeti çok düşük kalıyor.
Model sürümünü sabitlemeli miyim?
Üretim için evet. jev-latest bir takma ad ve zamanla farklı bir sürüme işaret edebilir; bu da davranış değişikliği demek. jev-1.13.0 gibi belirli bir sürümü sabitleyip yeni sürümü kendi doğruluk testinizden geçirdikten sonra geçmek daha öngörülebilir.
JEV entegrasyonuna nereden başlamalıyım?
En yüksek hacimli ve en düşük riskli kararı seçin, önce gölge modda çalıştırın (kararı kaydedin ama uygulamayın), kendi verinizle doğruluk-güven tablosu çıkarın, sonra yalnızca yüksek güvenli vakaları otomatikleştirin. Otomasyon oranını ölçümle birlikte yukarı çekin.
İlgili Yazılar
JEV Nedir? Yapay Zekânın Refleks Katmanı (System One Modeli)
JEV bir sohbet modeli değil; karar veren bir model. System One mantığını, üç soru tipini, fiyatını ve sınırlarını ilk çağrıdan itibaren anlatıyorum.
JEV Kullanım Alanları: 10 Gerçek Senaryo ve Maliyet Hesabı
Yorum moderasyonundan ajan araç seçimine, model yönlendirmeden RAG filtrelemeye: JEV'in gerçekten işe yaradığı 10 senaryo, kodu ve maliyet karşılaştırmasıyla.
JEV Soru Tipleri: Choice, Score ve Noul'u Doğru Kullanmak
JEV'in üç soru tipini, kriter yazmanın kurallarını, olasılık ile güven farkını ve tek çağrıda onlarca soru sormanın maliyet etkisini örneklerle anlatıyorum.