Einen dreisprachigen Blog führen, ohne hreflang zu zerbrechen
7 Min. Lesezeit
Diese Seite trägt fast 400 Beiträge, und jeder erscheint auf Türkisch, Englisch und Deutsch. Diese drei korrekt zu verknüpfen — hreflang — ist theoretisch simpel: Jede Seite zeigt auf ihre Entsprechungen.
In der Praxis ist es etwas, das lautlos kaputtgeht. Wenn es bricht, gibt es keinen Fehler, die Seite läuft weiter, und die Suchmaschine beginnt schlicht, zwei Seiten als getrennt und als Kopien voneinander zu behandeln.
Dieser Artikel zeigt die reale Architektur dieser Seite: welche Entscheidung welches konkrete Problem löste und welcher Fehler tatsächlich in der Produktion auftrat. Die Codebeispiele sind keine Dekoration, sie stammen aus dem laufenden Quellcode.
Das Problem: zwei Wörterbücher bleiben nie synchron
Anfangs lagen die Übersetzungspaare in zwei getrennten Wörterbüchern: eines von Türkisch nach Englisch, ein zweites von Englisch zurück nach Türkisch. Das wirkt vernünftig — bis eines davon nicht aktualisiert wird.
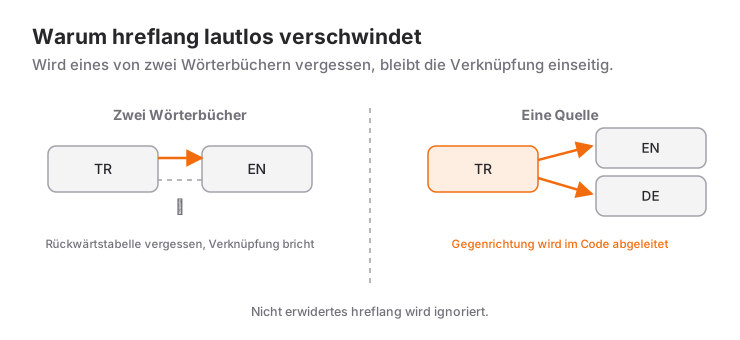
Ändert sich der englische Slug eines Beitrags und die Rückwärtstabelle wird vergessen, passiert Folgendes: Die türkische Seite zeigt auf die englische, die englische nicht zurück. Einseitiges hreflang ist ungültig. Google ignoriert eine nicht erwiderte Verknüpfung, und beide Seiten wissen nichts voneinander.
Die Lösung war, das zweite Wörterbuch zu löschen:
/**
 * Einzige Quelle: türkischer Slug -> Slug in den anderen Sprachen.
 *
 * Die Gegenrichtungen (EN/DE -> TR) werden daraus abgeleitet; ein zweites
 * Wörterbuch gibt es nicht. Früher wurden beide von Hand synchronisiert, und
 * wenn eines vergessen wurde, verschwand hreflang lautlos.
 */
const explicitEnglishPairs: Record<string, string> = {
  'agent-skill-nedir-ise-yarayan-yetenek-nasil-yazilir':
    'what-is-an-agent-skill-how-to-write-useful-skills-en',
  // ...
};
Die Regel lautet: Der türkische Slug ist die Quelle, alles andere ist abgeleitet. Die Gegenrichtung wird im Code berechnet, es gibt also keine zweite Stelle zum Abgleichen — denn alles, was Abgleich braucht, geht irgendwann kaputt.
Eine zweite Erleichterung: Auf englischer Seite gilt als Standardregel <türkischer-slug>-en. Beiträge, die der Regel folgen, stehen gar nicht erst in der Tabelle. Deutsche Slugs werden ausgeschrieben, weil sie aus SEO-Gründen aus deutschen Wörtern bestehen.
Preis und Gewinn übersetzter Slugs
Warum lautet der Slug des deutschen Artikels was-ist-ein-agent-skill-... und nicht agent-skill-nedir-...-de? Weil der Slug in den Suchergebnissen sichtbar ist und die Klickrate beeinflusst. Einem deutschsprachigen Suchenden eine Adresse aus türkischen Wörtern zu zeigen wirkt fremd und verliert die Begriffsübereinstimmung.
Der Preis: Jeder deutsche Slug muss von Hand geschrieben werden. Der Gewinn: Jede Sprache rankt mit ihrem eigenen Vokabular. Über 400 Beiträge hat sich dieser Tausch klar gelohnt.
Die FAQ nicht zweimal schreiben
Für die aufklappbare Frage-Antwort-Box in den Suchergebnissen braucht eine Seite FAQPage-Markup. Der klassische Weg schreibt die Fragen sowohl in den Artikel als auch in einen separaten JSON-LD-Block — derselbe Text an zwei Stellen.
Wie alles Doppelte driftet auch das auseinander: Sie korrigieren die Antwort im Artikel, im Markup bleibt die alte stehen.
Hier ist das Markdown selbst die einzige Quelle. Der Abschnitt „Häufig gestellte Fragen" am Ende wird geparst und das FAQPage-Schema daraus erzeugt:
/** FAQ-Überschriften in drei Sprachen; auch Varianten in Klammern werden erkannt. */
const FAQ_HEADING =
  /^#{2,3}\s*.*(sık(ça)?\s+sorulan\s+sorular|frequently\s+asked\s+questions|häufig\s+gestellte\s+fragen|\bfaq\b).*$/i;
Der Autor schreibt nur den Artikel; das Markup ist ein Nebenprodukt des Builds. Weil die Überschriften aller drei Sprachen in einem Ausdruck zusammengefasst sind, läuft der deutsche Beitrag denselben Weg.
Kategorieseiten: Filter gegen Hub
Zunächst lebten Kategorien nur im clientseitigen Filter der Blogliste: ?category=flutter. Für Menschen genügt das, für eine Suchmaschine ist es nichts. Google behandelt ?category= nicht als eigene Seite, und das Kategorie-Etikett auf einem Beitrag verlinkte nirgendwohin.
Jede Kategorie ist jetzt eine statische Hub-Seite:
/tr/blog/kategori/flutter/
/en/blog/category/flutter/
/de/blog/kategorie/flutter/
Drei Änderungen kamen zusammen: Der Kategoriename wurde zum Wort der jeweiligen Sprache, Beitragsseiten bekamen einen Brotkrumenpfad, und jeder Hub sammelte die Beiträge seiner Sprache unter eigener Überschrift und Einleitung.
Der SEO-Name dafür ist Topic Cluster: statt verstreuter Beiträge eine Seite, die ein Thema bündelt, und Beiträge, die darauf verweisen. Verstreute Beiträge können einander keine Autorität weitergeben.
Grafiken dreisprachig erzeugen — und CLS beseitigen
Die Diagramme in diesen Beiträgen existieren in drei Sprachen. Sie von Hand zu zeichnen hieße, dieselben Koordinaten dreimal zu schreiben; korrigiert man eine und vergisst die andere, merkt es niemand. Deshalb kommen Diagramme aus einem einzigen Generator: gemeinsame Geometrie, Beschriftungen je Sprache.
SVG wurde nicht nur wegen der Dateigröße gewählt: Text in einem SVG bleibt echter Text, also lesbar für Suchmaschine und Screenreader.
Das entscheidende Detail: In der ![]()-Schreibweise von Markdown gibt es keinen Platz für Bildmaße. Ein Bild ohne Maße beansprucht bis zum Laden keine Höhe und schiebt den Text danach nach unten. Dieser Sprung wird in den Core Web Vitals als CLS gemessen und wirkt direkt auf das Ranking.
Die Lösung ist eine Maßtabelle, die zur Erzeugungszeit geschrieben wird:
export const diagramSizes: Record<string, { width: number; height: number }> = {
  '/assets/diyagram/harness-turu.svg': { width: 740, height: 412 },
  // ...
};
Beim Rendern des Markdowns wird diese Tabelle gelesen und width und height an das <img>-Tag geschrieben. Da die Tabelle beim Build entsteht, muss zur Laufzeit keine Datei gelesen werden.
Ein Jahr Cache: das Detail, das leise bricht
Das war der lehrreichste Fehler, und er passierte in der Produktion.
Die Symbole der Seite stammen aus der Material-Symbols-Schrift — nicht vollständig, sondern als Teilmenge der rund 95 tatsächlich genutzten Glyphen, eine Datei von 10 KB. Sie wird mit immutable und einem Jahr max-age ausgeliefert, damit sie nicht bei jedem Seitenaufruf neu geladen wird.
Der Haken: Wird die Teilmenge um ein neues Symbol ergänzt, bleibt der Dateiname gleich. Der Browser eines wiederkehrenden Besuchers nutzt die alte Schrift ein Jahr weiter, und die neuen Symbole erscheinen bei ihm als roher Text. Bei Ihnen alles korrekt, beim Besucher kaputt.
Die Lösung ist ein Versionsstempel aus dem Inhalts-Hash in der Schrift-URL:
/fonts/material-symbols-outlined.woff2?v=8097db93Ändert sich die Teilmenge, ändert sich der Stempel und der Browser lädt neu. Ändert sie sich nicht, bleibt der Jahres-Cache erhalten.
Die allgemeine Lehre: Ein aggressiver Cache ist eine Falle für jede Datei, deren Name sich nicht ändert.
Das lang-Attribut im statischen Export
Ein letztes Detail: das Attribut <html lang="..."> jeder Seite. Eine deutsche Seite, die mit lang="tr" ausgeliefert wird, sendet auch bei korrektem hreflang ein widersprüchliches Signal.
Ein Skript nach dem Build prüft das über alle lokalisierten Seiten und korrigiert es bei Bedarf:
Verified HTML language for 361 localized pages (361 corrected).Diese Zeile bei jedem Build zu sehen, erspart die Frage „ist es wieder kaputt?". Keine SEO-Entscheidung überlebt, wenn sie nicht überprüfbar ist — weil man sonst nicht sieht, wann sie brach.
Fünf Lehren
Die Details gehören zu dieser Seite, die Begründungen nicht:
- Eine einzige Quelle halten. Jede zweite Kopie, die Abgleich braucht, driftet irgendwann.
- Markup aus Inhalt ableiten. Die FAQ zweimal zu schreiben endet damit, dass beide sich widersprechen.
- Ein Parameter ist keine Seite. Was separat ranken soll, braucht eine eigene Adresse.
- Bildmaße angeben. CLS ist die billigste und am meisten vernachlässigte Core-Web-Vitals-Kennzahl.
- Alles Gecachte versionieren. Eine Datei mit unveränderlichem Namen ein Jahr zu cachen heißt, Besucher auf der alten Version zu lassen.
Keine der fünf war vorab entworfen; jede kam nach einem Bruch dazu. So sieht technisches SEO wirklich aus: nicht geplant, sondern gelernt.
Die Codebeispiele stammen aus dem Quellcode dieser Seite; Versionen und Pfade ändern sich mit der Zeit.
Häufig gestellte Fragen
Was ist hreflang und wozu braucht man es?
hreflang verknüpft die Sprachversionen desselben Inhalts. Richtig gesetzt, zeigt die Suchmaschine jedem Nutzer die passende Version und behandelt die Seiten nicht als Duplikate. Fehlt es, wissen die Seiten nichts voneinander, und Sie konkurrieren beim selben Thema mit sich selbst.
Warum bricht hreflang lautlos?
Weil dabei kein Fehler entsteht. Die häufigste Ursache sind zwei getrennte Wörterbücher für Übersetzungspaare, von denen eines vergessen wird: Seite A zeigt auf B, B nicht zurück. Nicht erwidertes hreflang gilt als ungültig. Die Lösung ist eine einzige Quelle mit im Code abgeleiteter Gegenrichtung.
Sollten übersetzte Seiten übersetzte Slugs haben?
Ja. Der Slug erscheint in den Suchergebnissen und beeinflusst die Klickrate; eine Adresse aus türkischen Wörtern verliert bei deutschsprachiger Suche die Begriffsübereinstimmung und wirkt unglaubwürdig. Der Preis ist, jeden Slug von Hand zu schreiben — und er lohnt sich.
Wie sollte FAQPage-Markup entstehen?
Aus einer einzigen Quelle. Die Fragen sowohl im Artikel als auch in einem separaten JSON-LD-Block zu führen endet damit, dass beide auseinanderlaufen. Auf dieser Seite wird der Abschnitt „Häufig gestellte Fragen" geparst und das Schema daraus erzeugt, sodass der Autor nur den Artikel schreibt.
Brauchen Blogkategorien eigene Seiten?
Wenn sie separat ranken sollen, ja. Ein clientseitiger Filter wie ?category=flutter genügt Menschen, zählt für eine Suchmaschine aber nicht als eigene Seite. Mit eigener Adresse, Überschrift und Einleitung werden aus verstreuten Beiträgen ein Cluster, das Autorität weitergeben kann.
Warum brauchen Bilder width und height?
Ein Bild ohne angegebene Maße belegt bis zum Laden keinen Platz und schiebt den Text danach nach unten. Dieser Sprung wird als CLS gemessen und wirkt auf das Ranking. Da Markdowns ![]()-Schreibweise keinen Platz für Maße hat, schreibt man sie beim Build in eine Tabelle und hängt sie beim Rendern an das <img>-Tag.
Verwandte Artikel
Was ist JEV? Die Reflexschicht der KI (TypeSafes System-One-Modell)
JEV ist kein Chatmodell, sondern ein Modell, das entscheidet. Die System-One-Idee, die drei Fragetypen, Preise und Grenzen — ab dem ersten API-Aufruf erklärt.
Programmieren mit kostenloser KI: opencode und günstige Modelle
Den eigenen Schlüssel in das quelloffene opencode stecken und kostenlose oder centgünstige Modelle fahren: Einrichtung, Provider-Konfiguration und was „kostenlos“ wirklich kostet.
JEV ins System einbauen: Harness, Kosten und bekannte Grenzen
Allein liefert JEV nur eine Wolke aus Wahrscheinlichkeiten. So bauen Sie den Harness, der daraus Handlung macht, welche Architekturmuster helfen und wo das Modell schwach ist.