Space Bunny Alpha: 1M Bağlam ve Multimodal Girdi
5 dk okuma
Space Bunny Alpha'nın en çarpıcı iki sayısı yan yana duruyor: bir milyon tokenlık bağlam penceresi ve görsel ile video girdisi. Bu ikisi birlikte, diğer modellerin çoğunda bulunmayan bir kombinasyon oluşturuyor.
Ama sayıların büyüklüğü, tek başına, ne yapabileceğinizi anlatmıyor. Bir milyon token "çok büyük bir pencere" demek; bu pencerenin neye yeteceği, neye yetmeyeceği ve içine ne koyduğunuzla ilgili. Bu yazıda pencerenin gerçekte ne sığdığını hesaplıyor, ortak bütçe kavramını açıklıyor ve token bütçenizi ölçüp yönetmenin pratik yolunu anlatıyorum.
Kurulumun kendisi ayrı yazıda; özelliklerin diğer modellerle kıyaslaması da karşılaştırma yazısında.
Bir milyon token ne kadar içerir?
Cevap, dilin kendisine bağlı. Ve burada dürüst olmak gerekiyor: Space Bunny Alpha'nın tokenleştiricisi yayımlanmamış. OpenRouter bu alanı Other olarak bildiriyor, yani tokenizer'ın adını ve kurallarını bilmiyoruz. Bu yüzden aşağıdaki rakamlar yaklaşık değerlerdir; gerçek sayıyı ancak isteği atıp usage alanından öğrenebilirsiniz. Bu yazının sonunda bunun nasıl ölçüleceğini anlatıyorum.
İngilizce düz metin için kaba bir kural, token başına yaklaşık dört karakterdir:
| İçerik | 1M token kabaca |
|---|---|
| İngilizce düz metin | 750.000 kelime, yaklaşık 4 milyon karakter |
| Türkçe düz metin | 400.000 ila 500.000 kelime |
| Dart, Swift, C# kaynak kodu | 55.000 ila 80.000 satır |
| Tipik bir kaynak dosyası (200-400 satır) | 150 ila 400 dosya |
| Markdown dokümantasyon | 25.000 ila 40.000 satır |
Türkçe ile İngilizce arasındaki fark şaşırtıcı ama gerçek. Ekler ve uzun kelimeler tokenleştiricide daha çok parçaya ayrılıyor; aynı karakter sayısı daha fazla token tutuyor. Yani Türkçe bir projeyi İngilizce bir projeyle aynı bağlam bütçesine sığdırmak daha pahalı.
Rakamlar şaşırtıcı derecede büyük görünebilir, ama pratikte opencode yazısında bahsettiğim sıkıntı bu modelde tamamen çözülmüyor. Sebebi basit: 400 dosyalık bir projeyi bağlama sığdırmak ile o projeyi anlamak aynı şey değil.
Neden 1M bağlam her şeyi çözmüyor
Dört somut sebep var.
Gecikme. Dikkat mekanizması, verilen token sayısıyla değil, token çiftleri arasındaki karşılaştırmaların sayısıyla ölçeklenir. Bağlamı iki katına çıkarmak işlemi karesel olarak büyütür. 1M token'a çıkmak, 100 bin token'dan çok daha uzun sürer. Uzun bir oturumda bu, kullanıcıya dönük bir arayüzde ilk fark edilen şey olur.
Dikkati dağıtma. Uzun bir bağlamın içine gömülen talimat, modelin gözünden kaçabilir. Yüz sayfalık bir kodu okutup "sadece 40. satırdaki hatayı düzelt" demek ile o kodu okutup "hata ayıkla ve açıkla" demek, model için aynı iş değil. Yönergeleri bağlamın sonuna koymak, başına koymaktan belirgin şekilde daha iyi sonuç verir.
Bağlam dolu değil, sürü dolu olabilir. Pencereyi doldurmak bir hedef değil. İçine alakasız on bin satır koymak, içine doğru beş yüz satır koymaktan daha kötü sonuç verir. Genizlik, işe yaramazlık için kullanılmaz.
Ücret hâlâ sıfır değil. Bu model için doğru, ama aynı penceresi olan modeller için değil. Karşılaştırma yazısındaki hesapta gpt-6-luna ayda 1,35 $ tutuyordu. Bağlamı büyütmek, doğrudan maliyeti büyüten bir karardır.
Pratik sonuç: bir milyon tokenı, gerçekten o kadar maliyetli olan işler için saklayın. Bunlar genellikle bütün bir kod tabanını okuyup değişiklik yapmak, uzun bir dokümantasyonu taramak veya onlarca ekran görüntüsünü birlikte yorumlamaktır.
Ortak bütçe: metin, görsel ve video
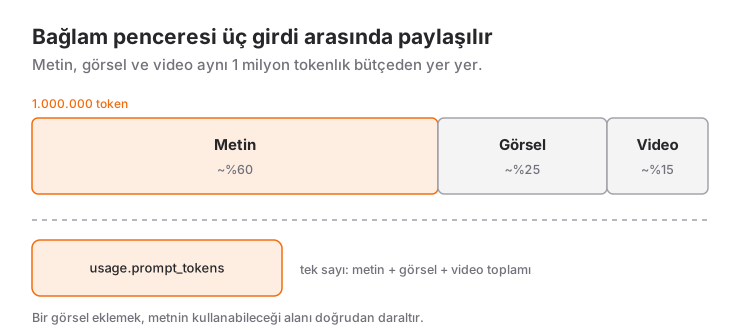
Modelin girdi biçimi text + image + video. Önemli olan şu: 1 milyon token üçü arasında paylaşılan tek bir bütçe. Görsel eklediğinizde metnin kullanabileceği alan azalır.
Görsel girdinin token karşılığı kaba olarak iki parametreye bağlı: çözünürlük ve parçalama (tiling). Yüksek çözünürlüklü bir ekran görüntüsü, aynı sahnenin küçük hâlinden çok daha fazla token tutar. Bu yüzden bir hata ayıklama oturumunda ekran görüntülerini kırpmadan göndermek, sorunun kendisi kadar bağlam harcayabilir.
Aşağıdaki Python örneği, kullanılan bütçeyi istekten sonra ölçmenin en ucuz yolu:
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="stealth/space-bunny-alpha",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Bu ekran görüntüsündeki hata mesajını açıkla."},
            {
                "type": "image_url",
                "image_url": {"url": "https://example.com/hata.png"},
            },
        ],
    }],
)

usage = response.usage
print("girdi token :", usage.prompt_tokens)
print("çıktı token :", usage.completion_tokens)
print("maliyet     :", usage.cost)
usage.prompt_tokens alanı, metin ve görselin toplam token karşılığını verir. İki yazı arasında karşılaştırma yaparak bir ekran görüntüsünün ne kadar tuttuğunu tek istekte ölçebilirsiniz.
Video girdi
Video girişi destekleniyor, ama burada bir ayrıntı var: video çerçevelerinin token karşılığı bağlamdan yer kaplar. 1 milyon tokenlık bütçenin tamamını doldurabilecek bir video göndermek, modelin metne hiç yer kalmaması anlamına gelir.
Pratikte kullanılan yöntem, videoyu önceden işleyip kareleri seçmektir. İşte tipik bir akış:
- Videoyu karelerine ayırın. ffprobe ile saniyede kaç kare olduğunu bulabilirsiniz.
- Kareler arasından eşit aralıkla bir alt küme seçin. Bu, bilgiyi korurken token maliyetini doğrusal olarak düşürür.
- Kareleri tek bir görsel olarak birleştirin ve modele bir görsel gönderin.
ffmpeg ile kare çıkarıp ızgaraya dizmenin tamamı video birleştirme yazısında anlatılıyor. Oradaki düzen, uzun bir günlük videosunu özetleyen tek bir kare ızgarası üretiyor.
# Saniyede 0,5 kare: iki saniyede bir kare
ffmpeg -i video.mp4 -vf "fps=0.5" kare-%04d.png
Bu yaklaşımın bir yan faydası var: dönüşümü siz yaptığınız için hangi karenin gittiğini ve ne kadar token harcandığını tam olarak biliyorsunuz. Ham video yüklemek bu denetimi modele bırakıyor.
Token bütçesini yönetmek
Bütçeyi yönetmenin pratik dört kuralı:
Ölçmeden hesaplamayın. Tokenleştirici yayımlanmadığı için çevrimdışı bir token sayacı güvenilir değil. usage.prompt_tokens okumak, tahmin etmekten hem daha hızlı hem daha doğru. Karmaşık bir düzen kurmadan önce tek istekle ölçün.
Bağlamın sonuna yönerge koyun. Uzun bir bağlamın ortasına bırakılan talimat, sonuna koyulana göre çok daha sık kaçırılıyor. Uzun bir belge gönderip üstünde işlem istiyorsanız, talimatı en sona ekleyin.
Yönergeleri tekrarlayın, bağlamı değil. Aynı kısıtı üç kez yazmak, iki bin satırı üç kez göndermekten ucuzdur.
Çıktı sınırını bilerek ayarlayın. Azami çıktı 524.288 token, yani bağlam penceresiyle neredeyse aynı. Bu serbest bırakıldığında model çok uzun cevaplar üretebilir. Uzun çıktı istemiyorsanız max_tokens ile sınırlayın:
-d '{
    "model": "stealth/space-bunny-alpha",
    "messages": [{ "role": "user", "content": "Bu sınıfı özetle." }],
    "reasoning_effort": "low",
    "max_tokens": 800
  }'
Akıl yürütme de bütçeden yer yer. reasoning_effort: max ile çalışan bir istekte, düşünme adımı hem gecikmeyi hem de çıktı token sayısını büyütür. Basit bir özetleme için low hem daha hızlı hem daha ucuz.
1M bağlamı hangi işlerde kullanmalı
Pencerenin gerçekten işe yaradığı dört senaryo:
Bütün bir kod tabanında değişiklik. Birden çok dosyayı ilgilendiren bir refactor ya da bir tipin tüm kullanım yerlerini bulmak. 400 dosya sığdığında, ajanın her adımda dosya aramak yerine haritayı hazır tutması işe yarar.
Uzun dokümantasyon taraması. Bir API'nin tüm sürüm geçmişini okuyup belirli bir davranış değişikliğini çıkarmak gibi işler.
Onlarca ekran görüntüsü. Çok ekranlı bir akışta hatanın hangi ekranda başladığını bulmak. Sadece bu senaryoda 1M bağlamın multimodal tarafı gerçekten devreye girer.
Toplu sınıflandırma. Yüzlerce kaydı sınıflandırmak ve hepsini tek istekte işlemek. Buradaki pazar, bağlam değil response_format ile güvenceye alınan tutarlılıktır.
Buna karşılık kısa ve hedefli işlerde, örneğin tek bir fonksiyonu düzeltmekte veya bir metni çevirmekte, 1M bağlam hiçbir işe yaramaz. opencode yazısındaki "çok dosyalı bir refactor ortasında kalma" derdinin çözümü bağlam büyütmek değil, ajanın dosya okuma sırasını düzgün kurmaktır.
Kaynaklar
- OpenRouter uç nokta ayrıntıları: Space Bunny Alpha (girdi biçimleri, azami çıktı, tokenleştirici alanı,
max_tokensdesteği) - OpenRouter model API'si (tokenleştirici bildirimi, bağlam penceresi, akıl yürütme kademeleri)
- OpenRouter API dokümantasyonu (
usagealanları,max_tokens, multimodal içerik biçimi)
İlgili Yazılar
Space Bunny Alpha Nasıl Kurulur? Adım Adım Rehber
Space Bunny Alpha'yı OpenRouter üzerinden kurma: API anahtarı, ilk istek, Python ve TypeScript örnekleri, görsel girdi ve açık kaynak ajanlara bağlama.
Space Bunny Alpha ile Yapay Zekâ Ajanı Kurmak
Araç şemasından döngüye: Space Bunny Alpha ile çalışan bir kodlama ajanı yazmak, araç hatalarını modele geri beslemek ve çıktıyı JSON'a kilitlemek.
Space Bunny Alpha ve Diğer Yapay Zekâ Ajanları
Space Bunny Alpha'yı Claude, GPT, Gemini ve ücretsiz açık modellerle karşılaştırıyorum: fiyat, 1M bağlam, multimodal girdi ve ajan yetenekleri.