LongCat 2.5 Preview ve Rakip Yapay Zekâlar
8 dk okuma
Meituan, LongCat-2.5-Preview modelini yayımladı ve açık ağırlıklı model cephesinde rekabeti yeniden kızıştırdı. Aile, uzun bağlamlı ajan kodlaması üzerine kurulu bir şirket içi araştırma hattından, tek bir model etrafında on iki farklı araca resmî rehber yayımlayan bir ekosisteme dönüştü.
Bu haberin asıl meselesi tek bir modelin yetenekleri değil, ortaya çıkan yapısal bir değişim. Aynı anda üç şey birden doğru: bir milyon tokenlık bağlam artık farklı edici değil, düşünme modelleri isteğe bağlı hâle geliyor ve açık ağırlıklı modeller kapalı amiral gemilere fiyatta yaklaşıyor.
Bu yazıda üç şeyi bir araya getiriyorum: LongCat'in kendi yayımladığı benchmark puanları, tüm modellerin teknik özellikleri ve bu puanların nasıl okunması gerektiği.
Bir uyarıyla başlayayım: Bu bir haber metnidir, bağımsız bir test değildir. Aşağıdaki puanlar LongCat'in kendi model kartından alınmıştır ve LongCat'in kendi ölçümleridir. Karşılaştırma satırlarının önemli bir kısmı ise doğrudan LongCat tarafından değil, rakip şirketlerin kendi raporlarından alıntılanmıştır. Bu ayrımı neden önemli gördüğümü yazının ortasında açıklıyorum.
Yayımlanan benchmark tablosu
LongCat, kendi model kartında modeli rakip modellerle karşılaştıran bir tablo yayımlıyor. Tabloyu aynen aktarıyorum, çünkü bir haber metninde kaynak tabloyu bozmak en sık yapılan hatadır:
| Ölçüt | LongCat-2.0 | Gemini 3.1 Pro | GPT-5.5 | Claude Opus 4.6 | Claude Opus 4.7 | Claude Opus 4.8 |
|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 70.8 | 70.7* | 73.8* | - | 71.7* | 78.9* |
| SWE-bench Pro | 59.5 | 54.2* | 58.6* | 57.3* | 64.3* | 69.2* |
| SWE-bench Multilingual | 77.3 | 76.9* | - | 77.8* | 80.5* | 84.8* |
| FORTE | 73.2 | 70.3 | 77.8 | 73.2 | 77.6 | 77.2 |
| BrowseComp | 79.9 | 85.9* | 84.4* | 84.0* | 79.3* | 84.3* |
| RWSearch | 78.8 | 76.3 | 85.3 | 81.3 | 79.3 | 77.3 |
| IFEval | 90.0 | 96.1 | 95.0 | 92.2 | 88.7 | 86.0 |
| Writing Bench | 83.8 | 83.7 | 84.7 | - | 85.3 | 85.2 |
| IMO-AnswerBench | 81.8 | 90.0 | 79.5 | 75.3* | 81.8 | 75.3 |
| GPQA-diamond | 88.9 | 94.3* | 93.6* | 91.3* | 94.2* | 92.4* |
LongCat'in notu şu: yıldız işareti (*) "rakip modelin kendi raporundan alıntılandı" anlamına geliyor. Yani LongCat'in puanları kendi ortamında ölçülmüş, rakiplerin puanları ise o rakiplerin kendi ölçümleri.
Bu tabloyu nasıl okumalı
Haber metinlerinde benchmark tablosu genellikle bir sıralama listesi gibi sunulur. Bu burada yanıltıcı olur, çünkü yıldız işaretleri tam olarak karşılaştırmanın en zayıf noktasını gösteriyor.
Sorun şu: LongCat'in puanı kendi donanımında, kendi harness'inde, kendi prompt kalıbında ölçülmüş. Rakibin puanı ise o rakibin kendi donanımında, kendi harness'inde ölçülmüş. Bu iki ölçüm aynı laboratuvarda yapılmamış. Aynı modeli iki farklı yerde koşturduğunuzda aynı puanı almazsınız; bu, modelin değil ölçümün bir özelliği.
İkinci sorun: Bazı satırlarda rakip puanı boş. Claude Opus 4.6 sütununda Terminal-Bench karşılığı "-", yani "kıyaslanabilir kamuya açık puan yok". LongCat'in bu satırlarda rakibin puanını bilmediği, yani kendi lehine ya da aleyhine bir yorum yapmadığı görülüyor. Bu, tarafsızlığın bir işareti.
Üçüncü ve en önemli sorun: Tablonun satırları tek bir yönde değil. LongCat, kodlama ve ajan satırlarında bazı yerlerde önde, bazı yerlerde geride. Terminal-Bench 2.1'de Claude Opus 4.8'den on puan geride, ama FORTE'ta Gemini 3.1 Pro'dan üç puan önde. IFEval'da 90,0 ile tablonun en yüksek ikinci değeri; ama GPQA-diamond'da 88,9 ile en düşük değerlerden biri.
Bu dağınık tablo, haberin asıl mesajını veriyor: LongCat tek bir alanda uzmanlaşmış bir model değil, rakiplerle aynı genişlikte bir bandın içinde duran bir model. Kimse "LongCat Codex'i yendi" ya da "LongCat derin araştırmada lider" diyemez. Doğru ifade şu: kodlama ajanlarında rekabet edilebilir seviyede, temel akıl yürütmede geride.
Uzun bağlam savaşı bitti mi
Teknik özellik tablosuna bakınca tablo şöyle görünüyor:
| Model | Bağlam | Azami çıktı | Girdi biçimleri | Girdi $ / M | Çıktı $ / M |
|---|---|---|---|---|---|
LongCat-2.5-Preview |
1.048.576 | 131.072 | metin, görsel | 0,30 | 1,20 |
meituan/longcat-2.0 |
1.048.756 | 262.144 | metin | 0,30 | 1,20 |
openai/gpt-6-luna |
1.050.000 | 128.000 | metin, görsel, dosya | 0,10 | 0,50 |
google/gemini-3.8-flash |
1.048.576 | 65.536 | metin, görsel, video, dosya, ses | 0,75 | 3,75 |
anthropic/claude-opus-5.5 |
1.000.000 | 128.000 | metin, görsel, dosya | 4,00 | 20,00 |
stealth/space-bunny-alpha |
1.000.000 | 524.288 | metin, görsel, video | 0 | 0 |
Altı modelin altısı da bir milyon token civarında bağlam penceresi sunuyor. Bu, karşılaştırma yazısındaki tespiti doğruluyor: bir milyon token artık bir özellik değil, bir beklenti seviyesi. Rekabet bağlamın büyüklüğüne değil, o bağlamı nasıl kullandığına kaymış durumda.
LongCat'in buradaki farkı, pencere değil, arkasındaki mekanizma. Seyrek dikkat sayesinde 1M pencereyi her token çiftini karşılaştırmadan kullanıyor. 1M bağlam yazısında anlattığım karesel maliyet sorunu, seyrek dikkatin varlığında azalıyor. Pencere aynı, maliyet aynı değil.
Düşünme modu cephesi
Son aylarda en görünür değişim bu alanda. Üç farklı yaklaşım var:
Kapatılamayan akıl yürütme. Space Bunny Alpha bunu zorunlu kılıyor, varsayılan kademesi max. Claude Opus 5.5'te de kapatılamıyor, ama varsayılan high. Uzun cevaplarda istenen, basit görevlerde gereksiz.
İsteğe bağlı akıl yürütme. LongCat-2.5-Preview'da thinking alanı enabled ya da disabled alıyor, varsayılan enabled. Gemini 3.8 Flash'te de kapatılamıyor. Bu, üretim sistemi kuran biri için en kullanışlı davranış: basit sınıflandırmada kapatıp gecikmeden kurtulabiliyorsunuz.
Kapatılabilir akıl yürütme. GPT-6 Luna bunu none kademesiyle sunuyor, varsayılanı medium. Model bazında değil, çağrı bazında karar veriyorsunuz.
Pratik sonuç: uzun süreli ajan döngülerinde vibe coding yazısındaki "hangi aracı seçmeliyim" sorusu artık yeni bir soru daha içeriyor: "hangi model seçtiğimde ne kadar düşünmeme izin veriyorum." Uzun bağlamlı bir ajanda, düşünme kademesini tura göre ayarlamak ajan yazısındaki örnekte yaptığımızın genel hâli.
Fiyat cephesi
Aynı senaryoyu altı modelde hesaplayalım. Bir turda 200.000 token girdi, 50.000 token çıktı; ayda 30 tur:
| Model | Tur başına | Aylık | Önbellekli girdiyle aylık |
|---|---|---|---|
stealth/space-bunny-alpha |
0,00 $ | 0,00 $ | 0,00 $ |
openai/gpt-6-luna |
0,045 $ | 1,35 $ | 1,20 $ |
LongCat-2.5-Preview |
0,1200 $ | 3,60 $ | 1,76 $ |
google/gemini-3.8-flash |
0,3375 $ | 10,13 $ | 10,13 $ |
anthropic/claude-opus-5.5 |
1,80 $ | 54,00 $ | 53,65 $ |
Son sütun, LongCat'in önbellekli fiyatı sayesinde 3,60 $ yerine 1,76 $'ya düştüğü gerçek hali. GPT-6 Luna'nın da önbellek fiyatı var, oradaki düşüş daha küçük.
Buradaki sıralama haberin üçüncü ayağını tamamlıyor. Kapalı amiral gemilerin fiyat avantajı, önizleme modellerinde açık modellerin fiyat avantajına dönüşüyor. Claude Opus 5.5 ayda 54 $ iken LongCat-2.5-Preview ayda 1,76 $'ya aynı bağlamı sunuyor. Bu bir fiyat savaşı değil, bir ekonomik sınıf değişimi.
Ama tek cümlelik bir uyarı: LongCat'in 0,30 $ fiyatı da "sınırlı süreli indirimli" olarak listeleniyor. Space Bunny Alpha karşılaştırmasında anlatıldığı gibi, bugünün fiyat listesi yarınınki değil.
Şeffaflık cephesi
Bu, LongCat'in en güçlü ve en zayıf olduğu yer.
Güçlü: LongCat'i bir şirket, yani hukuki olarak tanımlanabilir bir muhatap. Model kartı var, lisans açık (MIT), teknik blog var, GitHub deposu var. 1,8 trilyon parametrelik modelin mimarisi seyrek dikkat ve N-gram gömme olarak açıklanmış. LongCat-2.0'ın kuantize sürümleri indirilebilir.
Zayıf: LongCat-2.5-Preview için ağırlıklar yayımlanmamış. Yani "LongCat açık kaynaklıdır" ifadesi sürüm belirtmeden doğru değil. Bugünün gerçeği, önizleme sürümüne yalnızca API üzerinden erişilebilmesi.
Karşı tarafta Space Bunny Alpha'nın durumu tam tersi: fiyat sıfır, bağlam bir milyon, video girdisi var, ama ne şirket ne lisans ne ağırlık ne de bilgi kesim tarihi var.
Yani iki uç, aynı eksende:
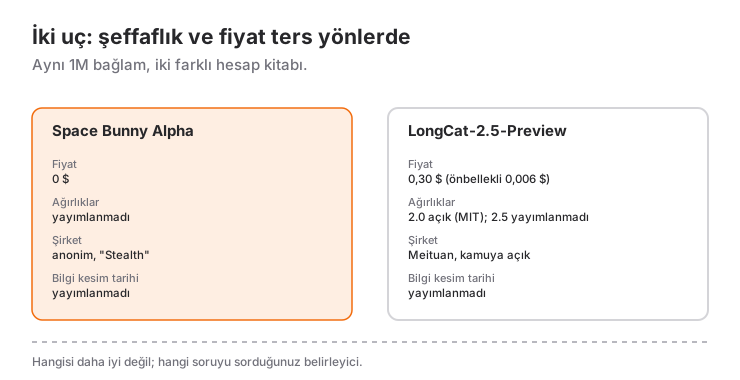
| Şeffaflık | Fiyat | Bağlam | Görsel/video | |
|---|---|---|---|---|
| Space Bunny Alpha | yok | 0 $ | 1M | metin, görsel, video |
| LongCat-2.5-Preview | sınırlı (ağırlıklar yok) | 0,30 $ | 1M | metin, görsel |
Bu, "hangisi daha iyi" sorusunun neden model adıyla değil, sorduğunuz soruyla ilgili olduğunu gösteriyor. JEV yazısında anlatılan ayrım burada da geçerli: model, metin girip metin çıkaran bir fonksiyondur; onu ne için kullanacağınıza karar vermek sizin işiniz.
Bu haberden ne çıkar
Üç cümleyle:
Bir. Uzun bağlam birinci sınıf özelliğini yitirdi. Altı rakip modelin altısında da bir milyon token var. Artık soru "kaç token" değil, "o token'ları hangi mekanizmayla seçiyorsun."
İki. Düşünme kademesi, yeni bir fiyat kalemi haline geldi. reasoning_effort ya da thinking yazmadan uzun bir ajan döngüsü kurmak, faturalandırmayı göz kararı yapmak demek.
Üç. Açık ağırlıklı modeller, bağlam ve multimodal yeteneklerde kapalı rakiplerle aynı sınıfa geldi; farkı fiyatta ve entegrasyon genişliğinde. LongCat'in en somut kazanımı bu: on iki araca resmî rehber yayımlamak, modelin teknik özelliklerinden daha çok işe yarıyor.
Kaynaklar
- Hugging Face: meituan-longcat/LongCat-2.0 model kartı (benchmark tablosu ve yıldız işareti açıklaması, seyrek dikkat, N-gram gömme, MIT lisansı)
- LongCat fiyatlandırma: LongCat-2.5-Preview (önbellekli girdi 0,006 $, önbelleksiz 0,30 $, çıktı 1,20 $)
- LongCat API dokümantasyonu: Retrieve Model (bağlam uzunluğu, desteklenen parametreler,
thinking) - Vercel AI Gateway: LongCat 2.5 Preview (azami çıktı, model kimliği, multimodal tanım)
- OpenRouter model API'si (rakip modellerin bağlam, fiyat, girdi biçimi ve akıl yürütme kademeleri)
- LongCat araç rehberleri (Claude Code, Codex, opencode, Cline ve diğer entegrasyonlar)
İlgili Yazılar
LongCat 2.5 Preview Nasıl Kurulur? Haber ve Rehber
Meituan'ın LongCat-2.5-Preview modeli çıktı: 1M bağlam, görsel girdi, isteğe bağlı düşünme modu ve önbellekte 0,006 $ fiyat. Kurulum rehberi.
Space Bunny Alpha Nasıl Kurulur? Adım Adım Rehber
Space Bunny Alpha'yı OpenRouter üzerinden kurma: API anahtarı, ilk istek, Python ve TypeScript örnekleri, görsel girdi ve açık kaynak ajanlara bağlama.
Space Bunny Alpha ile Yapay Zekâ Ajanı Kurmak
Araç şemasından döngüye: Space Bunny Alpha ile çalışan bir kodlama ajanı yazmak, araç hatalarını modele geri beslemek ve çıktıyı JSON'a kilitlemek.